Claude Fable 5.1 cuesta $10 y $50 por millón de tokens. Claude Opus 5 cuesta $5 y $25. La propia documentación de Anthropic indica que se debe empezar con Opus 5 y pasar a Fable 5.1 solo “cuando tus evaluaciones en Claude Opus 5 con mayor esfuerzo aún no sean suficientes”. Esa es una regla comprobable, y esta comparación se basa en ella: dónde los números de Anthropic muestran que Fable 5.1 supera claramente a Opus 5, dónde muestran algunos puntos que el ajuste de prompts podría cerrar, y dónde las matemáticas de precios se vuelven interesantes porque las lecturas de caché de Fable 5.1 son la mitad que las de Opus 5.
Las fuentes son la publicación de lanzamiento de Anthropic, la página del modelo Fable 5.1 y la página de precios. Para una visión general de cada modelo, consulte qué es Claude Fable 5.1 y qué es Claude Opus 5.
Comparación
| Claude Fable 5.1 | Claude Opus 5 | |
|---|---|---|
| ID del Modelo | claude-fable-5-1 |
claude-opus-5 |
| Lanzado | 1 de septiembre de 2026 | 24 de julio de 2026 |
| Posicionamiento | Razonamiento exigente y trabajo agéntico a largo plazo | Codificación agéntica compleja y trabajo empresarial; el predeterminado recomendado |
| Entrada / salida | $10 / $50 | $5 / $25 |
| Lectura de caché | $0.25 | $0.50 |
| Escritura de caché (5 min / 1 h) | $12.50 / $20 | $6.25 / $10 |
| Lote | $5 / $25 | $2.50 / $12.50 |
| Modo rápido | No | Sí ($10 / $50) |
| Nivel de prioridad | No | No |
| Contexto / salida máxima | 1M / 128K | 1M / 128K (300K en Lote con beta) |
| Fecha límite de conocimiento | Junio de 2026 | Mayo de 2026 |
| Latencia comparativa | Más lento | Moderado |
| Pensamiento | Siempre activado; disabled devuelve 400 |
Activado por defecto; disabled permitido en high o inferior |
tool_choice forzado |
400 | Aceptado |
| Clasificadores de seguridad | cibernético, biológico, LLM de frontera, extracción de razonamiento, daños generales | solo cibernético |
| Retención de datos cero | No disponible a menos que sea autorizado | Disponible |
| Esfuerzo por mensaje (beta) | Sí | Sí |
| Comprobación de edición de historial | Sí | No |
Lo que dicen los benchmarks
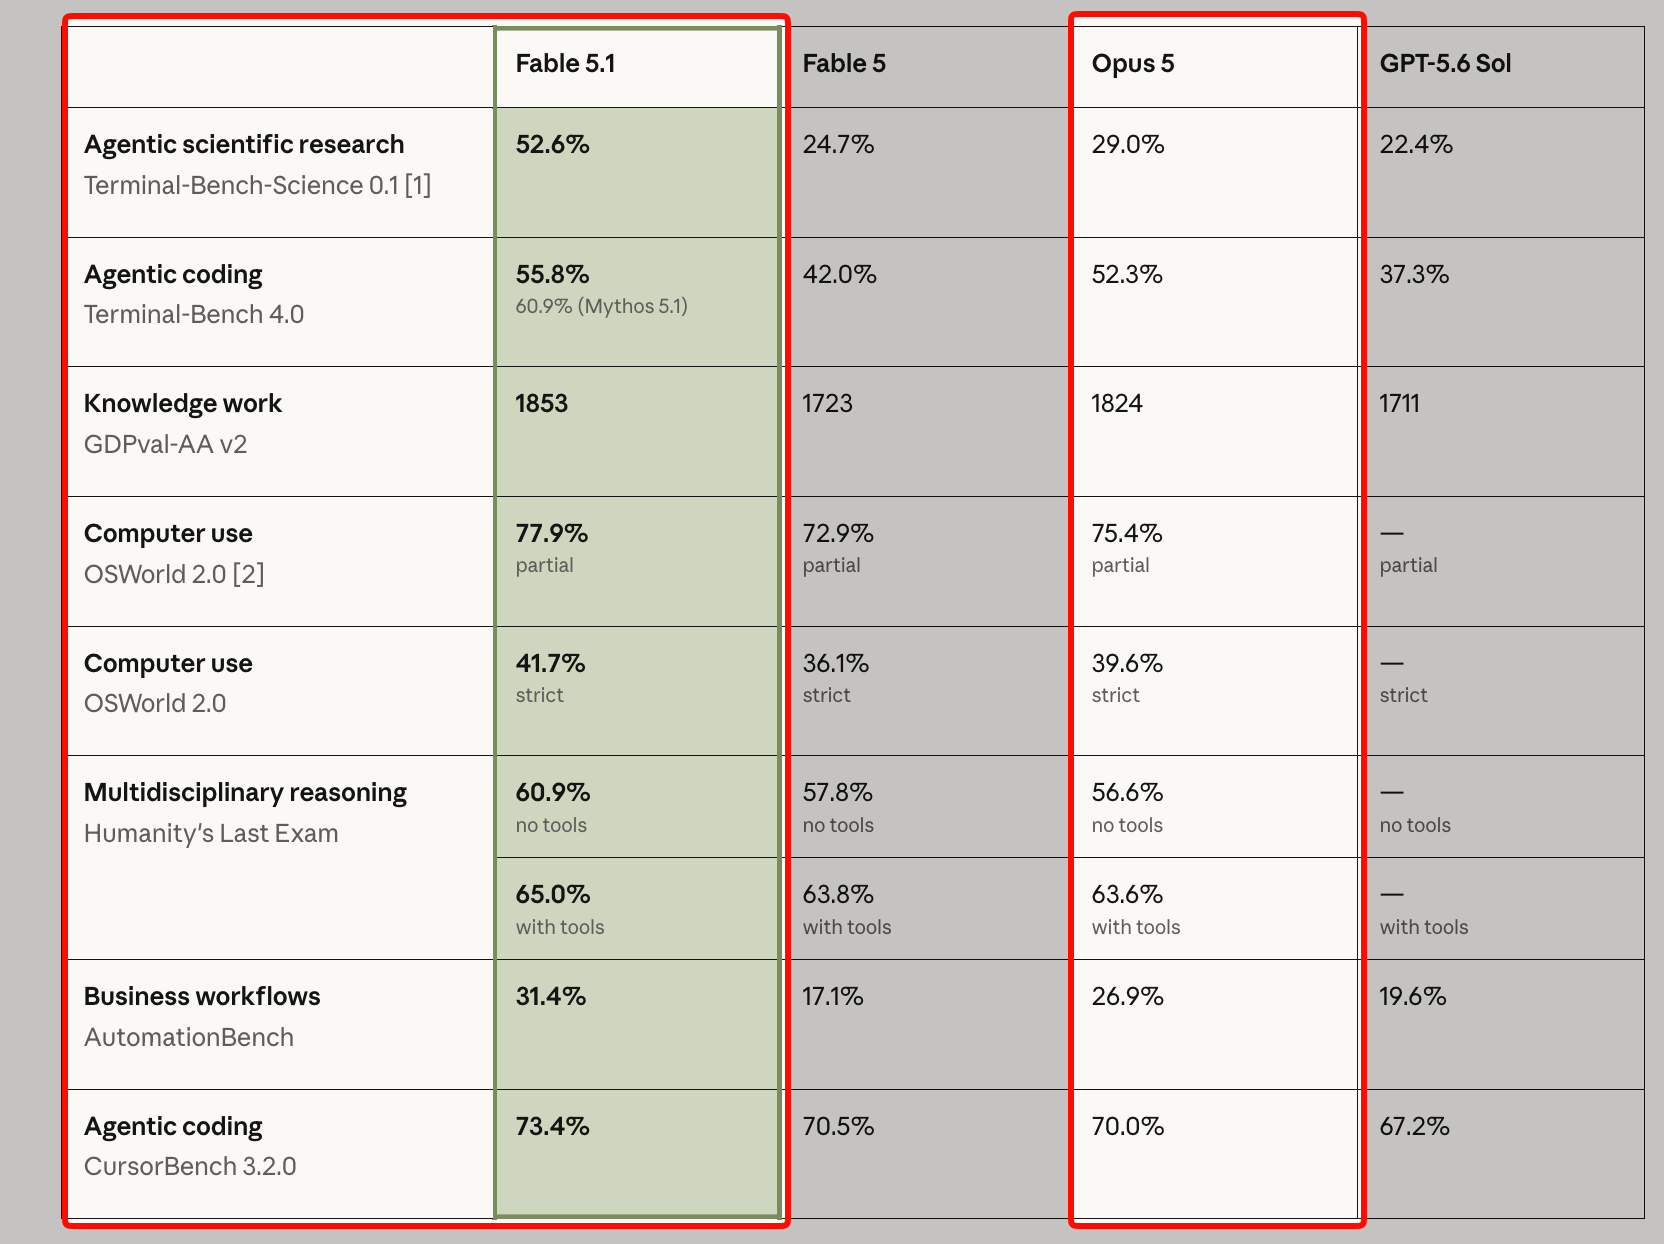
Todos los números son de Anthropic, ejecutados por Anthropic, sin reproducción independiente aún.
| Benchmark | Fable 5.1 | Opus 5 | Diferencia |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 29.0% | +23.6 |
| AutomationBench | 31.4% | 26.9% | +4.5 |
| Último Examen de la Humanidad (sin herramientas) | 60.9% | 56.6% | +4.3 |
| Terminal-Bench 4.0 | 55.8% | 52.3% | +3.5 |
| CursorBench 3.2.0 | 73.4% | 70.0% | +3.4 |
| OSWorld 2.0 (parcial) | 77.9% | 75.4% | +2.5 |
| OSWorld 2.0 (estricto) | 41.7% | 39.6% | +2.1 |
| Último Examen de la Humanidad (con herramientas) | 65.0% | 63.6% | +1.4 |
| GDPval-AA v2 | 1853 | 1824 | +29 Elo |
Lea esa tabla como dos historias. En Terminal-Bench-Science, Fable 5.1 casi duplica a Opus 5, y ese es un benchmark de investigación a largo plazo y con muchas herramientas donde el modelo ejecuta experimentos en una terminal durante mucho tiempo. En todo lo demás, la diferencia está entre uno y cinco puntos. Una diferencia de cinco puntos en AutomationBench es significativa. Una diferencia de 1.4 puntos en el Último Examen de la Humanidad con herramientas, o 29 Elo en GDPval, está dentro del rango donde su prompt y su configuración de esfuerzo mueven el resultado más que la elección del modelo.
El otro dato a tener en cuenta: Opus 5 se lanzó en julio con un 52.3% en Terminal-Bench 4.0, por delante del 42.0% de Fable 5. Fable 5.1 recuperó el liderazgo con un 55.8%, pero por 3.5 puntos, no 13.8. La ventaja del nivel Fable sobre el nivel Opus en la codificación agéntica es real y más estrecha de lo que era en junio. La comparación entre Opus 5 y Fable 5 capturó el estado anterior de esa carrera.
Las matemáticas de precios no son simplemente 2x
Sin caché, Fable 5.1 es exactamente el doble de Opus 5 en cada línea. Pero las lecturas de caché se invierten: $0.25 en Fable 5.1 frente a $0.50 en Opus 5. Por lo tanto, el multiplicador efectivo depende de cuánto de su entrada sea un prefijo en caché.
Considere un turno agéntico con 150,000 tokens en caché, 1,000 tokens de entrada sin caché y 800 tokens de salida. Opus 5: 5(0.001) + 0.5(0.15) + 25(0.0008) = $0.005 + $0.075 + $0.02 = $0.10. Fable 5.1: 10(0.001) + 0.25(0.15) + 50(0.0008) = $0.01 + $0.0375 + $0.04 = $0.0875. En ese turno, Fable 5.1 es más barato.
Ahora considere una revisión de código con 30,000 tokens de entrada sin caché y 4,000 tokens de salida. Opus 5: $0.15 + $0.10 = $0.25. Fable 5.1: $0.30 + $0.20 = $0.50. Exactamente el doble.
El punto de inflexión: el costo por turno de Fable 5.1 cae por debajo del de Opus 5 cuando los tokens de entrada en caché exceden aproximadamente 20 veces la suma de los tokens de entrada sin caché y 5 veces los tokens de salida. Para bucles de agentes con gran cantidad de prefijos, esa condición es común. Para cualquier cosa con gran cantidad de salida, nunca sucede. Las escrituras de caché también son el doble en Fable 5.1, por lo que una sesión que reinicia su caché a menudo pierde la ventaja. El desglose de precios de Fable 5.1 y el desglose de precios de Opus 5 tienen las tablas completas.
Dónde Opus 5 gana de forma rotunda
- Cualquier cosa que puedas ejecutar con el pensamiento desactivado. Opus 5 acepta
thinking: {"type": "disabled"}con un esfuerzohigho inferior. Fable 5.1 nunca lo hace. Para clasificación, extracción y rutas de respuesta corta, Opus 5 con el pensamiento desactivado (o con un esfuerzolow) es más barato y más rápido. - Modo rápido. Opus 5 tiene un modo rápido de vista previa de investigación con una velocidad de salida de hasta 2.5x por $10 y $50. Fable 5.1 no tiene un equivalente. Si el tiempo de respuesta importa más que los últimos puntos de referencia, esto es decisivo.
- Latencia en general. Anthropic clasifica a Fable 5.1 como "más lento" y a Opus 5 como "moderado". Los turnos individuales de Fable 5.1 en tareas difíciles con alto esfuerzo pueden durar muchos minutos.
- Retención de datos cero. Opus 5 está disponible bajo ZDR. Fable 5.1 es un Modelo Cubierto y devuelve un 400 a menos que Anthropic autorice expresamente el acceso a ZDR.
- Menos rechazos. Opus 5 ejecuta clasificadores solo de ciberseguridad. Fable 5.1 ejecuta el conjunto completo de Fable: cibernético, biológico, desarrollo de LLM de frontera, extracción de razonamiento y daños generales. Una carga de trabajo benigna de ciencias de la vida o ML que nunca activa Opus 5 puede activar Fable 5.1, y cuando lo hace, el objetivo de reserva es de todos modos Opus 5.
- Uso forzado de herramientas. Opus 5 aún acepta
tool_choiceanyytool. Fable 5.1 devuelve un 400. Si su integración se basa en llamadas forzadas, Opus 5 le ahorra la reescritura. - Sin verificación de edición de historial. A Opus 5 no le importa si editas turnos anteriores. Fable 5.1 invalida bloques de pensamiento posteriores cuando lo haces. Un sistema que compacta del lado del cliente o inyecta recordatorios por turno funciona en Opus 5 hoy y necesita una auditoría antes de Fable 5.1.
Dónde Fable 5.1 gana de forma rotunda
- Investigación a largo plazo y agentes de terminal. El resultado de 52.6% frente a 29.0% en Terminal-Bench-Science es la mayor diferencia individual en la tabla de Anthropic. Si sus agentes ejecutan experimentos, persiguen investigación web de varios pasos u operan durante horas, esta es la carga de trabajo para la que se construyó el modelo.
- Automatización de flujos de trabajo empresariales. El 31.4% frente al 26.9% en AutomationBench es una diferencia real en un benchmark que modela tareas de extremo a extremo en diversas aplicaciones.
- Agentes con gran cantidad de prefijos en caché. Cubierto anteriormente: la lectura de caché de $0.25 hace que Fable 5.1 sea más barato por turno en bucles dominados por prefijos.
- Fecha límite de conocimiento. Junio de 2026 frente a Mayo de 2026. Un mes, pero es el más reciente de cualquier modelo Claude.
- Visión en documentos densos. Anthropic menciona la mejora en la lectura de gráficos, documentos y tablas anidadas en PDFs, especialmente con herramientas de recorte y zoom, como un área de mejora de Fable 5.1. Opus 5 no se compara en un benchmark de visión publicado, así que trate esto como una afirmación a probar.
- Cuando Opus 5 en
xhighfalla. Esta es la regla de Anthropic, y es la correcta. Si una tarea falla su evaluación en Opus 5 enxhigh, intente Fable 5.1 enhighantes de probar cualquier otra cosa.
El esfuerzo cambia la comparación
Ambos modelos exponen cinco niveles de esfuerzo, y Anthropic hace una afirmación específica sobre Fable 5.1 en el extremo inferior: con un esfuerzo low, es “a menudo competitivo con los modelos Claude Opus y Claude Sonnet en costo por tarea mientras obtiene puntuaciones más altas”. Esto replantea la elección. En lugar de Opus 5 en high frente a Fable 5.1 en high, la comparación justa para el trabajo rutinario podría ser Opus 5 en high frente a Fable 5.1 en low o medium. El recuento de tokens de salida con menor esfuerzo es más pequeño, lo que compensa el precio 2x por token.
Lo contrario también es cierto. Las ganancias de Fable 5.1 sobre Fable 5 son mayores en xhigh y max, lo que significa que el techo de capacidad por encima de Opus 5 es más alto en los niveles de esfuerzo que también consumen más tiempo. Evalúe ambos modelos en todos los niveles de esfuerzo en sus propias pruebas antes de sacar conclusiones de las tablas de lanzamiento. La guía de esfuerzo de Opus 5 cubre los cinco niveles; la semántica es la misma en Fable 5.1.
Un marco de decisión
- Comience con Opus 5 en
high. La recomendación predeterminada de Anthropic, la mitad del precio, menos clasificadores, ZDR disponible. - Eleve Opus 5 a
xhighen las tareas que fallan. Más barato que cambiar de modelo. - Mueva las tareas que aún fallan a Fable 5.1 en
high. Por ruta, no globalmente. Mantenga Opus 5 en todo lo que pase. - Verifique el perfil de caché de lo que movió. Si es un bucle con muchos prefijos, Fable 5.1 podría resultar más barato por turno que Opus 5.
- Audite el sistema antes del paso 3. Tanto el
tool_choiceforzado como las ediciones del historial fallan en Fable 5.1. La guía de migración tiene la lista de verificación.
Ejecutando la comparación en Apidog
Cree una colección con sus prompts de producción y model como variable de entorno. Ejecútela contra claude-opus-5 en high, de nuevo en xhigh, luego contra claude-fable-5-1 en high y low. Para cada ejecución, registre la respuesta, usage.output_tokens y usage.cache_read_input_tokens en un envío repetido. Multiplique por las tarifas de cada modelo en un script post-respuesta y tendrá el costo por tarea por modelo por esfuerzo en una tabla. Apidog guarda cada ejecución como historial, por lo que la comparación sobrevive al próximo lanzamiento del modelo. Descargue Apidog para configurarlo.
Preguntas Frecuentes
- ¿Es Claude Fable 5.1 mejor que Opus 5? En todos los benchmarks publicados por Anthropic, sí, por márgenes de 1.4 a 23.6 puntos. La mayor diferencia se observa en Terminal-Bench-Science; la mayoría de los demás están por debajo de cinco puntos. Estos son resultados ejecutados por el proveedor.
- ¿Vale Fable 5.1 el doble del precio de Opus 5? Para investigación a largo plazo y agentes de terminal, automatización de negocios y bucles de agentes con muchos prefijos (donde las lecturas de caché más baratas pueden hacer que cueste menos por turno), a menudo sí. Para trabajos con mucha salida, sensibles a la latencia o de clasificación, no. La propia regla de Anthropic: solo avance cuando Opus 5 con mayor esfuerzo falle sus evaluaciones.
- ¿Cuál es más rápido, Fable 5.1 o Opus 5? Opus 5. Anthropic lo clasifica como "latencia moderada" frente a "más lento" para Fable 5.1, y Opus 5 tiene un modo rápido con una velocidad de salida de hasta 2.5x. Fable 5.1 no tiene ninguno.
- ¿Tiene Opus 5 los mismos clasificadores de seguridad que Fable 5.1? No. Opus 5 ejecuta clasificadores solo cibernéticos. Fable 5.1 añade biológicos, LLM de frontera, extracción de razonamiento y daños generales. Cuando Fable 5.1 se niega, Opus 5 es uno de los dos objetivos de respaldo permitidos.
- ¿Puedo usar Fable 5.1 bajo retención de datos cero como Opus 5? No. Fable 5.1 requiere una retención de 30 días y es un Modelo Cubierto. Opus 5 está disponible bajo ZDR.
- ¿Puede una conversación moverse entre Opus 5 y Fable 5.1? Hacia arriba, sí: Fable 5.1 lee los bloques de pensamiento de Opus 5. Hacia abajo, la API elimina los bloques de pensamiento de Fable 5.1 antes de que Opus 5 los vea, sin facturar, y Opus 5 vuelve a planificar ese turno.