
Cerebras vende un solo número: velocidad. La propuesta es que sus chips de escala de oblea expulsan tokens más rápido de lo que jamás podría hacerlo un clúster de GPU, y el nivel gratuito es la forma en que la empresa hace que te fijes en ello. Pero “rápido” no es algo que debas aceptar por la palabra de un proveedor. Es algo que mides, en tu propia conexión, con tu propio prompt, y luego guardas como un registro que puedes volver a ejecutar cada vez que Cerebras lanza un nuevo modelo o cambia un límite.
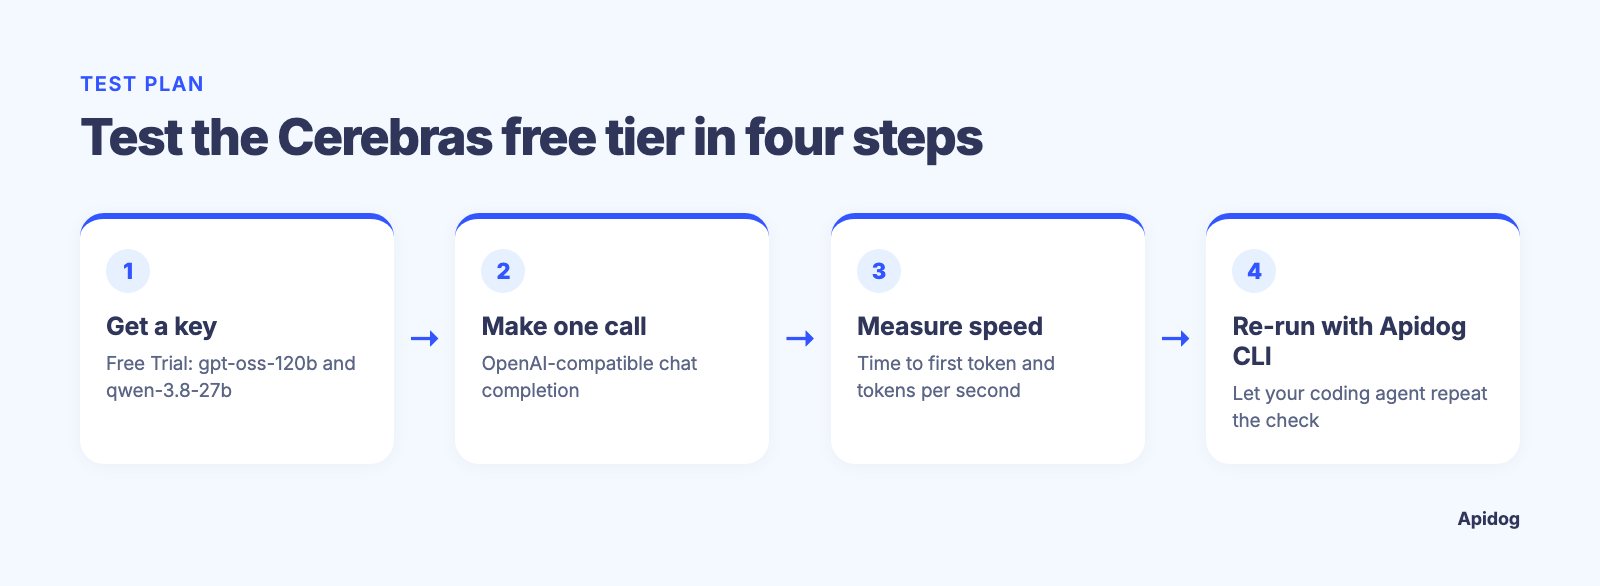
Esta guía hace esa medición contigo. Obtendrás una clave de API de Cerebras, harás una llamada real de finalización de chat contra el endpoint compatible con OpenAI, medirás el tiempo hasta el primer token y la respuesta completa, y harás que tu agente de programación convierta toda la solicitud en una prueba de Apidog CLI para que sobreviva al próximo cambio de modelo.
Resumen
Cerebras da a las cuentas nuevas un nivel Free Trial: $5 en créditos que caducan 30 días después de otorgarse, limitados a dos modelos (gpt-oss-120b y qwen-3.8-27b) a 5 solicitudes por minuto y 30K tokens sin caché por minuto cada uno, según los límites de velocidad publicados por Cerebras. La API es compatible con OpenAI en https://api.cerebras.ai/v1, así que puedes apuntar un cliente de OpenAI existente a ella y cambiar tres líneas. A continuación, crearás una solicitud que mide el tiempo hasta el primer token y los tokens por segundo tú mismo, en lugar de confiar en una página de marketing.
Qué documenta el nivel gratuito y qué no
La página de precios de Cerebras renderiza sus números del lado del cliente, lo que significa que la tarifa exacta de dólares por millón de tokens para el uso de pago no es algo que puedas obtener de una consulta estática de la página. No adivines esa cifra. Cuando la necesites, abre tú mismo la pestaña de facturación de la consola de Cerebras Cloud, porque ese es el único lugar donde la tarifa actual está garantizada como precisa.
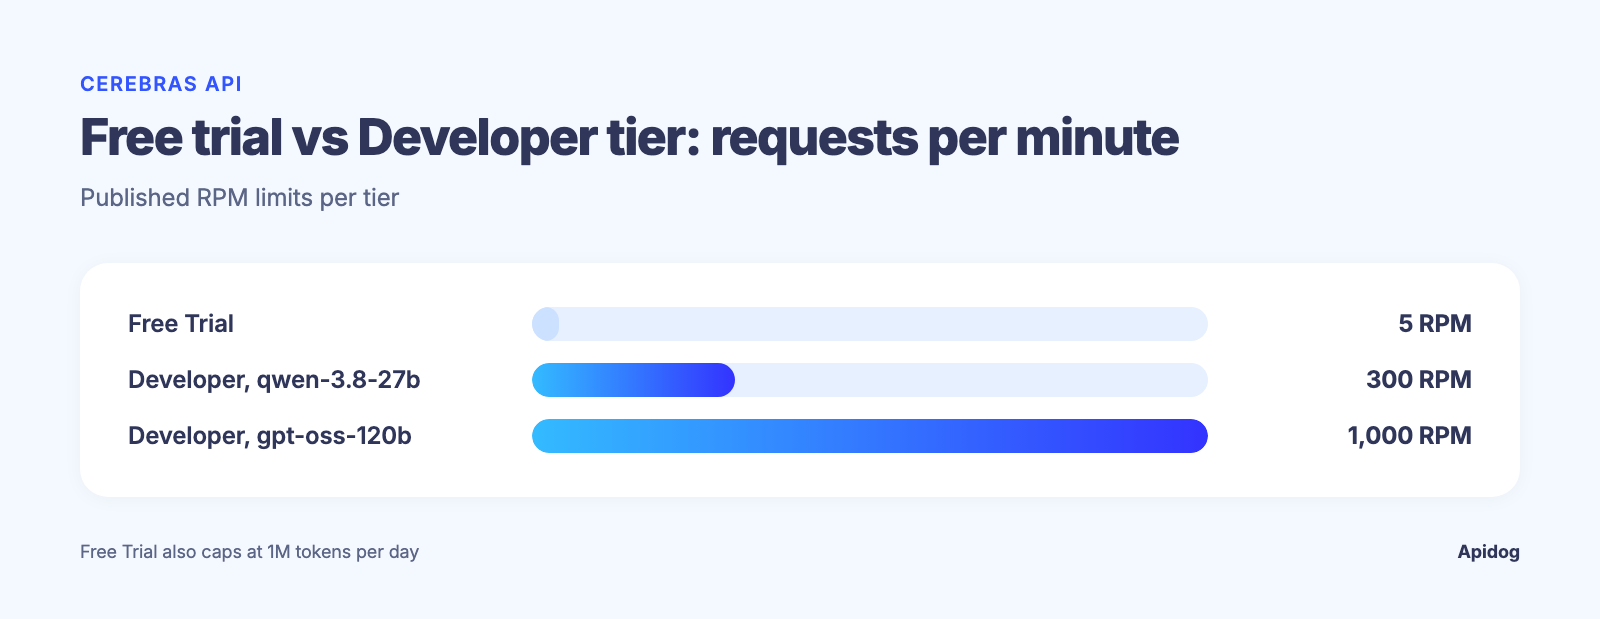
Lo que los documentos sí indican claramente, en la página de límites de velocidad de soporte, es la forma del nivel Free Trial:
| Nivel | Modelos | RPM | TPM sin caché | TPM total | TPH | TPD |
|---|---|---|---|---|---|---|
| Free Trial | gpt-oss-120b, qwen-3.8-27b |
5 | 30K | 90K | 1M | 1M |
Developer (gpt-oss-120b) |
pago por uso | 1,000 | 1M | 3M | none | none |
Developer (qwen-3.8-27b) |
pago por uso | 300 | 150K | 450K | none | none |
Aquí importan dos cosas. Primero, “TPM sin caché” es el techo real: son tokens que necesitan cómputo completo, y tu asignación total de TPM es aproximadamente tres veces eso una vez contadas las visitas de caché. Segundo, la cuenta Free Trial está limitada por crédito y tiempo, no por solicitudes para siempre: una vez que se agotan los $5 o pasan 30 días, bajas a lo que permita el nivel de tu cuenta hasta que añadas un método de pago. Todo lo que está más allá de esta tabla (precio por token, precio por asiento, términos empresariales) vive detrás de la página de precios renderizada con JavaScript y la consola, no en los documentos estáticos, así que revísalo allí antes de presupuestar con base en ello.
Si te has topado con un muro como este en otro proveedor, el patrón es el mismo que cubrimos en nuestra guía sobre qué hacer cuando recibes una respuesta 429 de límite de velocidad excedido: lee el cuerpo del error, retrocede y revisa el panel antes de asumir que la API está rota.
Obtén una clave y haz una llamada real
Regístrate en cloud.cerebras.ai, abre API Keys y genera una. El inicio rápido de Cerebras te dice que la establezcas como una variable de entorno para que nunca acabe manualmente en el cuerpo de una solicitud:
export CEREBRAS_API_KEY="your-key-here"
La URL base es https://api.cerebras.ai/v1, y el endpoint de finalizaciones de chat coincide directamente con la forma de OpenAI: POST /v1/chat/completions con un model y un array messages. Esa compatibilidad está documentada en la referencia de la API, y es la razón por la que puedes insertar Cerebras en código escrito para la biblioteca cliente de OpenAI cambiando la URL base y la clave. Una llamada curl sin procesar se ve así:
curl https://api.cerebras.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${CEREBRAS_API_KEY}" \
  -d '{
    "model": "qwen-3.8-27b",
    "messages": [
      {"role": "user", "content": "Explain time-to-first-token in two sentences."}
    ]
  }'
Ejecútala, y la respuesta trae más que el texto de finalización. Incluye un bloque usage (prompt_tokens, completion_tokens, total_tokens) y un bloque time_info (queue_time, total_time) que Cerebras devuelve en cada llamada.
Si tu equipo está probando más de un modelo o proveedor, este es un buen momento para dejar de depender de comandos curl puntuales. La sección de Apidog CLI a continuación hace que tu agente de programación convierta esta llamada en una prueba que vuelve a ejecutar cada vez que Cerebras añade un modelo o cambia un límite.
Mide la afirmación de velocidad: tiempo hasta el primer token y tokens por segundo
Dos números te dicen si “rápido” es real para tu carga de trabajo: el tiempo hasta el primer token (TTFT) y los tokens generados por segundo. Ninguno aparece como métrica destacada en la respuesta de la API, así que los calculas a partir de lo que te da la llamada.
Para el TTFT, transmite la respuesta y registra el intervalo de tiempo real entre enviar la solicitud y recibir el primer fragmento:
import time
from cerebras.cloud.sdk import Cerebras

client = Cerebras()
start = time.perf_counter()
first_token_at = None

stream = client.chat.completions.create(
    model="qwen-3.8-27b",
    messages=[{"role": "user", "content": "Write a haiku about wafer-scale chips."}],
    stream=True,
)

for chunk in stream:
    if first_token_at is None and chunk.choices[0].delta.content:
        first_token_at = time.perf_counter() - start
        print(f"Time to first token: {first_token_at:.3f}s")
Para los tokens por segundo, usa una llamada sin transmisión y divide los tokens de finalización entre el total_time que Cerebras informa en time_info:
response = client.chat.completions.create(
    model="qwen-3.8-27b",
    messages=[{"role": "user", "content": "Explain the CS-3 wafer-scale engine in 100 words."}],
)

tokens = response.usage.completion_tokens
seconds = response.time_info.total_time
print(f"{tokens / seconds:.1f} tokens/sec")
Ejecuta esto unas cuantas veces, a distintas horas, con un prompt cercano a lo que envía tu producto. Conserva ambos scripts y vuelve a ejecutarlos cada vez que Cerebras añada un modelo al nivel gratuito, porque la cifra de tokens por segundo cambia según el modelo, no solo según el proveedor.
Lee los límites antes de que ellos te lean
El diseño de límites de velocidad de Cerebras tiene una sutileza que conviene conocer antes de programar nada: rastrea dos cubos de tokens separados por organización, TPM sin caché y TPM total, y aplica ambos a la vez. Una ráfaga de prompts cortos y repetitivos puede alcanzar el techo de solicitudes por minuto antes de acercarse al techo de tokens, exactamente la trampa descrita en nuestro artículo más amplio sobre cómo funciona la limitación de velocidad de API.
Una laguna honesta en la documentación: Cerebras no publica un conjunto de encabezados de respuesta x-ratelimit-* como hacen algunos proveedores. La referencia de la API no lista ninguno, y la página de límites de velocidad tampoco. Eso es distinto de la propia API de finalizaciones de chat de OpenAI, que sí devuelve encabezados de cuota restante en cada llamada, un patrón que nuestra guía de límites de velocidad de OpenAI cubre con más detalle. Con Cerebras, los dos lugares donde revisar tu estado real son la sección Limits de la consola de Cloud y el cuerpo de una respuesta 429, que indica si excediste el techo de tokens sin caché o el total. Construye tu lógica de reintento en torno a ese cuerpo de error en lugar de asumir que un encabezado te lo dirá primero.
Haz que tu agente de programación lo vuelva a ejecutar con Apidog CLI
Una medición en un archivo temporal no prueba nada el mes que viene. Haz que tu agente de programación convierta la llamada en una prueba que pueda volver a ejecutar mediante Apidog CLI. Configúralo una vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
El token viene de Apidog en Account Settings, API Access Token. Luego dale al agente un prompt:
Use Apidog CLI on project <id>. Create a Cerebras environment with base URL
https://api.cerebras.ai/v1 and add POST /chat/completions with Bearer auth from
{{CEREBRAS_API_KEY}} and model set to {{MODEL}}. Create a test case asserting
status 200 and time_info.total_time under {{MAX_TOTAL_TIME}}, run it for
gpt-oss-120b and qwen-3.8-27b, and report completion tokens per second for each.
Los comandos que ejecuta, verificados con Apidog CLI 2.2.7:
apidog environment create Cerebras --project <id> --base-url https://api.cerebras.ai/v1
apidog endpoint create --project <id> --file cerebras-chat.json
apidog cli-schema validate test-case-create --file speed-case.json
apidog test-case create --project <id> --file speed-case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d models.csv \
  --delay-request 12000 --env-var "CEREBRAS_API_KEY=$CEREBRAS_API_KEY" -r cli,json
models.csv contiene una columna MODEL, así que una sola ejecución cubre ambos modelos, y lo que Cerebras lance después es una fila más. --delay-request 12000 espacia las llamadas 12 segundos para mantenerse por debajo de las 5 solicitudes por minuto del Free Trial. Para la ruta 429, pide un segundo caso que deliberadamente haga una ráfaga que supere ese límite y valide contra el cuerpo del error, para que quede capturado y versionado en lugar de redescubrirse en producción. Eso es un flujo de trabajo, no un benchmark puntual; consulta nuestra recopilación de herramientas de prueba de API creadas para cargas de trabajo de agentes y LLM si estás comparando opciones, y Apidog CLI en Claude Code para el lado del agente.
Free Trial o Developer: cuándo cambiar
El nivel Free Trial está diseñado exactamente para lo que recorre esta guía: confirmar la afirmación de velocidad y la forma de la solicitud antes de comprometer una tarjeta. Una vez que estés construyendo sobre Cerebras de verdad, el salto del nivel Developer, de 5 RPM a 1,000 RPM en gpt-oss-120b, es el número que suele forzar la decisión, no el precio por token. Si tu volumen de prompts es a ráfagas en lugar de constante, compara los números de Cerebras con las alternativas antes de comprometerte; nuestra lista de alternativas a OpenRouter y nuestro recorrido por el nivel gratuito de la API de Groq merecen leerse junto a la tabla anterior, ya que la velocidad de inferencia y los techos de los niveles gratuitos varían más entre proveedores de lo que admite la mayoría de las publicaciones comparativas. Una diferencia que conviene conocer antes de elegir: Groq documenta los límites del plan gratuito por modelo directamente, por ejemplo openai/gpt-oss-120b a 30 RPM, 1,000 RPD, 8K TPM y 200K TPD, y devuelve encabezados de respuesta x-ratelimit-* en cada llamada, así que siempre sabes tu presupuesto restante por la propia respuesta. Cerebras no te da ninguna de las dos cosas; lees tu estado en la consola de Cloud o lo infieres del cuerpo de un 429, como se explicó arriba.
Preguntas frecuentes
¿El nivel gratuito de Cerebras requiere una tarjeta de crédito? El nivel Free Trial se basa en créditos ($5, que caducan después de 30 días) en lugar de ser un plan gratuito recurrente, y los propios documentos de Cerebras te dirigen a la consola de Cloud para los requisitos de registro actuales, ya que ese detalle puede cambiar independientemente de la documentación estática.
¿Qué modelos están disponibles en el nivel gratuito? Según la documentación actual de límites de velocidad, dos: gpt-oss-120b y qwen-3.8-27b. Ambos comparten los mismos límites del Free Trial (5 RPM, 30K TPM sin caché).
¿Puedo usar mi código existente del SDK de OpenAI con Cerebras? Sí. Apunta la URL base del cliente a https://api.cerebras.ai/v1 e intercambia tu clave de Cerebras; la forma de /v1/chat/completions coincide, según la referencia de la API.
¿Por qué recibí un 429 aunque estoy por debajo de mi presupuesto de tokens? Cerebras aplica TPM sin caché, TPM total y RPM como techos separados. Una ráfaga de solicitudes pequeñas puede activar el límite de RPM mucho antes de que se llene cualquier cubo de tokens, que es el mismo modo de fallo cubierto en nuestra guía de solución de problemas de límite de velocidad excedido.
¿Cómo reviso mi uso actual sin chocar primero contra un muro? Cerebras no devuelve encabezados de respuesta de cuota restante, así que revisa la sección Limits en la consola de Cloud directamente en lugar de inferirlo de las respuestas de la API. El plan gratuito de Groq adopta el enfoque opuesto y devuelve encabezados x-ratelimit-* en cada llamada, así que sopesa esa diferencia si el monitoreo basado en encabezados importa para tu configuración.
La verdadera ventaja de Cerebras se muestra en el bloque time_info de tus propias llamadas, no en un titular de marketing.