
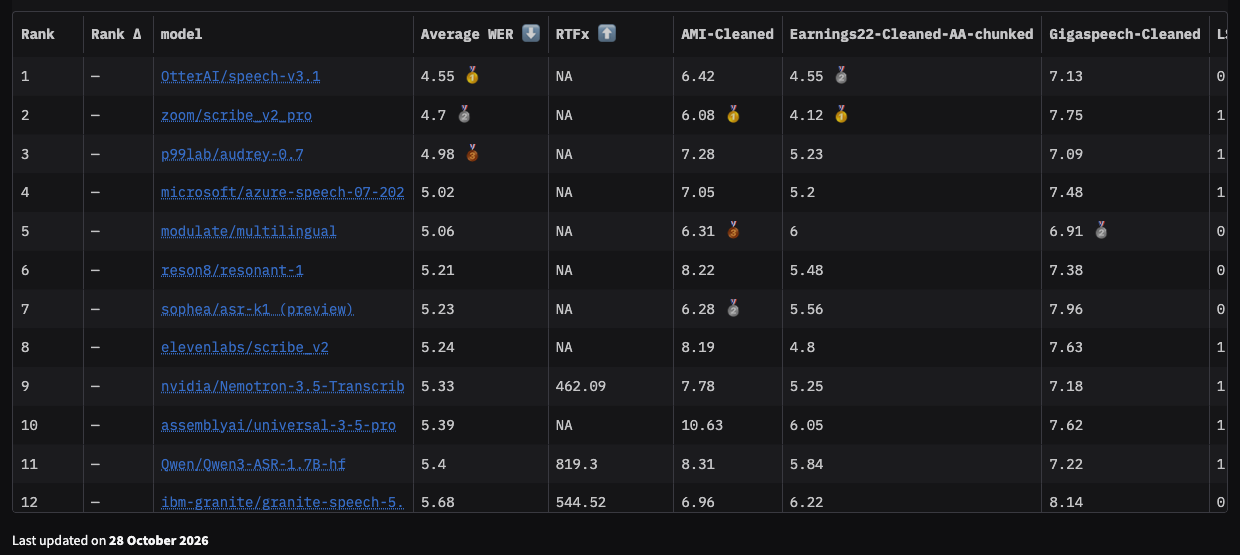
El mejor modelo de voz a texto de código abierto en octubre de 2026 es Nemotron 3.5 Transcribe de NVIDIA, publicado el 28 de octubre. En el Hugging Face Open ASR Leaderboard actualizado ese mismo día, promedia una tasa de error de palabras del 5.33% y ocupa el 9.º puesto de 61 modelos. Los ocho modelos por encima de él son API comerciales cerradas. whisper-large-v3 de OpenAI, que sigue siendo el predeterminado en muchos tutoriales, está en el puesto 41 con 7.16%.
A continuación se presentan los nueve modelos de reconocimiento de voz de pesos abiertos que vale la pena considerar ahora mismo, clasificados según esa tabla, con velocidad, fortalezas y la tarea para la que encaja cada uno. Cada cifra de WER y velocidad proviene de la tabla de clasificación tal como se consultó el 29 de octubre de 2026.
Si, en cambio, estás eligiendo entre API alojadas, lee nuestra guía de la API de Nemotron 3.5 Transcribe y la guía de la API de Whisper.
Cómo los clasificamos
El Open ASR Leaderboard ejecuta cada modelo en los mismos conjuntos de prueba en inglés: reuniones (AMI), llamadas de resultados (Earnings22), pódcast y YouTube (GigaSpeech), audiolibros (LibriSpeech), llamadas financieras (SPGISpeech), voz con ruido (URGENT24), audio conversacional (Voice Arena Monsoon), discursos parlamentarios (VoxPopuli) y dos conjuntos privados. La métrica de clasificación es el WER promedio, donde menos es mejor.
También incluimos RTFx, la medida de velocidad de la tabla: segundos de audio transcritos por segundo de cómputo. Más alto es más rápido. Las API cerradas muestran “NA” porque no se pueden cronometrar en el mismo hardware.
Consideramos que un modelo es de pesos abiertos cuando su checkpoint se puede descargar y la tabla de clasificación informa un RTFx para él. Revisa cada licencia antes del uso comercial.
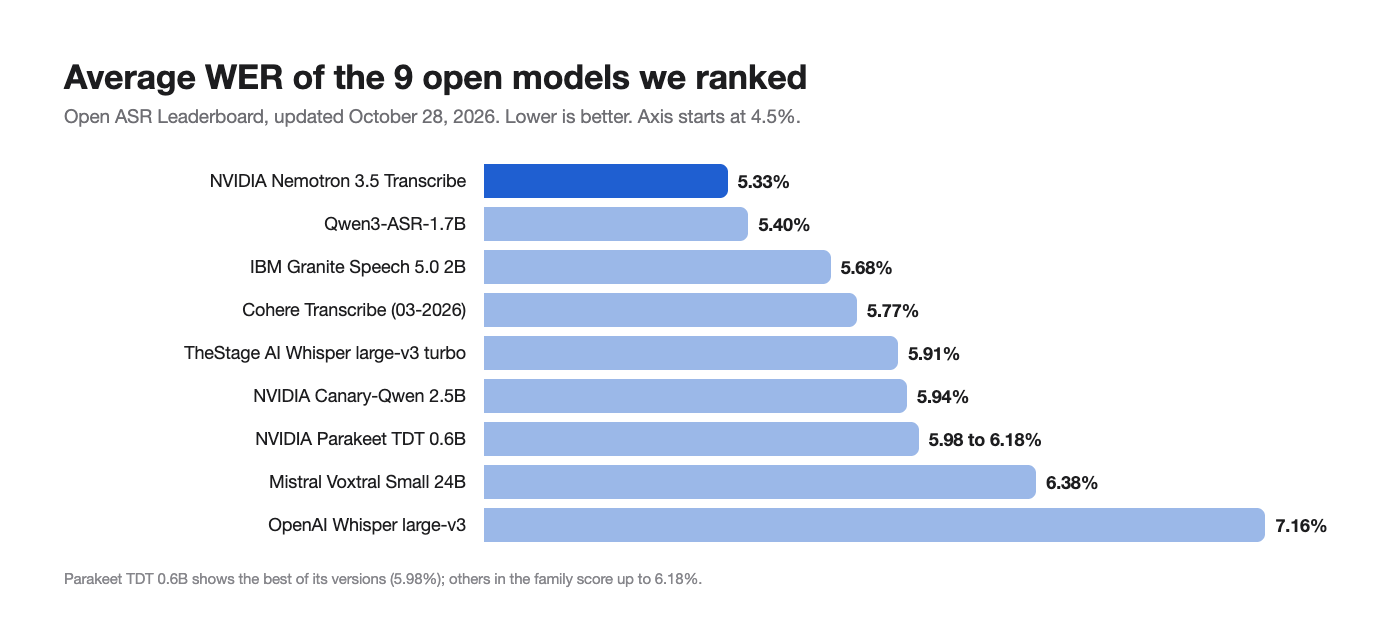
La clasificación de un vistazo
| Puesto (abiertos) | Modelo | WER prom. | RTFx | Puesto global |
|---|---|---|---|---|
| 1 | NVIDIA Nemotron 3.5 Transcribe 30B-A4B | 5.33% | 462 | 9 |
| 2 | Qwen3-ASR-1.7B | 5.40% | 819 | 11 |
| 3 | IBM Granite Speech 5.0 2B | 5.68% | 545 | 12 |
| 4 | Cohere Transcribe (03-2026) | 5.77% | 902 | 14 |
| 5 | TheStage AI Whisper large-v3 turbo | 5.91% | 1,177 | 17 |
| 6 | NVIDIA Canary-Qwen 2.5B | 5.94% | 862 | 21 |
| 7 | NVIDIA Parakeet TDT 0.6B (versiones) | 5.98% a 6.18% | no comparado | 24 a 31 |
| 8 | Mistral Voxtral Small 24B | 6.38% | no comparado | 35 |
| 9 | OpenAI Whisper large-v3 | 7.16% | no comparado | 41 |
Como contexto, las mejores API cerradas en la misma tabla: Otter speech-v3.1 con 4.55%, Zoom Scribe v2 Pro con 4.70%, ElevenLabs Scribe v2 con 5.24%, AssemblyAI Universal-3.5 Pro con 5.39% y OpenAI gpt-transcribe con 5.96%. Nemotron 3.5 Transcribe supera a AssemblyAI y al modelo alojado de OpenAI, además de ser gratuito para descargar.
1. NVIDIA Nemotron 3.5 Transcribe: el mejor en general
5.33% WER, RTFx 462, licencia OpenMDW-1.1
El nuevo modelo de NVIDIA no es una red ASR clásica. Es un modelo de lenguaje aumentado con voz: un codificador ASR de 600 M de parámetros y un codificador de hablante alimentan un LLM híbrido de mezcla de expertos Mamba-2 y Transformer con 34B en total y alrededor de 4.3B de parámetros activos. Ese diseño es la razón por la que hace más que transcribir.
Por qué ocupa el primer puesto:
- 40 idiomas, con 13 calificados como “líderes”
- Archivos de una hora en una sola pasada, con un contexto de 65,536 tokens
- Atribución de hablantes (hasta ocho hablantes) y marcas de tiempo por palabra desde un solo modelo
- Prompts: redacción literal o limpia, términos de contexto para jerga, traducción
- Precisión en formato largo: 10.98% de WER medio en los conjuntos de formato largo de la tabla, frente a 13.37% de Parakeet-TDT-0.6B-v3, según la tarjeta del modelo
- Reuniones: 15.80% de cpWER medio en conjuntos con varios hablantes, por delante de la canalización DiCoW más DiariZen con 16.83%
Compensaciones: necesita una GPU grande (una H100 de 80 GB en BF16, o una RTX 5090 con pesos NVFP4), no transmite en streaming y las preguntas y respuestas de audio son solo en inglés.
Elegirlo para: reuniones, pódcast, llamadas de resultados, archivos multilingües y cualquier cosa donde importen las etiquetas de hablante o los archivos de una hora. Empieza con las rutas gratuitas o ejecútalo localmente.
2. Qwen3-ASR-1.7B: mejor precisión por dólar de GPU
5.40% WER, RTFx 819
Qwen3-ASR-1.7B de Alibaba queda solo 0.07 puntos por detrás de Nemotron en el promedio en inglés, mientras se ejecuta unas 1.8 veces más rápido en el hardware de la tabla, con un modelo una vigésima parte del tamaño total. En la propia comparación multilingüe de siete idiomas de NVIDIA, Nemotron lidera con más claridad: 4.62% de WER medio frente a 6.49%.
Elegirlo para: transcripción por lotes con predominio de inglés en GPU más pequeñas, donde no necesitas atribución de hablantes integrada. Si ya usas los modelos multimodales de Qwen, consulta nuestra guía de Qwen3.5-Omni.
3. IBM Granite Speech 5.0 2B: el mejor en audio de reuniones para su tamaño
5.68% WER, RTFx 545
Granite Speech 5.0 de IBM registra un WER de 6.96% en grabaciones de reuniones AMI, la mejor puntuación AMI entre los seis principales modelos abiertos de esta lista y mejor que el 7.78% de Nemotron allí. Su punto débil son las llamadas financieras de SPGISpeech con 3.36%.
Elegirlo para: equipos empresariales que estandarizan en el stack Granite de IBM, y transcripción de reuniones en GPU de gama media.
4. Cohere Transcribe: rápido y preciso
5.77% WER, RTFx 902
El modelo de transcripción de Cohere Labs de marzo de 2026 combina una puntuación de precisión abierta entre las cinco mejores con una de las velocidades más altas de esta lista. Es más fuerte en LibriSpeech (0.97% limpio, 2.05% otro) y más débil en VoxPopuli con 5.38%.
Elegirlo para: canalizaciones en inglés de alto volumen donde el rendimiento importa tanto como la precisión.
5. TheStage AI Whisper large-v3 turbo: el más rápido de la categoría superior
5.91% WER, RTFx 1,177
Esta es una compilación optimizada de Whisper large-v3 turbo de TheStage AI, y es el modelo más rápido de nuestra lista. Obtiene 1.62% en SPGISpeech, la tercera mejor puntuación en ese conjunto entre los 61 modelos. Demuestra cuánta vida le queda aún a la familia Whisper cuando alguien la ajusta.
Elegirlo para: equipos con código Whisper existente que quieren una mejora de velocidad y precisión sin cambios.
6. NVIDIA Canary-Qwen 2.5B: el anterior buque insignia de NVIDIA
5.94% WER, RTFx 862
Canary-Qwen fue el modelo anterior de voz más LLM de NVIDIA, y Nemotron 3.5 Transcribe lo reemplaza en la cima. Sigue siendo rápido, y su puntuación de 1.70% en SPGISpeech es excelente. En la prueba preference-ASR de NVIDIA, Nemotron obtiene 7.56% frente al 8.16% de Canary-Qwen.
Elegirlo para: implementaciones existentes de NeMo que aún no pueden pasar a una GPU de 80 GB.
7. NVIDIA Parakeet TDT 0.6B: la opción seria más pequeña
5.98% a 6.18% de WER entre versiones
Parakeet TDT tiene varias versiones de 0.6B de parámetros en la tabla, todas dentro de unos 0.2 puntos entre sí. Con 600M de parámetros, es el modelo más pequeño de esta lista que se mantiene cerca del 6% de WER, por lo que se ejecuta en GPU modestas. Su debilidad es el audio de formato largo, donde Nemotron le supera por más de dos puntos.
Elegirlo para: dispositivos edge, GPU económicas y clips cortos como comandos de voz o fragmentos de llamadas.
8. Mistral Voxtral Small 24B: voz más un LLM potente
6.38% WER
Voxtral Small combina entrada de voz con un modelo de lenguaje Mistral de 24B, así que, como Nemotron, puede responder preguntas sobre el audio, no solo transcribirlo. Queda por detrás de los cinco primeros en WER puro. Nuestro análisis comparativo de Voxtral frente a Whisper cubre en profundidad su versión anterior.
Elegirlo para: asistentes de voz y Q&A de audio donde el modelo de lenguaje importa más que el último punto de WER.
9. OpenAI Whisper large-v3: la línea base
7.16% WER, 41.º en general
Whisper large-v3 sigue siendo el modelo abierto más ampliamente implementado, con el mayor ecosistema de wrappers, ajustes finos y tutoriales. En precisión, ahora queda por detrás de todos los demás modelos de esta lista. Si lo ejecutas en producción, cambiar a cualquiera de los seis primeros es la mejora de calidad más económica disponible.
Elegirlo para: prototipos que dependen de herramientas específicas de Whisper, o como línea base a superar.
¿Cuál deberías elegir?
| Tu tarea | Elección |
|---|---|
| Reuniones con varios hablantes | Nemotron 3.5 Transcribe |
| Pódcast o llamadas de una hora en una sola pasada | Nemotron 3.5 Transcribe |
| Archivos multilingües | Nemotron 3.5 Transcribe |
| Trabajos por lotes en inglés en GPU más pequeñas | Qwen3-ASR-1.7B |
| Máximo rendimiento | TheStage Whisper large-v3 turbo o Cohere Transcribe |
| Hardware edge o de bajo costo | Parakeet TDT 0.6B |
| Q&A de audio más transcripción | Nemotron 3.5 Transcribe o Voxtral Small |
| Código Whisper existente, cambio mínimo | TheStage Whisper large-v3 turbo |
Una advertencia: los promedios de la tabla ocultan diferencias de dominio. Nemotron es el mejor en general, pero Granite le supera en AMI y varios modelos le superan en LibriSpeech. Prueba los dos o tres mejores con 50 a 100 de tus propias grabaciones antes de decidirte.
Compara candidatos con tu agente de codificación y Apidog CLI
La forma más rápida de hacer esa comparación es dejar que tu agente de codificación la realice. Sirve dos o tres modelos detrás de endpoints /v1/audio/transcriptions al estilo OpenAI (SGLang-Omni sirve Nemotron de esta manera), y luego haz que el agente cree y ejecute las mismas comprobaciones contra cada uno con Apidog CLI.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Luego dale a tu agente un prompt:
In Apidog project <id>, create one environment per speech server (nemotron, qwen3-asr,
whisper) with its baseUrl. Create test cases that POST each file in samples/ to
{{baseUrl}}/v1/audio/transcriptions, assert status 200 and non-empty text, and save the
transcript to a variable. Run the cases against each environment and give me a table
of failures and response times per server.
El agente lee el esquema, valida su payload, escribe los casos y los ejecuta por entorno:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Puntúa las transcripciones guardadas frente a tu texto de referencia con cualquier script de WER, y mantén la ejecución del entorno ganador en CI con -r junit. Consulta Apidog CLI en Claude Code y Apidog CLI en una canalización CI/CD.
Preguntas frecuentes
¿Cuál es el modelo de voz a texto de código abierto más preciso? NVIDIA Nemotron 3.5 Transcribe, con un WER promedio de 5.33% en el Open ASR Leaderboard del 28 de octubre de 2026.
¿Whisper sigue siendo bueno? Funciona, pero whisper-large-v3 ocupa el puesto 41 con 7.16%. Las compilaciones ajustadas de Whisper como large-v3 turbo de TheStage obtienen 5.91%.
¿Qué modelo abierto es el más rápido? De los modelos de esta lista, Whisper large-v3 turbo de TheStage AI, con un RTFx de 1,177.
¿Los modelos abiertos superan ahora a las API de pago? Algunos. Nemotron 3.5 Transcribe supera a AssemblyAI Universal-3.5 Pro (5.39%) y a OpenAI gpt-transcribe (5.96%). Otter, Zoom y ElevenLabs todavía lideran en general. Para opciones alojadas, consulta nuestra recopilación de API de voz a texto.
¿Cuál admite la diarización de hablantes? Nemotron 3.5 Transcribe lo hace en el mismo modelo, con hasta ocho hablantes. La mayoría de los demás necesitan un paso de diarización aparte.
El veredicto
Para la mayoría de los equipos a finales de 2026, empiecen con Nemotron 3.5 Transcribe si tienen una GPU de 80 GB o pueden pagar $0.12 por hora en una API alojada. Elijan Qwen3-ASR-1.7B cuando el presupuesto de GPU sea ajustado, y Parakeet cuando el hardware sea aún más limitado. Elijan lo que elijan, pruébenlo con su propio audio, y dejen que su agente mantenga las comprobaciones de Apidog en ejecución para que el modelo elegido siga rindiendo después de cada actualización.