
Muse Wonder API là Model API của Meta phục vụ muse-wonder-1.0 tại https://api.meta.ai/v1, với ba định dạng yêu cầu: API Responses, Chat Completions và một endpoint Messages tương thích với Anthropic. Bạn xác thực bằng khóa bearer từ dev.meta.ai, trả $4 cho mỗi triệu token đầu vào và $20 cho mỗi triệu đầu ra, và nhận cửa sổ ngữ cảnh 1 triệu token với mức nỗ lực suy luận từ minimal đến max. Bất kỳ SDK nào của OpenAI cũng hoạt động sau khi bạn đổi base URL.
Hướng dẫn này đưa bạn từ khóa đến một vòng lặp agent hoạt động được: yêu cầu đầu tiên, chọn endpoint, kiểm soát suy luận, trạng thái nhiều lượt, công cụ, streaming, chạy nền, và các trường usage cho biết một lần gọi tốn bao nhiêu. Mỗi yêu cầu cũng được thiết lập sẵn trong Apidog để nhóm của bạn có thể kiểm thử mô hình mà không phải chuyền tay khóa. Muốn biết mô hình này là gì và đạt điểm ra sao, hãy bắt đầu với bài giải thích Muse Wonder.
Tổng quan về Muse Wonder API
| Giá trị | |
|---|---|
| URL cơ sở | https://api.meta.ai/v1 |
| ID mô hình | muse-wonder-1.0 |
| Xác thực | Authorization: Bearer $MODEL_API_KEY |
| Endpoints | POST /v1/responses, POST /v1/chat/completions, POST /v1/messages |
| Giá mỗi 1 triệu token | $4 đầu vào, $20 đầu ra, $0.20 đầu vào từ cache |
| Cửa sổ ngữ cảnh | 1.048.576 token, không phụ phí ngữ cảnh dài |
| Mức nỗ lực suy luận | minimal, low, medium, high, xhigh, max |
| Giới hạn tốc độ | 3.000 yêu cầu và 4 triệu token mỗi phút, theo nhóm và theo mô hình |
| Công cụ tìm kiếm web | $2.50 mỗi 1.000 truy vấn, tính thêm trên cả token |
Muse Wonder Full, mô hình lớn hơn, không có trên API. Nó chỉ khả dụng bên trong Muse Code với các gói Power và Maximum. Đặt mức nỗ lực max cho Wonder không biến nó thành Full.
Bước 1: lấy khóa và thực hiện cuộc gọi đầu tiên
Tạo khóa trong bảng điều khiển Model API, mục API keys, và lưu nó thành MODEL_API_KEY. Sau đó:
curl https://api.meta.ai/v1/responses \
  -H "Authorization: Bearer $MODEL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "muse-wonder-1.0",
    "input": "List three risks in a lease clause that lets the landlord enter without notice.",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 2048
  }'
Với SDK của OpenAI, đổi hai dòng:
from openai import OpenAI
import os

client = OpenAI(base_url="https://api.meta.ai/v1", api_key=os.environ["MODEL_API_KEY"])

resp = client.responses.create(
    model="muse-wonder-1.0",
    input="List three risks in a lease clause that lets the landlord enter without notice.",
    reasoning={"effort": "medium"},
    max_output_tokens=2048,
)
print(resp.output_text)
print(resp.usage)
Phản hồi mang theo văn bản cùng một khối usage. Hãy kiểm tra nó ở mỗi lần gọi: output_tokens_details.reasoning_tokens cho biết bao nhiêu ngân sách đầu ra đã dành cho suy luận, và input_tokens_details.cached_tokens cho biết bao nhiêu đầu vào được tính theo giá cache.
Bước 2: chọn một endpoint
Quickstart của Meta dùng API Responses, và đó là lựa chọn mặc định đúng cho bất kỳ việc gì nhiều bước. Nó giữ suy luận xuyên suốt các lượt và có thể quản lý lịch sử hội thoại giúp bạn. Chat Completions tồn tại cho phần code bạn đã có sẵn với SDK OpenAI. Endpoint Messages tại https://api.meta.ai/v1/messages nhận yêu cầu định dạng Anthropic, cách mà Claude Code chạy trên Muse Wonder.
| Nhu cầu | Dùng |
|---|---|
| Agent mới, vòng lặp công cụ, phiên dài | Responses |
| Code sẵn theo kiểu OpenAI, lượt đơn | Chat Completions |
| Claude Code hoặc harness khác theo định dạng Anthropic | Messages |
| Tóm tắt suy luận | Chỉ Responses |
Ba định dạng khác nhau ở tên tham số. Mức nỗ lực suy luận là reasoning.effort trên Responses và là reasoning_effort cấp cao nhất trên Chat Completions. Giới hạn đầu ra lần lượt là max_output_tokens và max_tokens. Đầu ra có cấu trúc trên Responses dùng text.format, không phải response_format.
Bước 3: đặt mức nỗ lực suy luận
Muse Wonder luôn suy luận. none trả về HTTP 400. Các mức được chấp nhận là minimal, low, medium, high, xhigh và max, và nếu bạn bỏ qua tham số, mô hình tự chọn mức của nó. Lời khuyên của Meta vẫn là: dùng mức thấp nhất cho kết quả chấp nhận được, vì token suy luận được tính theo giá đầu ra $20 và đếm vào hạn mức đầu ra của bạn.
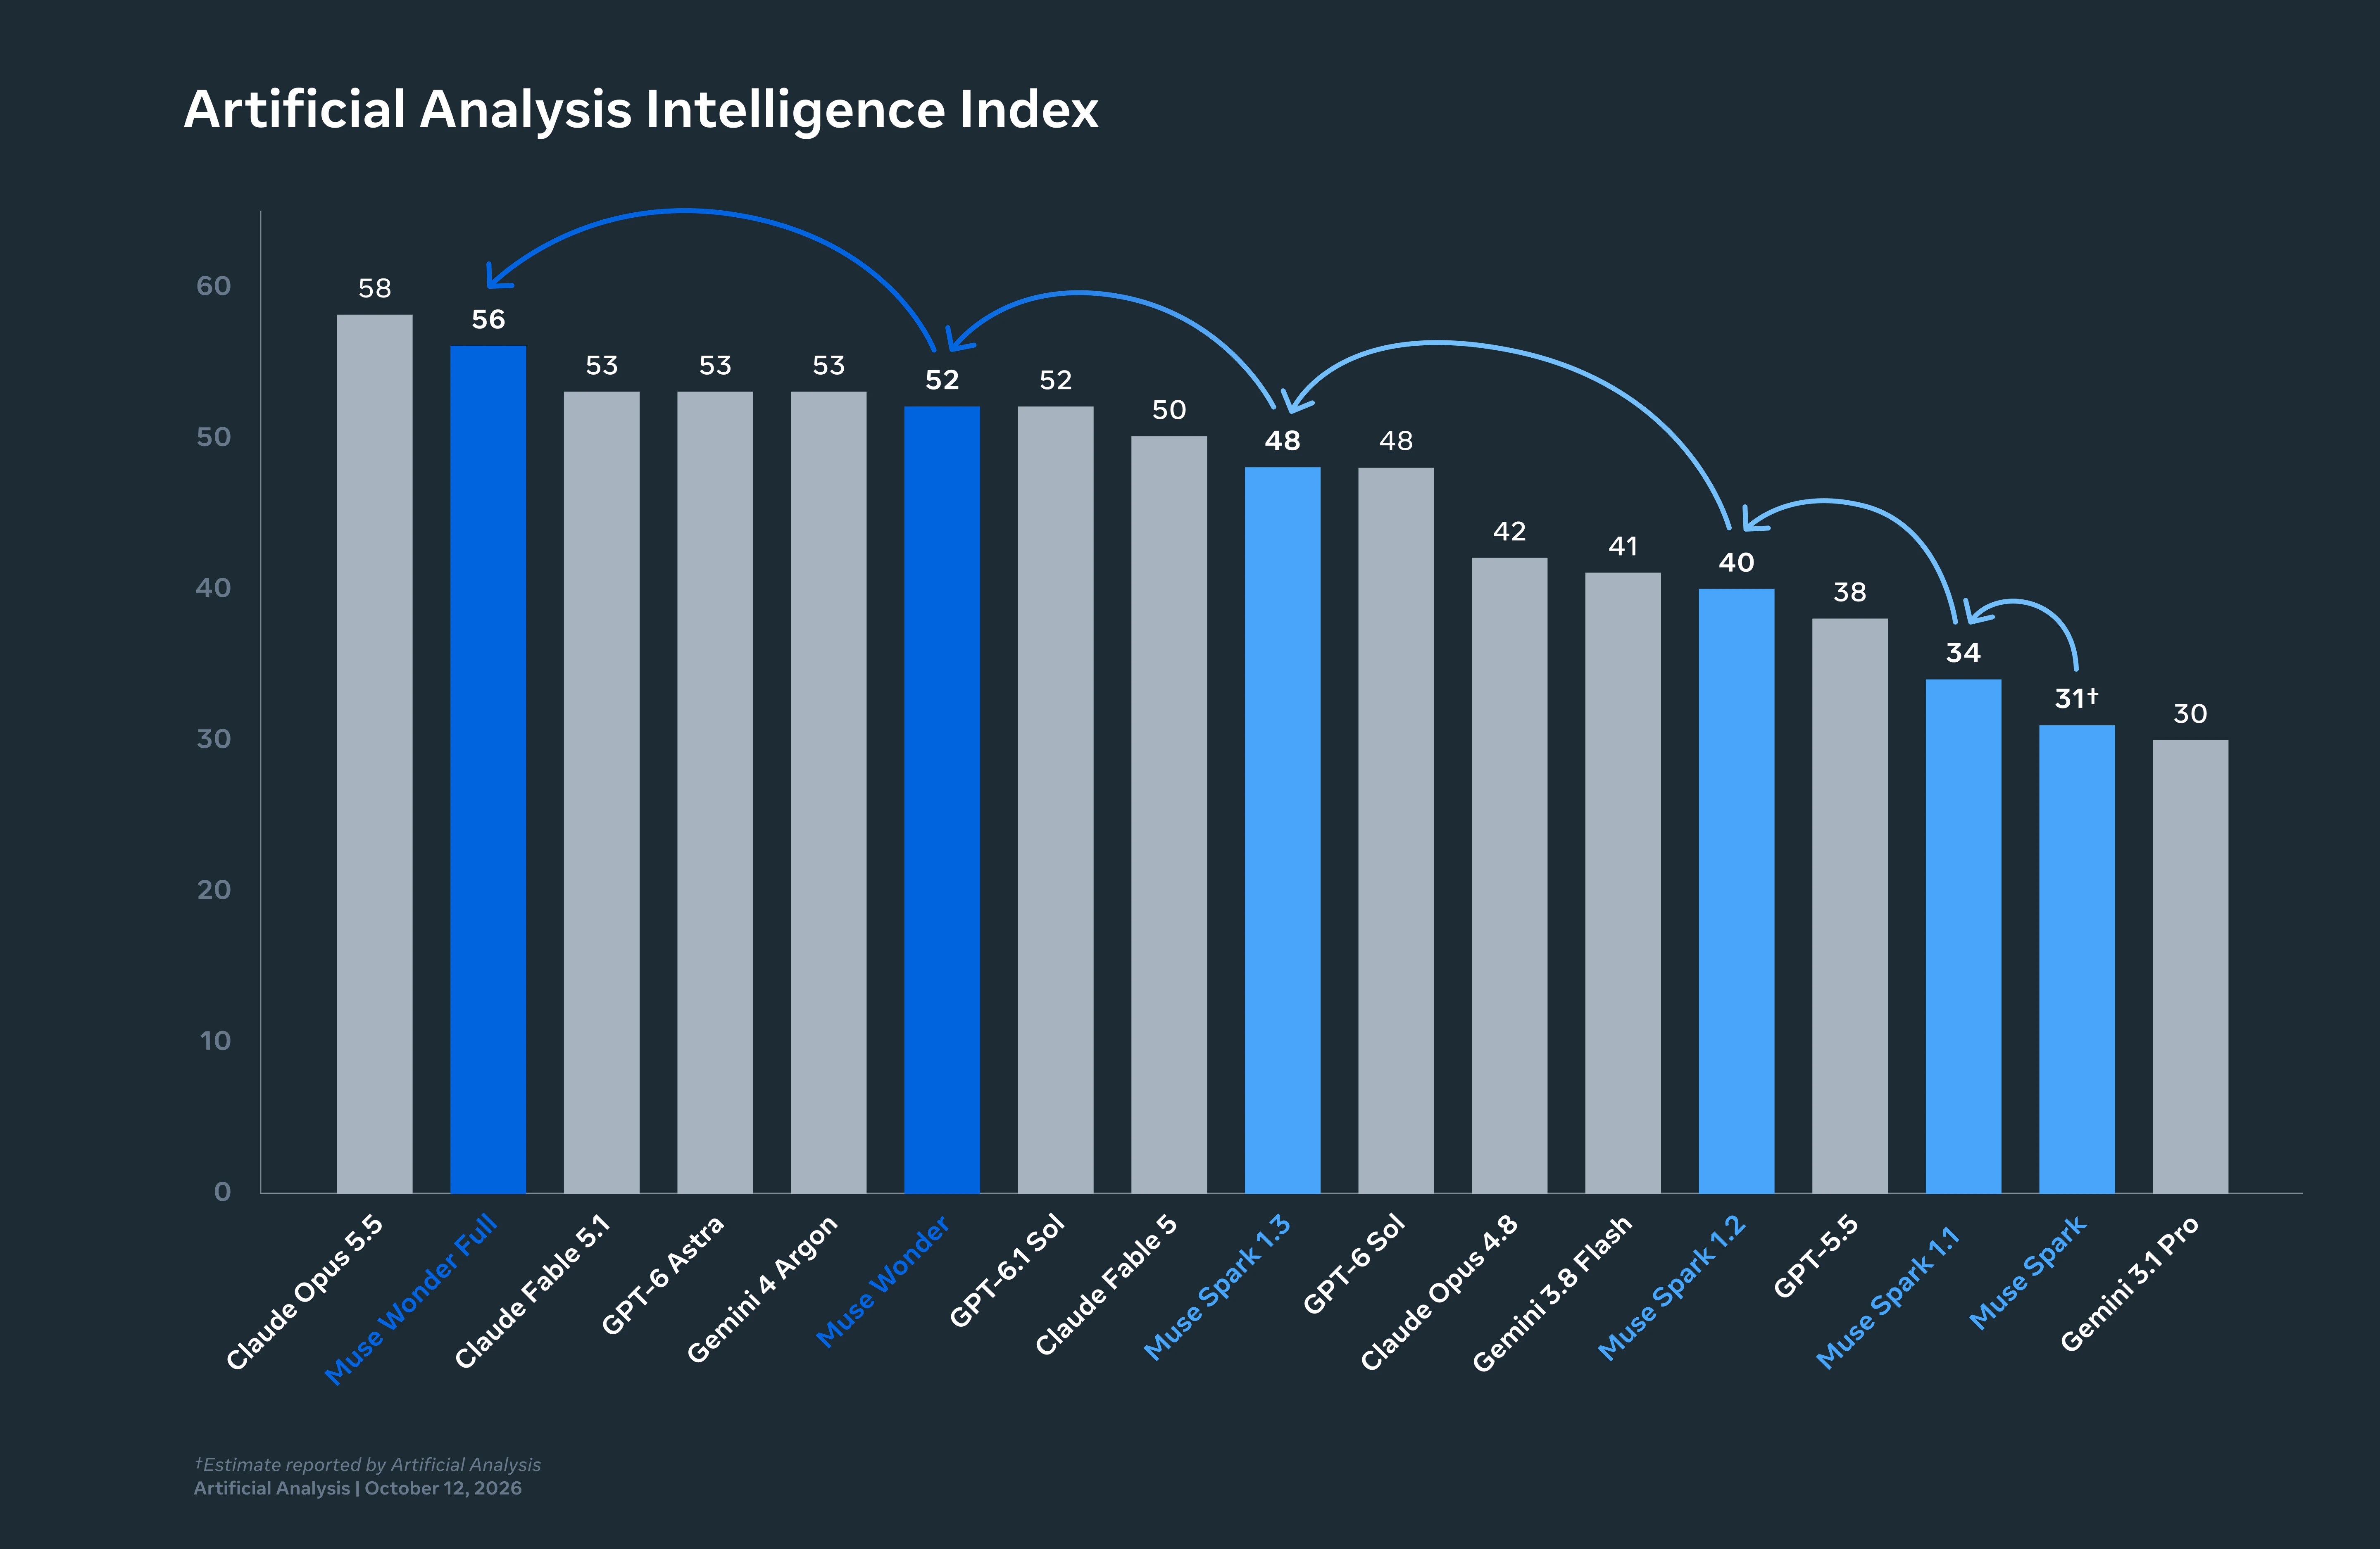
Theo đó có hai quy tắc thực dụng. Thứ nhất, đặt max_output_tokens rộng rãi khi nỗ lực cao; ở max, suy luận chiếm phần lớn đầu ra và hạn mức chặt sẽ cắt cụt câu trả lời. Thứ hai, ghi log reasoning_tokens theo từng loại yêu cầu để thấy mỗi mức nỗ lực tốn bao nhiêu trên lưu lượng của bạn chứ không phải trên benchmark. Các lần chạy của Artificial Analysis cho điểm mô hình 52 dùng mức max và khoảng 54.000 token đầu ra mỗi nhiệm vụ.
Trên API Responses, bạn có thể yêu cầu tóm tắt suy luận bằng cách đặt reasoning.summary thành auto, concise hoặc detailed. Bản tóm tắt không được đảm bảo; mảng có thể trả về rỗng. Suy luận thô không bao giờ được trả về.
Bước 4: giữ trạng thái qua các lượt
API Responses cung cấp hai chế độ, và không thể kết hợp chúng.
Phát lại mã hóa không trạng thái là khuyến nghị của Meta. Gửi store: false và include: ["reasoning.encrypted_content"], giữ lại các mục reasoning mà phản hồi trả về, rồi truyền chúng lại ở lượt kế tiếp cùng encrypted_content và một trường summary (mảng rỗng là được). Suy luận của mô hình tồn tại qua lượt mà Meta không lưu gì cả.
Lịch sử do máy chủ quản lý đơn giản hơn: truyền previous_response_id và chỉ gửi đầu vào mới. Lưu ý instructions không được mang theo, nên hãy gửi lại hướng dẫn hệ thống trong mọi yêu cầu.
first = client.responses.create(model="muse-wonder-1.0", input="Summarize this API's auth flow: ...", instructions="You are an API reviewer.")
second = client.responses.create(model="muse-wonder-1.0", previous_response_id=first.id, instructions="You are an API reviewer.", input="Now list the endpoints that need an OAuth scope.")
Bước 5: công cụ, đầu ra có cấu trúc và tìm kiếm web
Function tools theo dạng của OpenAI trên Responses và Chat Completions. Muse Wonder gọi công cụ song song và được huấn luyện để phục hồi sau các lần gọi công cụ thất bại, một trong những điều bài đăng ra mắt của Meta muốn nói với Active Focus. Định nghĩa công cụ bằng schema JSON, thực thi các mục function_call mà mô hình trả về, và gửi trả các mục function_call_output.
Để có câu trả lời mà code của bạn phân tích được, đặt text.format thành một schema JSON trên Responses. Với thông tin cập nhật, thêm tính năng tìm kiếm do Meta lưu trữ bằng tools=[{"type": "web_search"}]; tính phí $2.50 mỗi 1.000 truy vấn, chưa kể token. Nếu bạn đang kiểm thử lời gọi công cụ cho các mô hình khác, harness kiểm thử tool call cho agent trong Apidog dùng được ngay tại đây: dạng yêu cầu giống hệt của OpenAI.
Bước 6: stream hoặc chạy nền
Đặt stream: true và tiêu thụ luồng sự kiện: response.created, response.output_item.added, response.output_text.delta, response.function_call_arguments.delta và response.completed. Khi lỗi sẽ kết thúc bằng response.failed. Bản tóm tắt suy luận đến dưới dạng response.reasoning_summary_text.delta khi được yêu cầu.
Với công việc dài, gửi background: true. API xác nhận bằng "status": "queued", và bạn poll hoặc nhận luồng sự kiện vòng đời từ GET /v1/responses/{id}?stream=true. Không thể kết hợp background với stream: true trên POST, thân yêu cầu giới hạn 1 MiB, và có giới hạn riêng 600 yêu cầu nền mới mỗi phút mỗi nhóm. Hủy bằng POST /v1/responses/{id}/cancel.
Bước 7: cache phần lặp lại
Đầu vào từ cache giá $0.20 mỗi triệu, giảm 95% so với mức $4, và Meta báo cáo trong usage.input_tokens_details.cached_tokens. Mẫu hình giành được điều đó giống hệt ở nhà cung cấp khác: đặt phần ổn định (hướng dẫn hệ thống, định nghĩa công cụ, tài liệu tham chiếu) trước, nội dung theo từng yêu cầu sau. Hướng dẫn prompt caching nói về thiết kế tiền tố. Cũng để ý phía ghi cache: trong lần chạy của Artificial Analysis, $1.92 trong tổng $4.52 mỗi nhiệm vụ của Wonder là ghi cache, nhiều hơn $1.44 của các cú trúng cache.
Kiểm thử Muse Wonder API trong Apidog
Một dự án Apidog dùng chung giữ khóa khỏi các thread chat và cho mọi người cùng một bộ yêu cầu.
- Tạo một environment tên Meta Model API với
base_urllàhttps://api.meta.ai/v1vàMODEL_API_KEYlà biến bí mật. Giá trị bí mật bị che trong giao diện và không bao giờ được xuất. - Thêm ba yêu cầu, mỗi endpoint một yêu cầu, đều kèm
Authorization: Bearer {{MODEL_API_KEY}}. Nhân bản yêu cầu Responses ở mức nỗ lựclow,mediumvàmaxđể so sánh chi phí cạnh nhau. - Assert trên usage. Thêm assertion JSONPath trên
$.usage.output_tokens_details.reasoning_tokensvà$.usage.input_tokens_details.cached_tokens. Giá trị cached-tokens bằng không ở một yêu cầu bạn kỳ vọng trúng cache là lỗi tiền tố, được phát hiện trước khi vào production. - Giả lập 429. Tài liệu của Meta bảo lùi theo cấp số nhân với jitter từ khoảng 500 ms và tuân thủ
Retry-After. Trỏ client của bạn tới một mock của Apidog trả về 429 với header đó và chứng minh logic retry trước khi chia sẻ giới hạn 3.000 yêu cầu mỗi phút với cả nhóm. - Chạy trong CI với Apidog CLI để thay đổi mô hình hay giá làm hỏng pipeline chứ không phải làm khách hàng.
Tải Apidog và nhập ba endpoint từ các ví dụ yêu cầu ở trên.
Câu hỏi thường gặp
Muse Wonder API có gói miễn phí không? Không. Tính phí theo token, không mức tối thiểu, nên vài cuộc gọi thử chỉ tốn vài xu, nhưng không có tín dụng miễn phí. Hướng dẫn truy cập miễn phí liệt kê các lộ trình rẻ nhất.
Dữ liệu API của tôi có bị dùng để huấn luyện không? Không, ở chế độ Standard của API. Đăng ký Muse Code mặc định dùng chế độ Contributor, chế độ có dùng dữ liệu của bạn; thiết đặt đó nằm trong Muse Code, không phải API.
Có thể dùng Muse Wonder Full qua API không? Không. Nó không có ID mô hình để gọi và không có giá theo token. Chỉ người đăng ký Muse Code Power và Maximum mới chọn được nó.
Giới hạn tốc độ là bao nhiêu và có nâng được không? 3.000 yêu cầu và 4 triệu token mỗi phút mỗi mô hình, tính gộp trên mọi khóa trong nhóm của bạn. Trang giá của Meta không liệt kê bậc nào cũng như quy trình nâng hạn mức. Bài về giới hạn tốc độ hướng dẫn cách giữ ở dưới ngưỡng.
Bước tiếp theo
Thực hiện ba cuộc gọi trên với mức nỗ lực low, medium và max trên một nhiệm vụ thật của sản phẩm bạn, và so sánh reasoning_tokens trước khi chọn giá trị mặc định. Con số đó, chứ không phải tiêu đề $4, mới là thứ hóa đơn của bạn sẽ bám theo.