
Muse Wonder API คือ Model API ของ Meta ที่ให้บริการ muse-wonder-1.0 ที่ https://api.meta.ai/v1 โดยมีรูปแบบคำขอ 3 แบบ ได้แก่ Responses API, Chat Completions และ Messages endpoint ที่รองรับ Anthropic คุณยืนยันตัวตนด้วย bearer key จาก dev.meta.ai จ่าย $4 ต่อ input token 1 ล้านตัวและ $20 ต่อ output token 1 ล้านตัว และได้ context window ขนาด 1M token ที่ปรับ reasoning effort ได้ตั้งแต่ minimal ถึง max เปลี่ยนแค่ base URL ก็ใช้ OpenAI SDK ตัวไหนก็ได้
คู่มือนี้พาคุณจาก key ไปจนถึง agentic loop ที่ใช้งานได้จริง ทั้งคำขอแรก การเลือก endpoint การควบคุม reasoning การส่งสถานะข้ามรอบสนทนา tools, streaming, background runs และช่อง usage ที่บอกว่าการเรียกหนึ่งครั้งเสียค่าใช้จ่ายเท่าไร ทุกคำขอยังตั้งเตรียมไว้ใน Apidog แล้ว เพื่อให้ทีมของคุณทดสอบโมเดลได้โดยไม่ต้องส่งต่อ key ส่วนโมเดลนี้คืออะไรและคะแนนเป็นอย่างไร เริ่มจาก บทอธิบาย Muse Wonder ได้เลย
Muse Wonder API ในภาพรวม
| ค่า | |
|---|---|
| Base URL | https://api.meta.ai/v1 |
| Model ID | muse-wonder-1.0 |
| การยืนยันตัวตน | Authorization: Bearer $MODEL_API_KEY |
| Endpoints | POST /v1/responses, POST /v1/chat/completions, POST /v1/messages |
| ราคาต่อ token 1 ล้านตัว | $4 input, $20 output, $0.20 สำหรับ input ที่แคชแล้ว |
| Context window | 1,048,576 tokens โดยไม่มีส่วนต่างสำหรับบริบทยาว |
| Reasoning effort | minimal, low, medium, high, xhigh, max |
| Rate limits | 3,000 requests และ 4M tokens ต่อนาที ต่อหนึ่งทีมต่อหนึ่งโมเดล |
| เครื่องมือค้นเว็บ | $2.50 ต่อการค้น 1,000 ครั้ง นอกเหนือจากค่า tokens |
Muse Wonder Full โมเดลขนาดใหญ่กว่า ไม่ได้อยู่บน API มีให้ใช้เฉพาะใน Muse Code แผน Power และ Maximum เท่านั้น การตั้ง effort เป็น max บน Wonder ไม่ได้เปลี่ยนให้เป็น Full
ขั้นตอนที่ 1: ขอ key และเรียกใช้ครั้งแรก
สร้าง key ในแดชบอร์ดของ Model API ในหมวด API keys แล้วเก็บไว้เป็น MODEL_API_KEY จากนั้น:
curl https://api.meta.ai/v1/responses \
  -H "Authorization: Bearer $MODEL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "muse-wonder-1.0",
    "input": "List three risks in a lease clause that lets the landlord enter without notice.",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 2048
  }'
ถ้าใช้ OpenAI SDK เปลี่ยนแค่สองบรรทัด:
from openai import OpenAI
import os

client = OpenAI(base_url="https://api.meta.ai/v1", api_key=os.environ["MODEL_API_KEY"])

resp = client.responses.create(
    model="muse-wonder-1.0",
    input="List three risks in a lease clause that lets the landlord enter without notice.",
    reasoning={"effort": "medium"},
    max_output_tokens=2048,
)
print(resp.output_text)
print(resp.usage)
คำตอบจะมีทั้งข้อความและบล็อก usage ควรตรวจทุกครั้งที่เรียก output_tokens_details.reasoning_tokens บอกว่างบฝั่ง output ถูกใช้ไปกับการคิดเท่าไร ส่วน input_tokens_details.cached_tokens บอกว่า input จำนวนเท่าไรถูกคิดในอัตราแคช
ขั้นตอนที่ 2: เลือก endpoint
Quickstart ของ Meta ใช้ Responses API ซึ่งเป็นค่าเริ่มต้นที่เหมาะสมสำหรับงานหลายขั้นตอน ทั้งรักษา reasoning ข้ามรอบสนทนาและจัดการประวัติบทสนทนาให้คุณได้ ส่วน Chat Completions มีไว้สำหรับโค้ดเดิมที่เขียนกับ OpenAI SDK อยู่แล้ว และ Messages endpoint ที่ https://api.meta.ai/v1/messages รับคำขอรูปแบบ Anthropic ซึ่งเป็นวิธีที่ Claude Code ทำงานบน Muse Wonder
| ความต้องการ | ใช้ |
|---|---|
| Agent ใหม่, tool loop, เซสชันยาว | Responses |
| โค้ดสไตล์ OpenAI ที่มีอยู่แล้ว, คำขอรอบเดียว | Chat Completions |
| Claude Code หรือ harness รูปแบบ Anthropic อื่น | Messages |
| สรุป reasoning | Responses เท่านั้น |
สามรูปแบบนี้ต่างกันที่ชื่อพารามิเตอร์ reasoning effort บน Responses คือ reasoning.effort แต่บน Chat Completions เป็น reasoning_effort ที่ระดับบนสุด ส่วนเพดาน output คือ max_output_tokens และ max_tokens ตามลำดับ การกำหนด output แบบมีโครงสร้างบน Responses ใช้ text.format ไม่ใช่ response_format
ขั้นตอนที่ 3: ตั้งค่า reasoning effort
Muse Wonder คิดเสมอ ถ้าส่ง none จะได้ HTTP 400 ระดับที่รองรับคือ minimal, low, medium, high, xhigh และ max ถ้าไม่ส่งพารามิเตอร์นี้ โมเดลจะเลือกระดับเอง คำแนะนำของ Meta ก็ตามมาตรฐาน คือใช้ระดับต่ำที่สุดที่ยังให้ผลซึ่งยอมรับได้ เพราะ reasoning tokens ถูกคิดในอัตรา output $20 และนับเข้าเพดาน output ของคุณด้วย
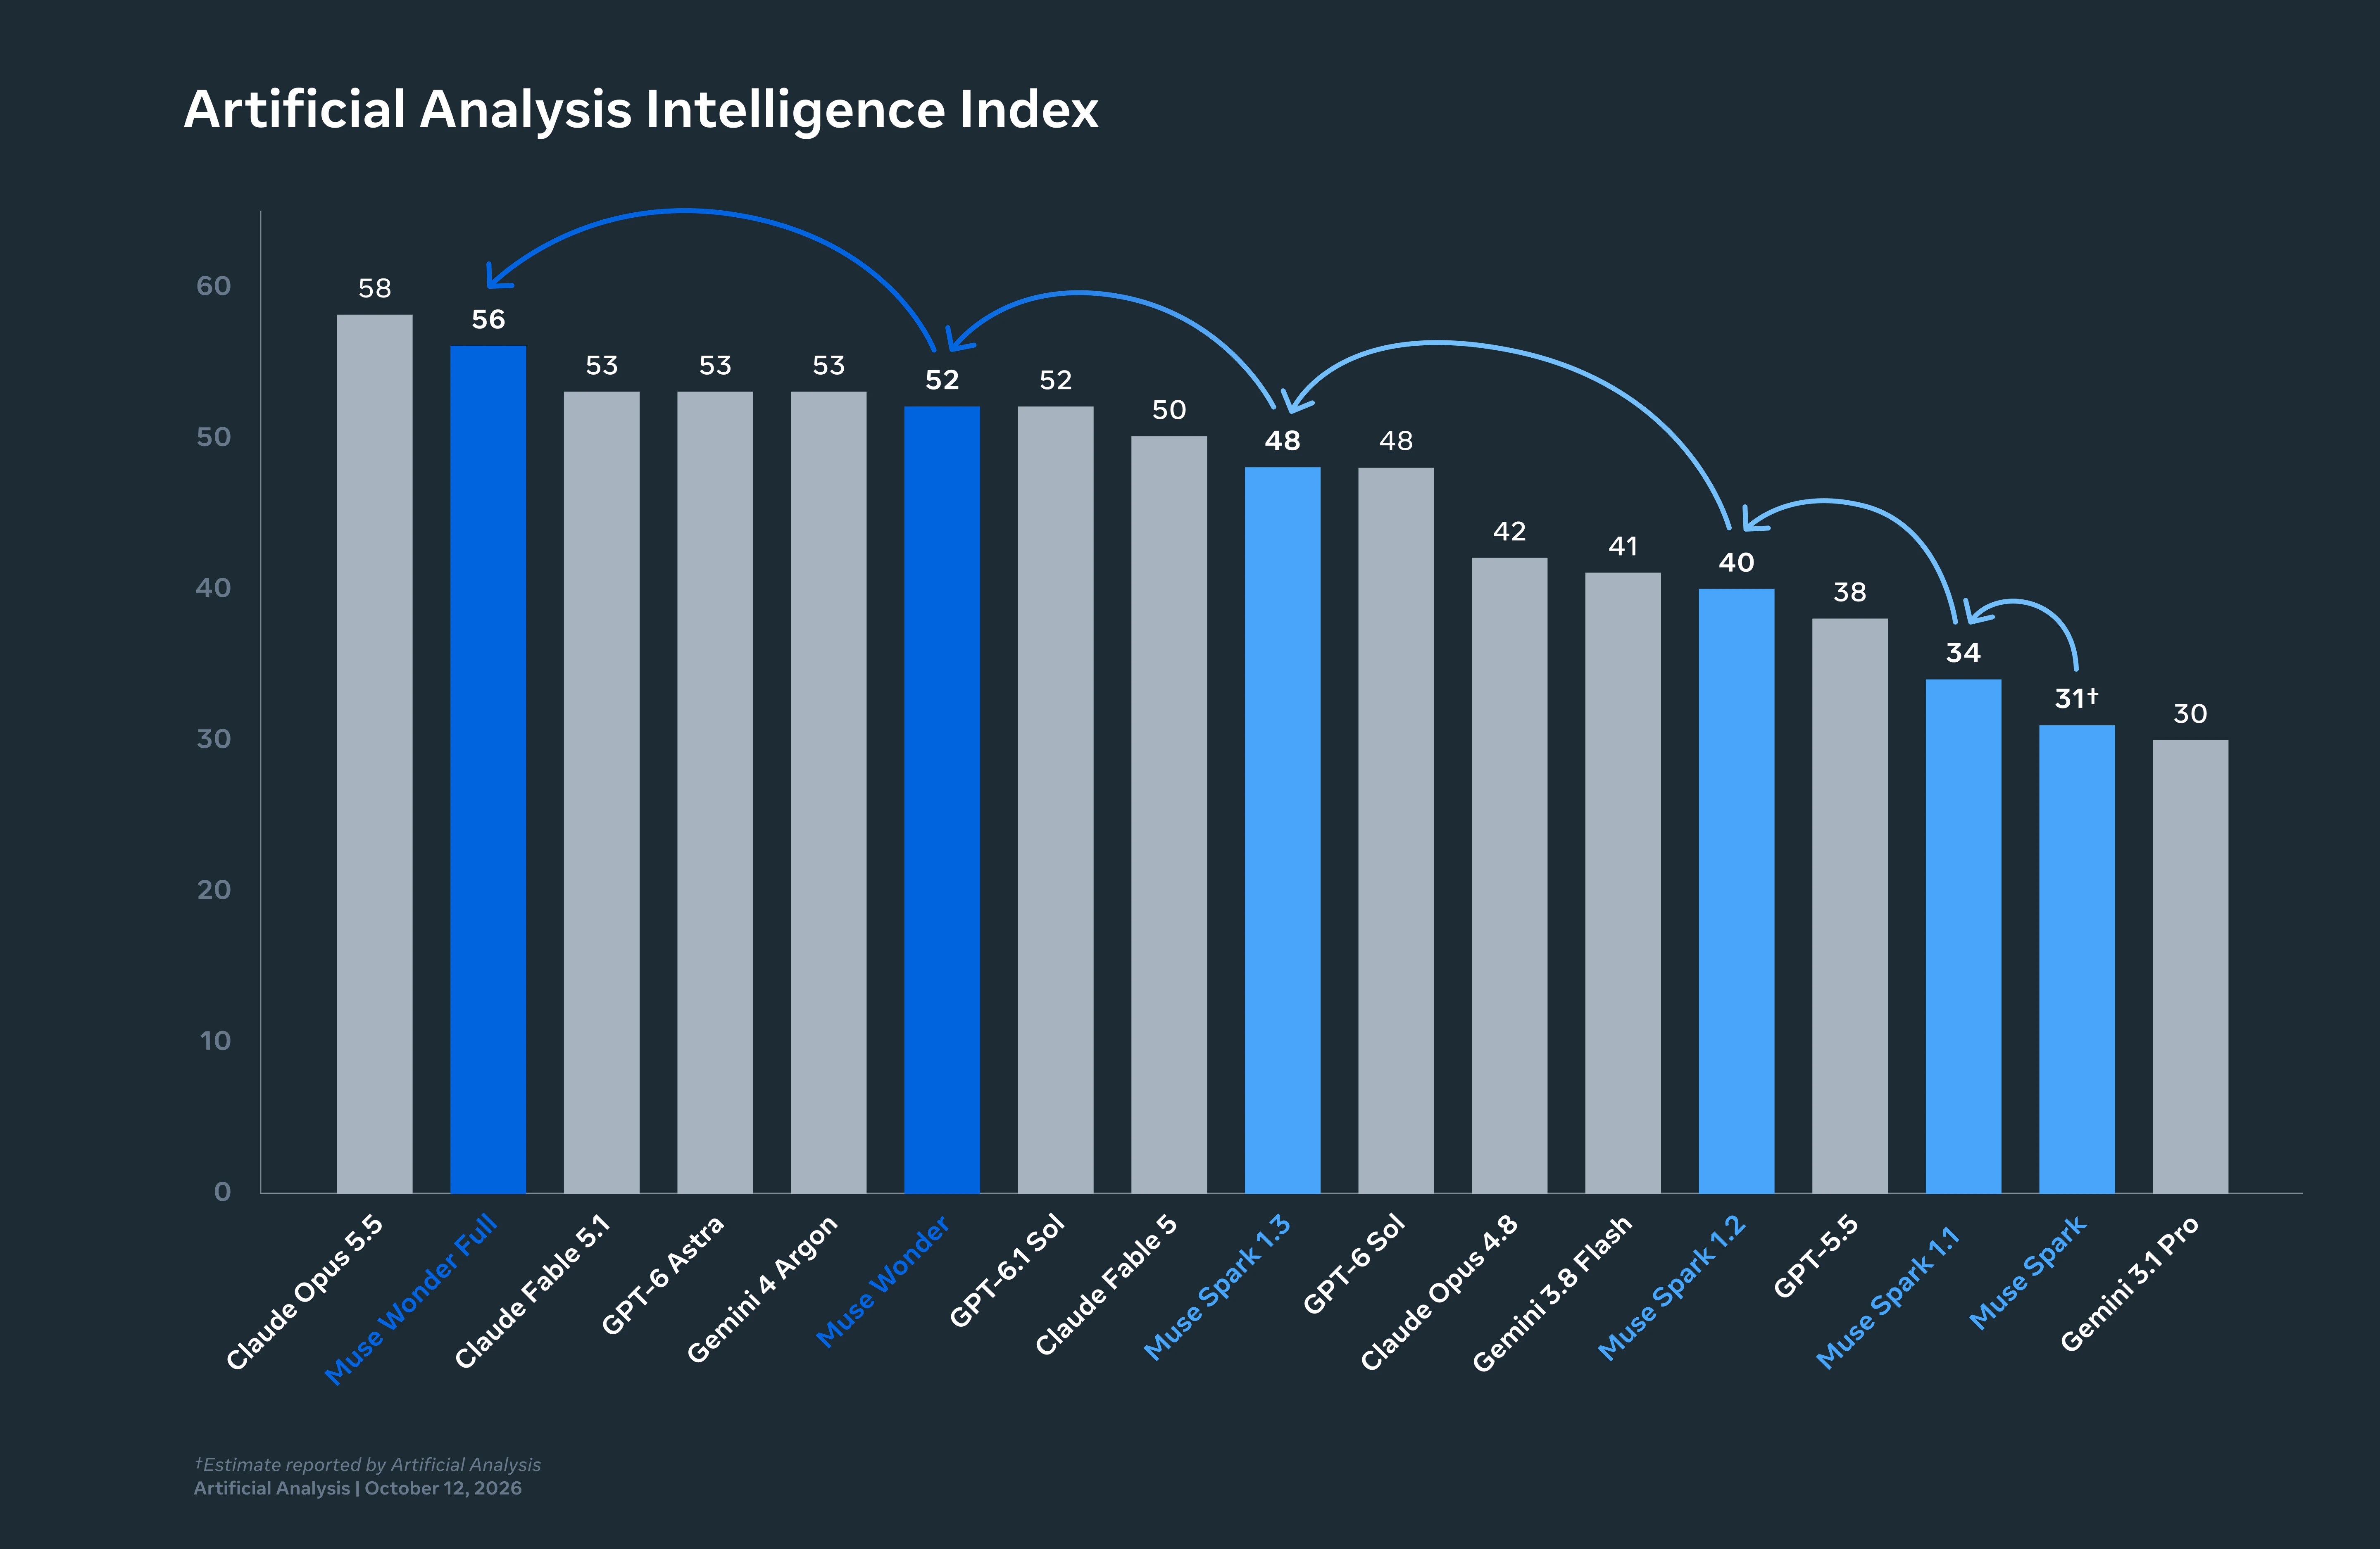
มีกฎปฏิบัติสองข้อ ข้อแรก ตั้ง max_output_tokens ไว้กว้างเวลาใช้ effort สูง ที่ max ส่วนคิดจะกิน output เป็นจำนวนมาก และเพดานที่แคบเกินไปจะตัดคำตอบขาด ข้อสอง บันทึก reasoning_tokens แยกตามประเภทคำขอ เพื่อเห็นว่าแต่ละระดับกินค่าใช้จ่ายเท่าไรบนทราฟฟิกจริงของคุณ ไม่ใช่บนเบนช์มาร์ก การทดสอบของ Artificial Analysis ที่ให้โมเดล 52 คะแนน ใช้ effort max และ output ราว 54,000 tokens ต่องาน
บน Responses API คุณขอสรุป reasoning ได้ด้วยการตั้ง reasoning.summary เป็น auto, concise หรือ detailed สรุปไม่การันตี อาจได้ array ว่างกลับมา และ reasoning ดิบจะไม่ถูกส่งกลับเด็ดขาด
ขั้นตอนที่ 4: ส่งสถานะข้ามรอบสนทนา
Responses API มีสองโหมดและใช้ร่วมกันไม่ได้
Stateless encrypted replay เป็นแนวทางที่ Meta แนะนำ ส่ง store: false และ include: ["reasoning.encrypted_content"] เก็บ item reasoning ที่คำตอบส่งกลับมา แล้วส่งกลับไปในรอบถัดไปพร้อม encrypted_content และฟิลด์ summary (array ว่างก็ได้) reasoning ของโมเดลจะรอดข้ามรอบโดยที่ Meta ไม่จัดเก็บอะไรเลย
Server-managed history ง่ายกว่า คือส่ง previous_response_id แล้วส่งแค่ input ใหม่ โดยระวังว่า instructions ไม่ถูกส่งต่อ จึงต้องส่ง system instructions ในทุกคำขอ
first = client.responses.create(model="muse-wonder-1.0", input="Summarize this API's auth flow: ...", instructions="You are an API reviewer.")
second = client.responses.create(model="muse-wonder-1.0", previous_response_id=first.id, instructions="You are an API reviewer.", input="Now list the endpoints that need an OAuth scope.")
ขั้นตอนที่ 5: tools, structured output และการค้นเว็บ
Function tools ใช้รูปแบบเดียวกับ OpenAI บนทั้ง Responses และ Chat Completions Muse Wonder เรียก tools ขนานกันได้ และถูกฝึกให้ฟื้นตัวจากการเรียก tool ที่ล้มเหลว ซึ่งเป็นหนึ่งในสิ่งที่โพสต์เปิดตัวของ Meta เรียกว่า Active Focus ให้นิยาม tools ด้วย JSON schema แล้ว execute item function_call ที่โมเดลส่งกลับ และส่ง item function_call_output กลับไป
ถ้าต้องการคำตอบที่โค้ดของคุณ parse ได้ ให้ตั้ง text.format เป็น JSON schema บน Responses ส่วนข้อมูลล่าสุด ให้เพิ่มบริการค้นเว็บของ Meta ด้วย tools=[{"type": "web_search"}] ซึ่งคิด $2.50 ต่อการค้น 1,000 ครั้ง นอกเหนือจากค่า tokens ถ้าคุณทดสอบการเรียก tool ของโมเดลอื่นอยู่แล้ว agent tool-call harness ใน Apidog ใช้ได้เลยโดยไม่ต้องแก้อะไร รูปร่างคำขอเหมือนของ OpenAI
ขั้นตอนที่ 6: stream หรือรันในเบื้องหลัง
ตั้ง stream: true แล้วอ่าน event stream ทั้ง response.created, response.output_item.added, response.output_text.delta, response.function_call_arguments.delta และ response.completed ถ้าล้มเหลวจะจบด้วย response.failed สรุป reasoning จะมาเป็น response.reasoning_summary_text.delta เมื่อขอไว้
งานยาว ๆ ให้ส่ง background: true API จะตอบรับด้วย "status": "queued" แล้วคุณค่อย poll หรือ stream lifecycle events จาก GET /v1/responses/{id}?stream=true ห้ามใช้ background ร่วมกับ stream: true บน POST ขนาด request body จำกัดที่ 1 MiB และยังมีลิมิตแยกต่างหากที่ 600 คำขอ background ใหม่ต่อนาทีต่อทีม ยกเลิกด้วย POST /v1/responses/{id}/cancel
ขั้นตอนที่ 7: แคชสิ่งที่ซ้ำ
input ที่แคชแล้วราคา $0.20 ต่อล้าน ถูกกว่าอัตรา $4 อยู่ 95% และ Meta รายงานไว้ใน usage.input_tokens_details.cached_tokens รูปแบบที่ทำให้ได้แคชเหมือนกับผู้ให้บริการอื่น คือวางส่วนที่นิ่ง (system instructions, นิยาม tools, เอกสารอ้างอิง) ไว้ต้น แล้วเนื้อหาเฉพาะของแต่ละคำขอไว้ท้าย คู่มือ prompt caching ลงรายละเอียดการออกแบบ prefix และอย่าลืมมองฝั่ง cache write ด้วย ในการทดสอบของ Artificial Analysis จากค่าใช้จ่าย $4.52 ต่องานของ Wonder มี $1.92 เป็น cache write มากกว่า cache hit ที่ $1.44 เสียอีก
ทดสอบ Muse Wonder API ใน Apidog
โปรเจกต์ Apidog ที่แชร์กันช่วยให้ key ไม่หลุดไปอยู่ในแชต และทุกคนใช้ชุดคำขอเดียวกัน
- สร้าง environment ชื่อ Meta Model API โดยตั้ง
base_urlเป็นhttps://api.meta.ai/v1และเก็บMODEL_API_KEYเป็น secret variable ค่า secret จะถูกปิดบังใน UI และไม่ถูก export ออกไป - เพิ่มคำขอสามตัว ตัวละ endpoint โดยแต่ละตัวใส่
Authorization: Bearer {{MODEL_API_KEY}}แล้วทำสำเนาคำขอ Responses ไว้ที่ effortlow,mediumและmaxเพื่อเทียบค่าใช้จ่ายแบบเห็นพร้อมกัน - ใส่ assertion ที่ usage เพิ่ม JSONPath assertions ที่
$.usage.output_tokens_details.reasoning_tokensและ$.usage.input_tokens_details.cached_tokensถ้า cached tokens เป็นศูนย์ทั้งที่คำขอนั้นน่าจะโดนแคช นั่นคือบั๊กของ prefix ที่จับได้ก่อนขึ้นโปรดักชัน - Mock 429 ไว้ เอกสารของ Meta แนะนำให้ถอยแบบ exponential พร้อม jitter เริ่มราว 500 ms และเคารพ
Retry-Afterชี้ client ไปที่ mock ของ Apidog ที่ตอบ 429 พร้อม header นี้ แล้วพิสูจน์ retry logic ก่อนไปแชร์ลิมิต 3,000 requests ต่อนาทีกับทั้งทีม - รันใน CI ด้วย Apidog CLI เพื่อให้การเปลี่ยนโมเดลหรือราคาทำ pipeline ล้ม ไม่ใช่ทำลูกค้าล้ม
ดาวน์โหลด Apidog แล้ว import สาม endpoint จากตัวอย่างคำขอด้านบน
คำถามที่พบบ่อย
Muse Wonder API มี free tier ไหม? ไม่มี คิดเงินตาม token โดยไม่มีขั้นต่ำ คำขอทดสอบไม่กี่ครั้งจึงเสียเงินเพียงไม่กี่เซนต์ แต่ไม่มีเครดิตฟรี ส่วนเส้นทางที่ถูกที่สุด คู่มือการใช้ฟรี จัดไว้ให้แล้ว
ข้อมูล API ของฉันถูกใช้เทรนโมเดลไหม? ไม่ ในโหมด Standard ของ API ส่วนสมาชิก Muse Code จะอยู่โหมด Contributor เป็นค่าเริ่มต้น ซึ่งใช้ข้อมูลของคุณจริง การตั้งค่านี้อยู่ใน Muse Code ไม่ใช่ใน API
ใช้ Muse Wonder Full ผ่าน API ได้ไหม? ไม่ได้ ไม่มี model ID ให้เรียกและไม่มีราคาต่อ token เลือกได้เฉพาะสมาชิก Muse Code แผน Power และ Maximum
Rate limits เท่าไรและเพิ่มได้ไหม? 3,000 requests และ 4 ล้าน tokens ต่อนาทีต่อโมเดล นับรวมทุก key ในทีม หน้าราคาของ Meta ไม่มีทั้ง tier และขั้นตอนขอเพิ่ม โพสต์เรื่อง rate limits บอกวิธีใช้ให้อยู่ใต้ลิมิต
ก้าวต่อไป
เรียกสามคำขอข้างบนที่ effort low, medium และ max บนงานจริงหนึ่งงานจากผลิตภัณฑ์ของคุณ แล้วเทียบ reasoning_tokens ก่อนเลือกค่าเริ่มต้น ตัวเลขนั้น ไม่ใช่พาดหัว $4 คือสิ่งที่บิลของคุณจะตาม