
L'API Muse Wonder est la Model API de Meta qui sert muse-wonder-1.0 à l'adresse https://api.meta.ai/v1, avec trois formats de requête : l'API Responses, Chat Completions et un endpoint Messages compatible Anthropic. Vous vous authentifiez avec une clé bearer obtenue sur dev.meta.ai, vous payez $4 par million de tokens d'entrée et $20 par million de tokens de sortie, et vous obtenez une fenêtre de contexte d'1M de tokens avec un effort de raisonnement allant de minimal à max. N'importe quel SDK OpenAI fonctionne dès que vous changez l'URL de base.
Ce guide vous mène de la clé à une boucle agentique fonctionnelle : la première requête, le choix d'un endpoint, le contrôle du raisonnement, l'état multi-tours, les outils, le streaming, les exécutions en arrière-plan et les champs d'usage qui vous disent ce qu'a coûté un appel. Chaque requête est aussi configurée dans Apidog pour que votre équipe puisse tester le modèle sans faire circuler la clé. Pour savoir ce qu'est le modèle et comment il se classe, commencez par l'explication de Muse Wonder.
L'API Muse Wonder en un coup d'œil
| Valeur | |
|---|---|
| URL de base | https://api.meta.ai/v1 |
| ID du modèle | muse-wonder-1.0 |
| Authentification | Authorization: Bearer $MODEL_API_KEY |
| Endpoints | POST /v1/responses, POST /v1/chat/completions, POST /v1/messages |
| Prix pour 1M de tokens | $4 en entrée, $20 en sortie, $0.20 en entrée mise en cache |
| Fenêtre de contexte | 1 048 576 tokens, aucun supplément long contexte |
| Effort de raisonnement | minimal, low, medium, high, xhigh, max |
| Rate limits | 3 000 requêtes et 4M de tokens par minute, par équipe et par modèle |
| Outil de recherche web | $2.50 pour 1 000 requêtes, en plus des tokens |
Muse Wonder Full, le modèle plus grand, n'est pas sur l'API. Il n'est disponible qu'au sein de Muse Code, dans les formules Power et Maximum. Régler l'effort sur max avec Wonder n'en fait pas pour autant Full.
Étape 1 : obtenir une clé et passer le premier appel
Créez une clé dans le tableau de bord de la Model API, sous API keys, et stockez-la comme MODEL_API_KEY. Ensuite :
curl https://api.meta.ai/v1/responses \
  -H "Authorization: Bearer $MODEL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "muse-wonder-1.0",
    "input": "List three risks in a lease clause that lets the landlord enter without notice.",
    "reasoning": {"effort": "medium"},
    "max_output_tokens": 2048
  }'
Avec le SDK OpenAI, changez deux lignes :
from openai import OpenAI
import os

client = OpenAI(base_url="https://api.meta.ai/v1", api_key=os.environ["MODEL_API_KEY"])

resp = client.responses.create(
    model="muse-wonder-1.0",
    input="List three risks in a lease clause that lets the landlord enter without notice.",
    reasoning={"effort": "medium"},
    max_output_tokens=2048,
)
print(resp.output_text)
print(resp.usage)
La réponse contient le texte plus un bloc usage. Vérifiez-le à chaque appel : output_tokens_details.reasoning_tokens indique quelle part du budget de sortie est allée à la réflexion, et input_tokens_details.cached_tokens quelle part de l'entrée a été facturée au tarif en cache.
Étape 2 : choisir un endpoint
Le quickstart de Meta utilise l'API Responses, et c'est le bon choix par défaut pour tout ce qui est multi-étapes. Elle préserve le raisonnement d'un tour à l'autre et peut gérer l'historique de conversation pour vous. Chat Completions existe pour le code que vous avez déjà contre un SDK OpenAI. L'endpoint Messages à l'adresse https://api.meta.ai/v1/messages accepte les requêtes au format Anthropic, et c'est ainsi que Claude Code tourne sur Muse Wonder.
| Besoin | À utiliser |
|---|---|
| Nouvel agent, boucles d'outils, longues sessions | Responses |
| Code existant de style OpenAI, tours uniques | Chat Completions |
| Claude Code ou autre harnais au format Anthropic | Messages |
| Résumés de raisonnement | Responses uniquement |
Les trois formats diffèrent par les noms de paramètres. L'effort de raisonnement s'appelle reasoning.effort sur Responses et reasoning_effort, au premier niveau, sur Chat Completions. Les plafonds de sortie sont max_output_tokens et max_tokens respectivement. La sortie structurée sur Responses utilise text.format, pas response_format.
Étape 3 : régler l'effort de raisonnement
Muse Wonder raisonne toujours. none renvoie un HTTP 400. Les niveaux acceptés sont minimal, low, medium, high, xhigh et max, et si vous omettez le paramètre, le modèle choisit son propre niveau. Le conseil de Meta est l'habituel : utilisez le niveau le plus bas qui donne des résultats acceptables, car les tokens de raisonnement sont facturés au tarif de sortie de $20 et comptent dans votre plafond de sortie.
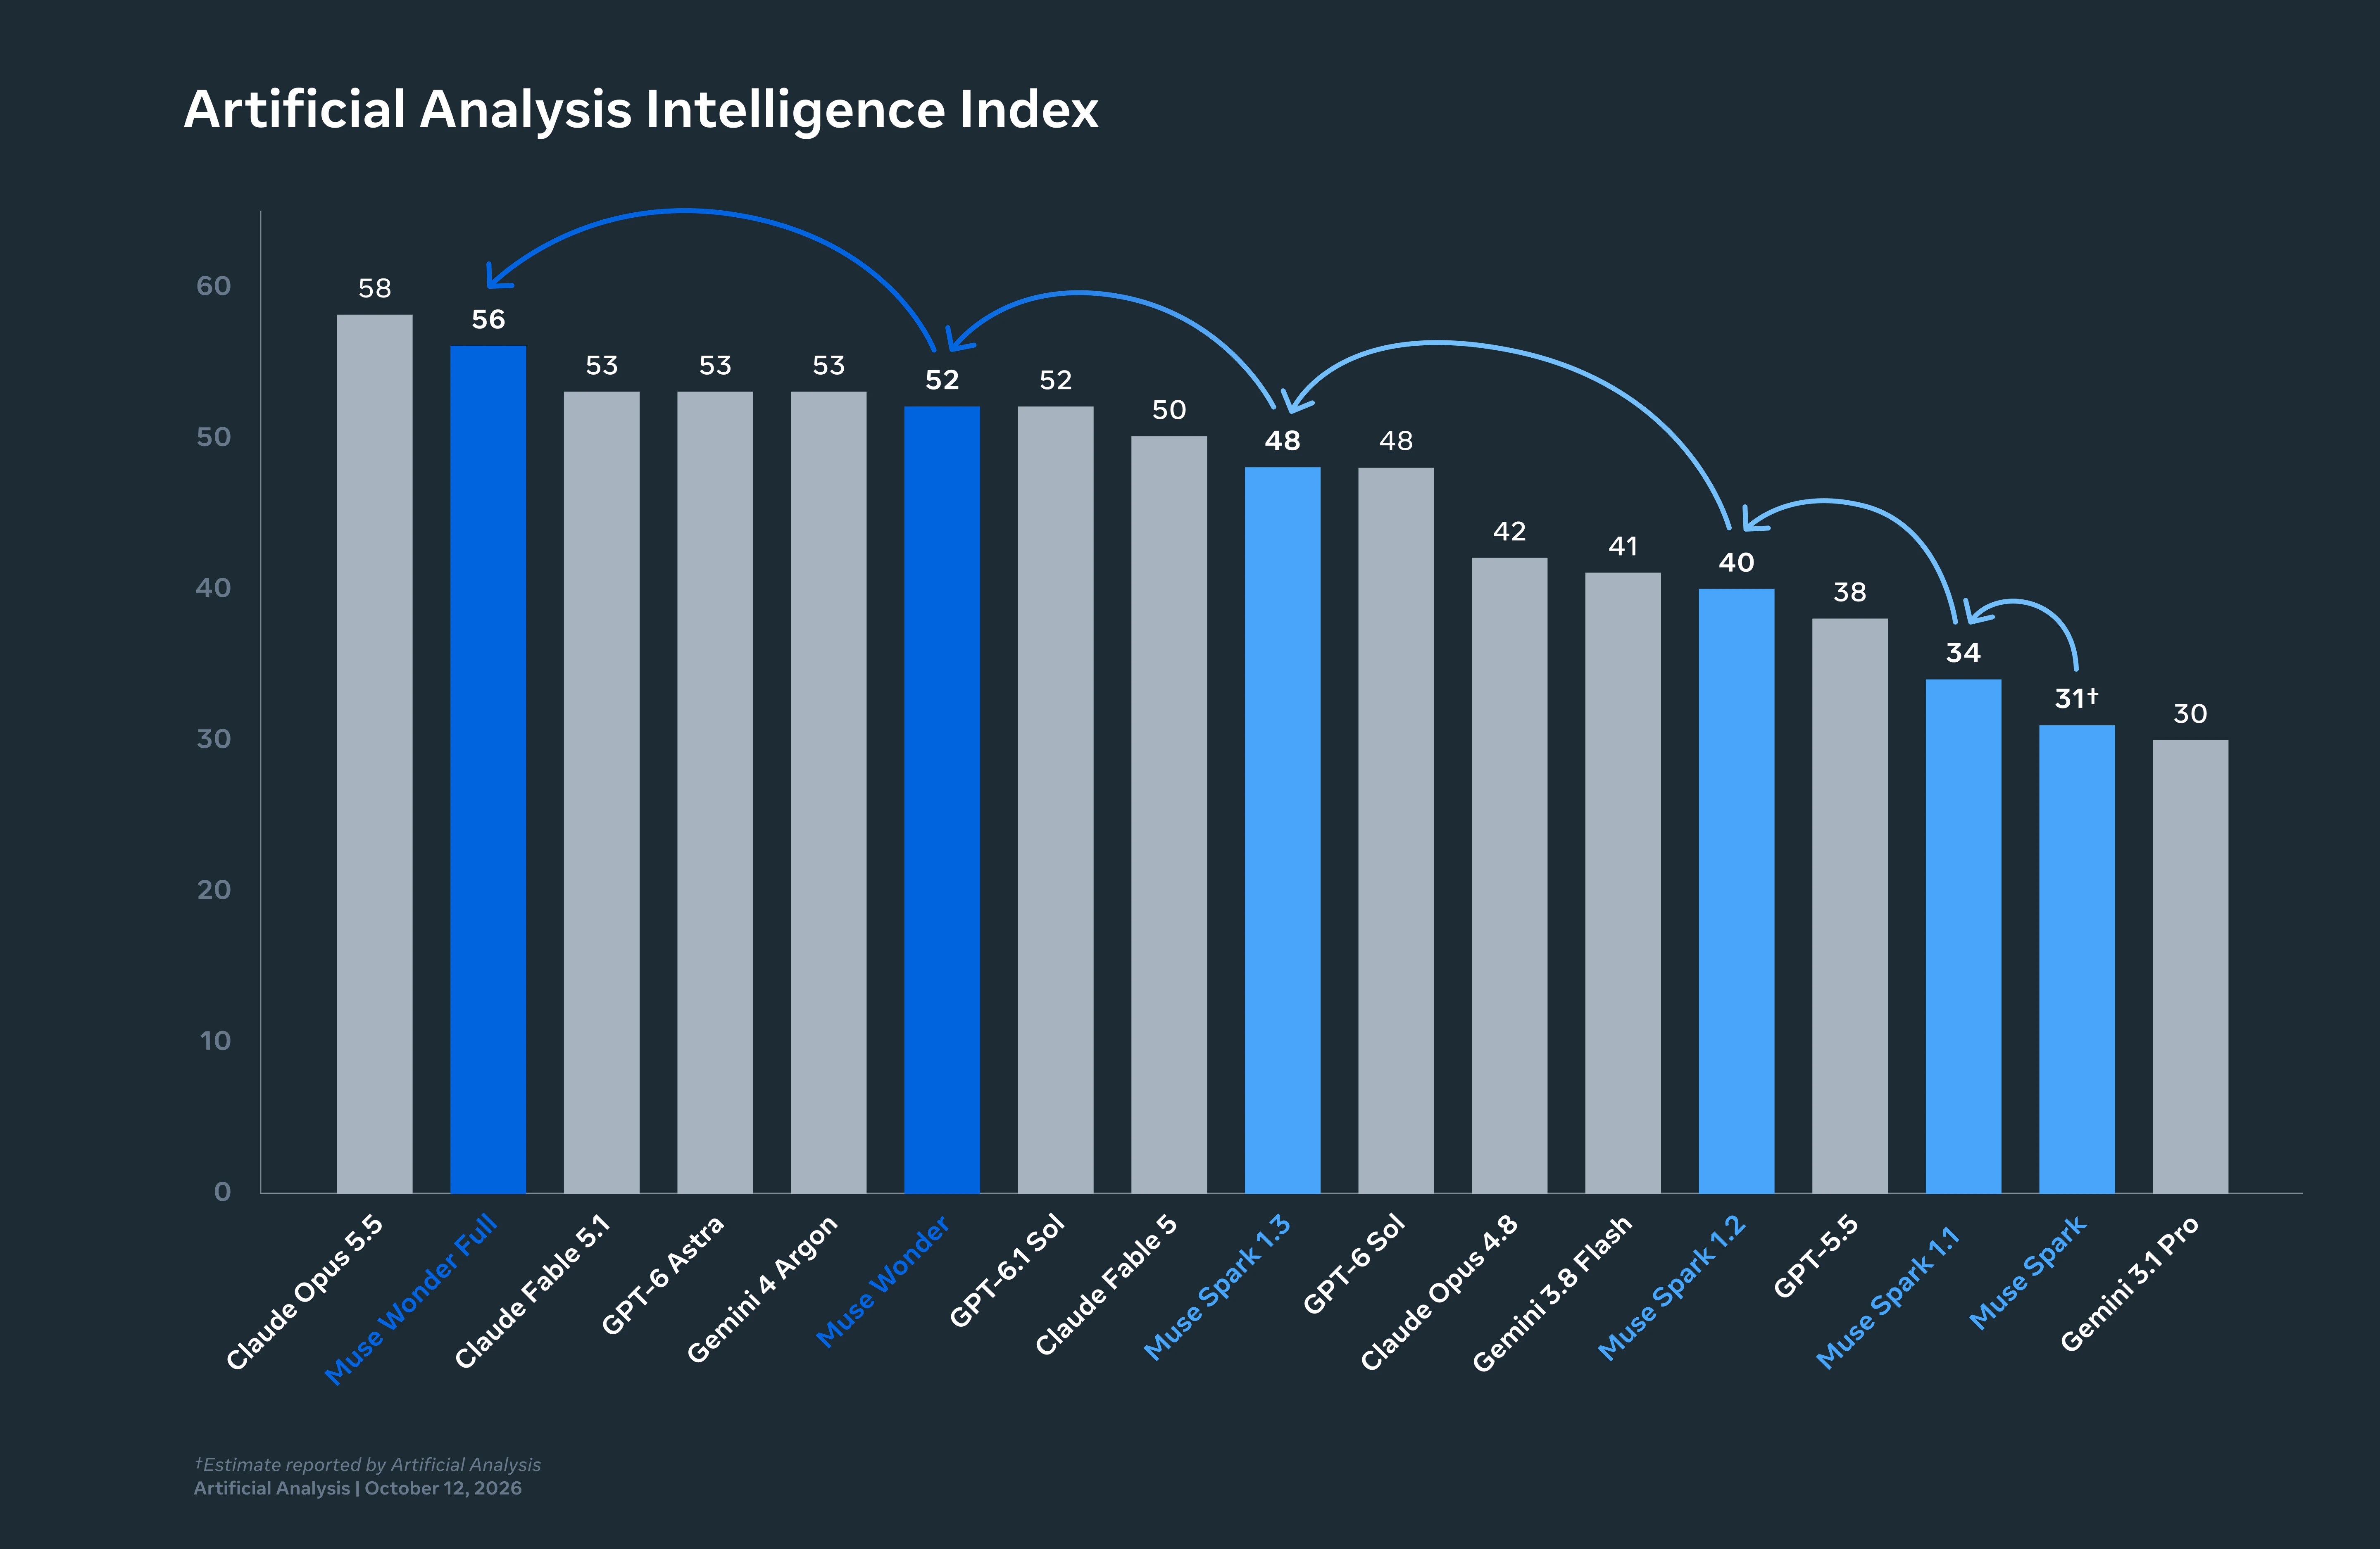
Deux règles pratiques en découlent. D'abord, réglez max_output_tokens généreusement à effort élevé ; à max, le raisonnement représente une grande part de la sortie et un plafond trop serré tronque la réponse. Ensuite, journalisez reasoning_tokens par type de requête pour voir ce que coûte chaque niveau sur votre trafic plutôt que sur un benchmark. Les exécutions d'Artificial Analysis qui notent le modèle à 52 ont utilisé l'effort max et environ 54 000 tokens de sortie par tâche.
Sur l'API Responses, vous pouvez demander un résumé du raisonnement avec reasoning.summary réglé sur auto, concise ou detailed. Les résumés ne sont pas garantis ; le tableau peut revenir vide. Le raisonnement brut n'est jamais renvoyé.
Étape 4 : porter l'état d'un tour à l'autre
L'API Responses propose deux modes, et ils ne peuvent pas être combinés.
Stateless encrypted replay est la recommandation de Meta. Envoyez store: false et include: ["reasoning.encrypted_content"], conservez les éléments reasoning que la réponse renvoie et repassez-les au tour suivant avec leur encrypted_content et un champ summary (un tableau vide convient). Le raisonnement du modèle survit au tour sans que Meta ne stocke quoi que ce soit.
Server-managed history est plus simple : passez previous_response_id et n'envoyez que la nouvelle entrée. Notez que instructions n'est pas reporté, donc renvoyez vos instructions système à chaque requête.
first = client.responses.create(model="muse-wonder-1.0", input="Summarize this API's auth flow: ...", instructions="You are an API reviewer.")
second = client.responses.create(model="muse-wonder-1.0", previous_response_id=first.id, instructions="You are an API reviewer.", input="Now list the endpoints that need an OAuth scope.")
Étape 5 : outils, sortie structurée et recherche web
Les function tools suivent le format OpenAI sur Responses et Chat Completions. Muse Wonder appelle les outils en parallèle et est entraîné à se remettre d'appels d'outils échoués, ce qui est l'un des sens du terme Active Focus dans l'annonce de lancement de Meta. Définissez les outils avec un schéma JSON, exécutez les éléments function_call que le modèle renvoie et renvoyez des éléments function_call_output.
Pour une réponse que votre code peut analyser, réglez text.format sur un schéma JSON sur Responses. Pour une information à jour, ajoutez la recherche hébergée de Meta avec tools=[{"type": "web_search"}] ; elle est facturée $2.50 pour 1 000 requêtes en plus des tokens. Si vous testez déjà des appels d'outils pour d'autres modèles, le harnais d'appels d'outils pour agents d'Apidog fonctionne ici sans changement : la forme de la requête est la même que celle d'OpenAI.
Étape 6 : streamer ou exécuter en arrière-plan
Réglez stream: true et consommez le flux d'événements : response.created, response.output_item.added, response.output_text.delta, response.function_call_arguments.delta et response.completed Un échec se termine par response.failed. Les résumés de raisonnement arrivent sous forme de response.reasoning_summary_text.delta quand ils sont demandés.
Pour les longs travaux, envoyez background: true. L'API accuse réception avec "status": "queued", et vous interrogez ou streamez les événements de cycle de vie depuis GET /v1/responses/{id}?stream=true. Background ne peut pas être combiné avec stream: true sur le POST, le corps de la requête est plafonné à 1 MiB, et il existe une limite distincte de 600 nouvelles soumissions en arrière-plan par minute et par équipe. Annulez avec POST /v1/responses/{id}/cancel.
Étape 7 : mettre en cache ce qui se répète
L'entrée en cache coûte $0.20 par million, soit 95 % de moins que le tarif de $4, et Meta la déclare dans usage.input_tokens_details.cached_tokens. Le schéma qui la mérite est le même que chez les autres fournisseurs : placez le matériel stable (instructions système, définitions d'outils, documents de référence) au début et le contenu propre à la requête à la fin. Le guide du prompt caching détaille la conception du préfixe. Surveillez aussi le côté écriture de cache : dans l'exécution d'Artificial Analysis, $1.92 des $4.52 de coût par tâche de Wonder étaient des écritures de cache, plus que les $1.44 de hits de cache.
Tester l'API Muse Wonder dans Apidog
Un projet Apidog partagé garde la clé hors des fils de discussion et donne à chacun les mêmes requêtes.
- Créez un environnement nommé Meta Model API avec une
base_urldehttps://api.meta.ai/v1etMODEL_API_KEYcomme variable secrète Les valeurs secrètes sont masquées dans l'interface et jamais exportées. - Ajoutez trois requêtes, une par endpoint, chacune avec
Authorization: Bearer {{MODEL_API_KEY}}. Dupliquez la requête Responses aux effortslow,mediumetmaxpour comparer les coûts côte à côte. - Ajoutez des assertions sur l'usage. Ajoutez des assertions JSONPath sur
$.usage.output_tokens_details.reasoning_tokenset$.usage.input_tokens_details.cached_tokens. Une valeur de cached tokens à zéro sur une requête censée toucher le cache signale un bug de préfixe, intercepté avant qu'il n'atteigne la production. - Mockez le 429. La documentation de Meta conseille un back-off exponentiel avec jitter à partir d'environ 500 ms et le respect de
Retry-After. Pointez votre client vers un mock Apidog qui renvoie un 429 avec cet en-tête et prouvez la logique de réessai avant de partager une limite de 3 000 requêtes par minute avec le reste de votre équipe. - Exécutez le tout en CI avec la CLI Apidog, pour qu'un changement de modèle ou de tarif fasse échouer un pipeline plutôt qu'un client.
Téléchargez Apidog et importez les trois endpoints depuis les exemples de requêtes ci-dessus.
Questions fréquentes
L'API Muse Wonder a-t-elle un niveau gratuit ? Non. La facturation se fait au token sans minimum, donc une poignée d'appels de test coûte quelques centimes, mais il n'y a aucun crédit gratuit. Le guide d'accès gratuit passe en revue les voies les moins chères.
Mes données d'API servent-elles à l'entraînement ? Pas en mode Standard de l'API. Les abonnements Muse Code sont en mode Contributor par défaut, qui utilise vos données ; ce réglage se trouve dans Muse Code, pas dans l'API.
Puis-je utiliser Muse Wonder Full via l'API ? Non. Il n'a aucun ID de modèle appelable ni de prix au token. Seuls les abonnés Muse Code Power et Maximum peuvent le sélectionner.
Quelles sont les limites de débit et puis-je les relever ? 3 000 requêtes et 4 millions de tokens par minute et par modèle, comptés sur toutes les clés de votre équipe. La page tarifaire de Meta ne liste ni paliers ni procédure d'augmentation. L'article sur les limites de débit explique comment rester en dessous.
Prochaine étape
Passez les trois appels ci-dessus aux efforts low, medium et max sur une tâche réelle de votre produit, et comparez reasoning_tokens avant de choisir un niveau par défaut. C'est ce chiffre, et non l'accroche à $4, que votre facture suivra.