
GLM-5.2 là một trong những mô hình mã nguồn mở mạnh mẽ nhất mà bạn có thể chạy hiện nay, và giấy phép MIT mở có nghĩa là "miễn phí" thực sự khả dụng. Vấn đề là "miễn phí" và "dễ dàng" không phải là một đối với mô hình mixture-of-experts khoảng 753B. Hướng dẫn này sẽ chỉ ra các cách thực tế, từ tự lưu trữ hoàn toàn miễn phí đến tín dụng dùng thử gần như miễn phí và mức phí trả thấp nhất, kèm theo các ghi chú trung thực về phần cứng và giới hạn.
Nếu bạn muốn tóm tắt: nếu bạn có phần cứng (hoặc thuê GPU giá rẻ), hãy tự lưu trữ mã nguồn mở. Nếu không, hãy sử dụng tín dụng dùng thử của z.ai hoặc gói GLM Coding Plan cấp thấp nhất. Không có tùy chọn OpenRouter miễn phí cho glm-5.2, vì vậy đừng tìm kiếm.
Cây quyết định nhanh
Chọn hàng của bạn và chuyển đến phần đó.
| Tình huống của bạn | Cách tốt nhất | Chi phí thực tế |
|---|---|---|
| Bạn sở hữu một máy chủ GPU mạnh (hoặc có thể thuê) | Tự lưu trữ mã nguồn mở (Ollama / vLLM) | $0 cho mã nguồn; điện hoặc thuê GPU |
| Bạn muốn thiết lập bằng 0 và không cần thẻ thanh toán | z.ai tín dụng dùng thử miễn phí / cấp giới hạn tốc độ | Miễn phí cho đến khi hết tín dụng (xác minh ưu đãi hiện tại) |
| Bạn muốn con đường trả phí đáng tin cậy rẻ nhất | GLM Coding Plan Lite, hoặc API giá đầu vào được lưu trữ | ~3-6 USD/tháng (xác minh) hoặc vài xu mỗi cuộc gọi |
| Bạn muốn trả tiền theo mức sử dụng mà không cần cam kết | API OpenRouter | 1.40 USD / 1M đầu vào, 4.40 USD / 1M đầu ra |
Quy tắc chung: hoàn toàn miễn phí có nghĩa là tự lưu trữ. Gần như miễn phí có nghĩa là tín dụng dùng thử hoặc gói Lite.
Cách 1: Tự lưu trữ mã nguồn mở MIT (hoàn toàn miễn phí)
GLM-5.2 được phát hành theo giấy phép MIT không giới hạn khu vực, vì vậy bạn có thể tải xuống các trọng số và chạy chúng trên phần cứng của riêng mình mà không phải trả tiền cho bất kỳ ai. Các trọng số có sẵn trên Hugging Face tại zai-org/GLM-5.2.
Phần trung thực: đây là một mô hình MoE khoảng 753B tham số ở định dạng BF16. Mặc dù chỉ một phần nhỏ các tham số đó được kích hoạt cho mỗi token, nhưng toàn bộ tập trọng số vẫn phải nằm trong bộ nhớ. Ở BF16, đó là hơn một terabyte trọng số thô. Bạn không thể chạy cái này trên máy tính xách tay. Hầu hết những người tự lưu trữ làm một trong hai điều sau:
- Chạy bản lượng tử hóa (4-bit hoặc tương tự) để giảm dung lượng bộ nhớ, chấp nhận đánh đổi một chút về chất lượng.
- Thuê một phiên bản đa-GPU theo giờ từ nhà cung cấp đám mây và tắt nó khi hoàn tất.
Vì vậy, "miễn phí" ở đây có nghĩa là miễn phí chi phí cấp phép. Bạn vẫn phải trả tiền cho phần cứng, điện hoặc thuê GPU. Đối với hầu hết các cá nhân, một bản dựng lượng tử hóa trên máy trạm VRAM cao hoặc một phiên thuê ngắn là con đường thực tế.
Chạy GLM-5.2 với Ollama
Ollama là trình chạy cục bộ thân thiện nhất. GLM-5.2 có sẵn trong thư viện Ollama, quy trình thực hiện gồm hai lệnh:
# Kéo mô hình (mong đợi một bản tải xuống rất lớn)
ollama pull glm-5.2:cloud
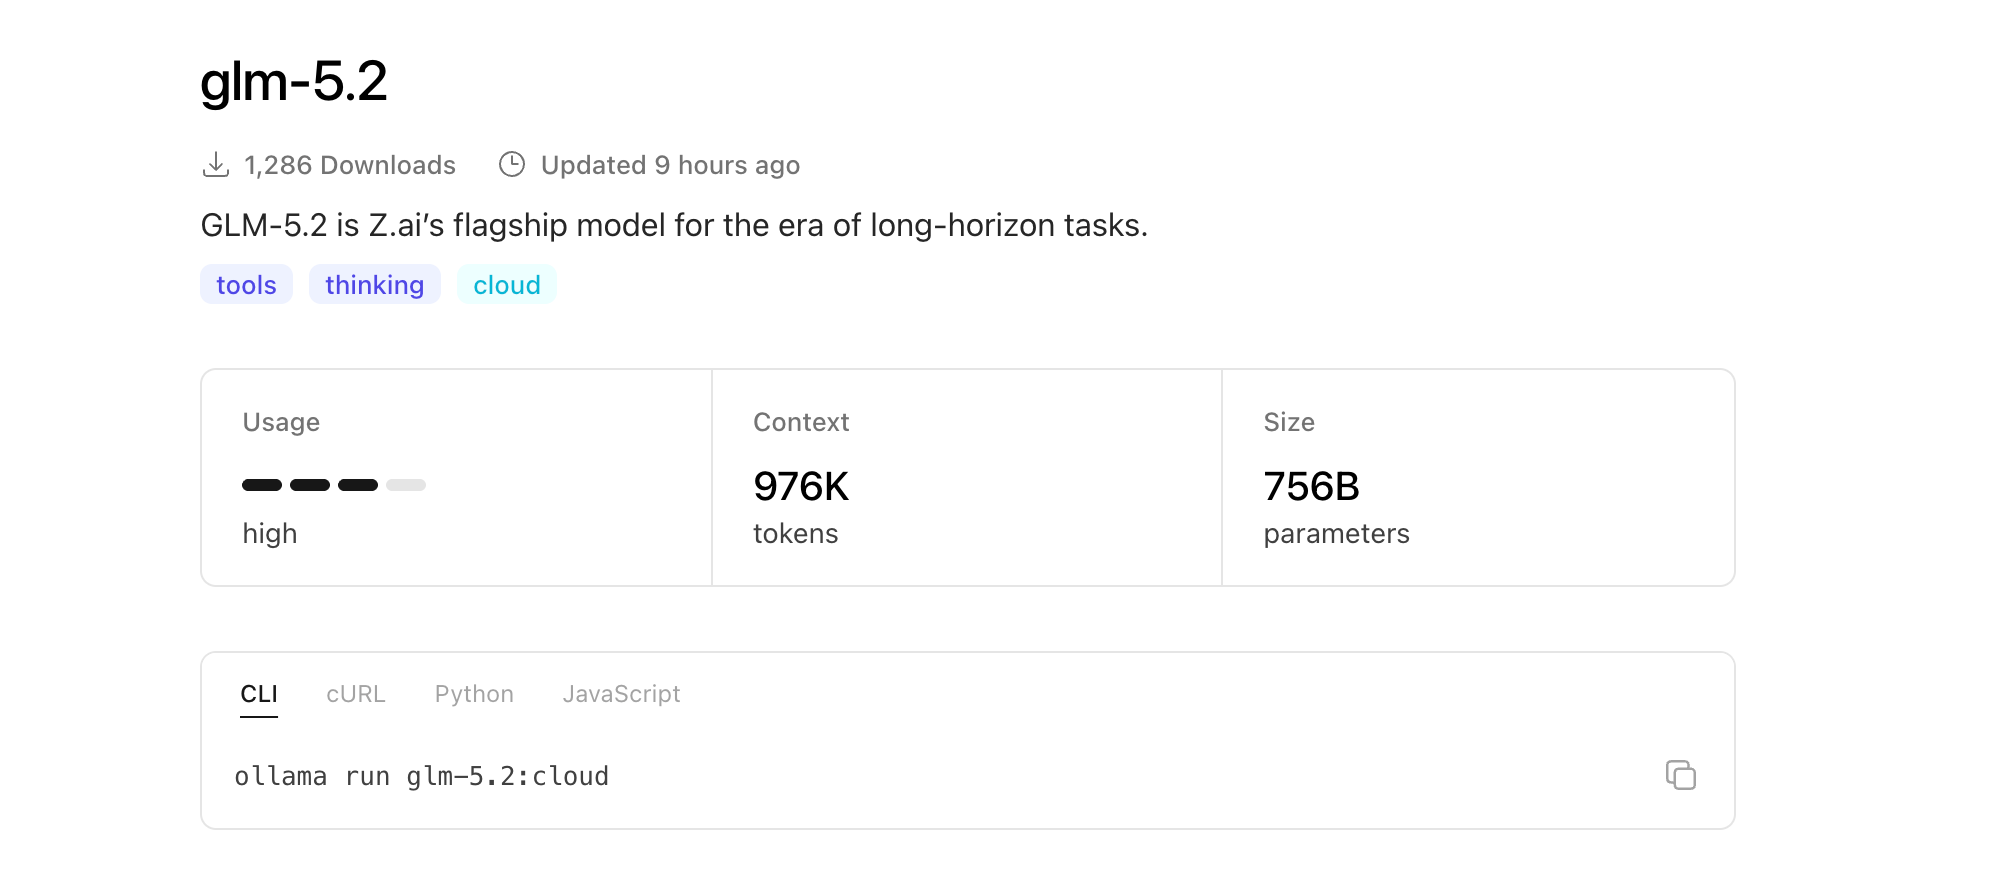
Ollama mặc định sử dụng một biến thể lượng tử hóa, điều này khiến một mô hình có kích thước này trở nên khả thi trên phần cứng tiêu dùng. Bạn cũng có thể truy cập nó qua điểm cuối tương thích OpenAI cục bộ của Ollama:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.2",
    "messages": [{"role": "user", "content": "Write a Python function to parse an RFC 3339 timestamp."}]
  }'
Hãy theo dõi RAM và VRAM của bạn. Nếu mô hình tràn ra ổ đĩa, quá trình tạo sẽ chậm lại đáng kể. Một bản dựng lượng tử hóa cộng với đủ bộ nhớ hợp nhất hoặc chia tách đa-GPU là sự khác biệt giữa khả dụng và không khả dụng.
Nếu bạn muốn hướng dẫn từng bước cục bộ, các mẫu này gần như giống hệt từ thế hệ trước. Xem chạy GLM-5 cục bộ miễn phí và GLM-5 miễn phí với Ollama để biết thiết lập đầy đủ, lựa chọn lượng tử hóa và khắc phục sự cố. Thay đổi thẻ mô hình thành glm-5.2 và quy trình làm việc sẽ giống nhau.
Chạy GLM-5.2 với vLLM
Để đạt được thông lượng và phục vụ nhiều yêu cầu, vLLM là lựa chọn cấp sản xuất. Nó xử lý tính song song của tensor trên các GPU, đây là cách bạn thực sự phù hợp với một MoE 753B.
pip install vllm

python -m vllm.entrypoints.openai.api_server \
  --model zai-org/GLM-5.2 \
  --tensor-parallel-size 8 \
  --max-model-len 131072
Đó --tensor-parallel-size 8 giả định tám GPU. Số lượng chính xác phụ thuộc vào thẻ của bạn và liệu bạn có tải một checkpoint lượng tử hóa hay không. vLLM hiển thị một máy chủ tương thích OpenAI, vì vậy bất kỳ client nào nói định dạng chat-completions đều hoạt động mà không cần thay đổi. Ngữ cảnh 1M token (1.048.576 token) là khả năng nổi bật, nhưng việc giữ bộ nhớ đệm KV một triệu token tốn rất nhiều bộ nhớ, vì vậy hãy đặt --max-model-len theo những gì bạn thực sự cần.
Cách 2: Tín dụng dùng thử miễn phí z.ai và cấp giới hạn tốc độ
Nếu việc tự lưu trữ nằm ngoài khả năng, con đường rẻ tiếp theo là nền tảng riêng của z.ai. Các tài khoản mới thường nhận được tín dụng dùng thử miễn phí và thường có một cấp miễn phí giới hạn tốc độ để thử nghiệm nhẹ (tính đến tháng 6 năm 2026, hãy xác minh ưu đãi hiện tại tại z.ai vì các điều khoản dùng thử thường xuyên thay đổi).
Đây là cách nhanh nhất để dùng thử mô hình thực sự mà không cần thiết lập. Bạn tạo một tài khoản, lấy khóa API và gọi điểm cuối tương thích OpenAI:
curl https://api.z.ai/api/paas/v4/chat/completions \
  -H "Authorization: Bearer $ZAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.2",
    "messages": [{"role": "user", "content": "Explain IndexShare sparse attention in two sentences."}],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "max"
  }'
Một vài điểm đặc biệt của GLM-5.2 đáng biết trong khi bạn sử dụng các tín dụng đó:
thinkingbật hoặc tắt khả năng suy luận. Đối với lập trình, z.ai khuyên dùng mức độ nỗ lực suy luận Tối đa thông quareasoning_effort: "max". Có hai mức nỗ lực, Cao và Tối đa.- Độ dài đầu ra được ghi nhận là lên tới 128K theo tài liệu của z.ai, nhưng hãy coi đó là một con số cần xác minh trực tiếp hơn là một đảm bảo cứng, vì các nguồn thứ cấp không phải lúc nào cũng liệt kê nó.
Tín dụng dùng thử sẽ hết. Khi hết, bạn sẽ chuyển sang gói trả phí hoặc quay lại tự lưu trữ. Chi tiết tham số đầy đủ có trong hướng dẫn GLM-5.2 của z.ai.
Cách 3: Các mức trả phí rẻ nhất (gần như miễn phí)
Khi hết tín dụng miễn phí, có hai con đường giúp chi phí của bạn gần như bằng không.
Gói GLM Coding Plan Lite
Nếu mục đích sử dụng chính của bạn là lập trình, GLM Coding Plan là lựa chọn đáng giá. Gói Lite cấp thấp nhất có giá khoảng 12 USD/tháng (tính đến tháng 6 năm 2026, hãy xác minh giá hiện tại tại z.ai vì các cấp độ được công bố có sự mâu thuẫn giữa các nguồn). Với gói này, bạn có quyền truy cập lập trình với mức phí cố định hàng tháng thay vì tính theo token, giúp việc sử dụng nhiều hàng ngày trở nên dễ dự đoán.
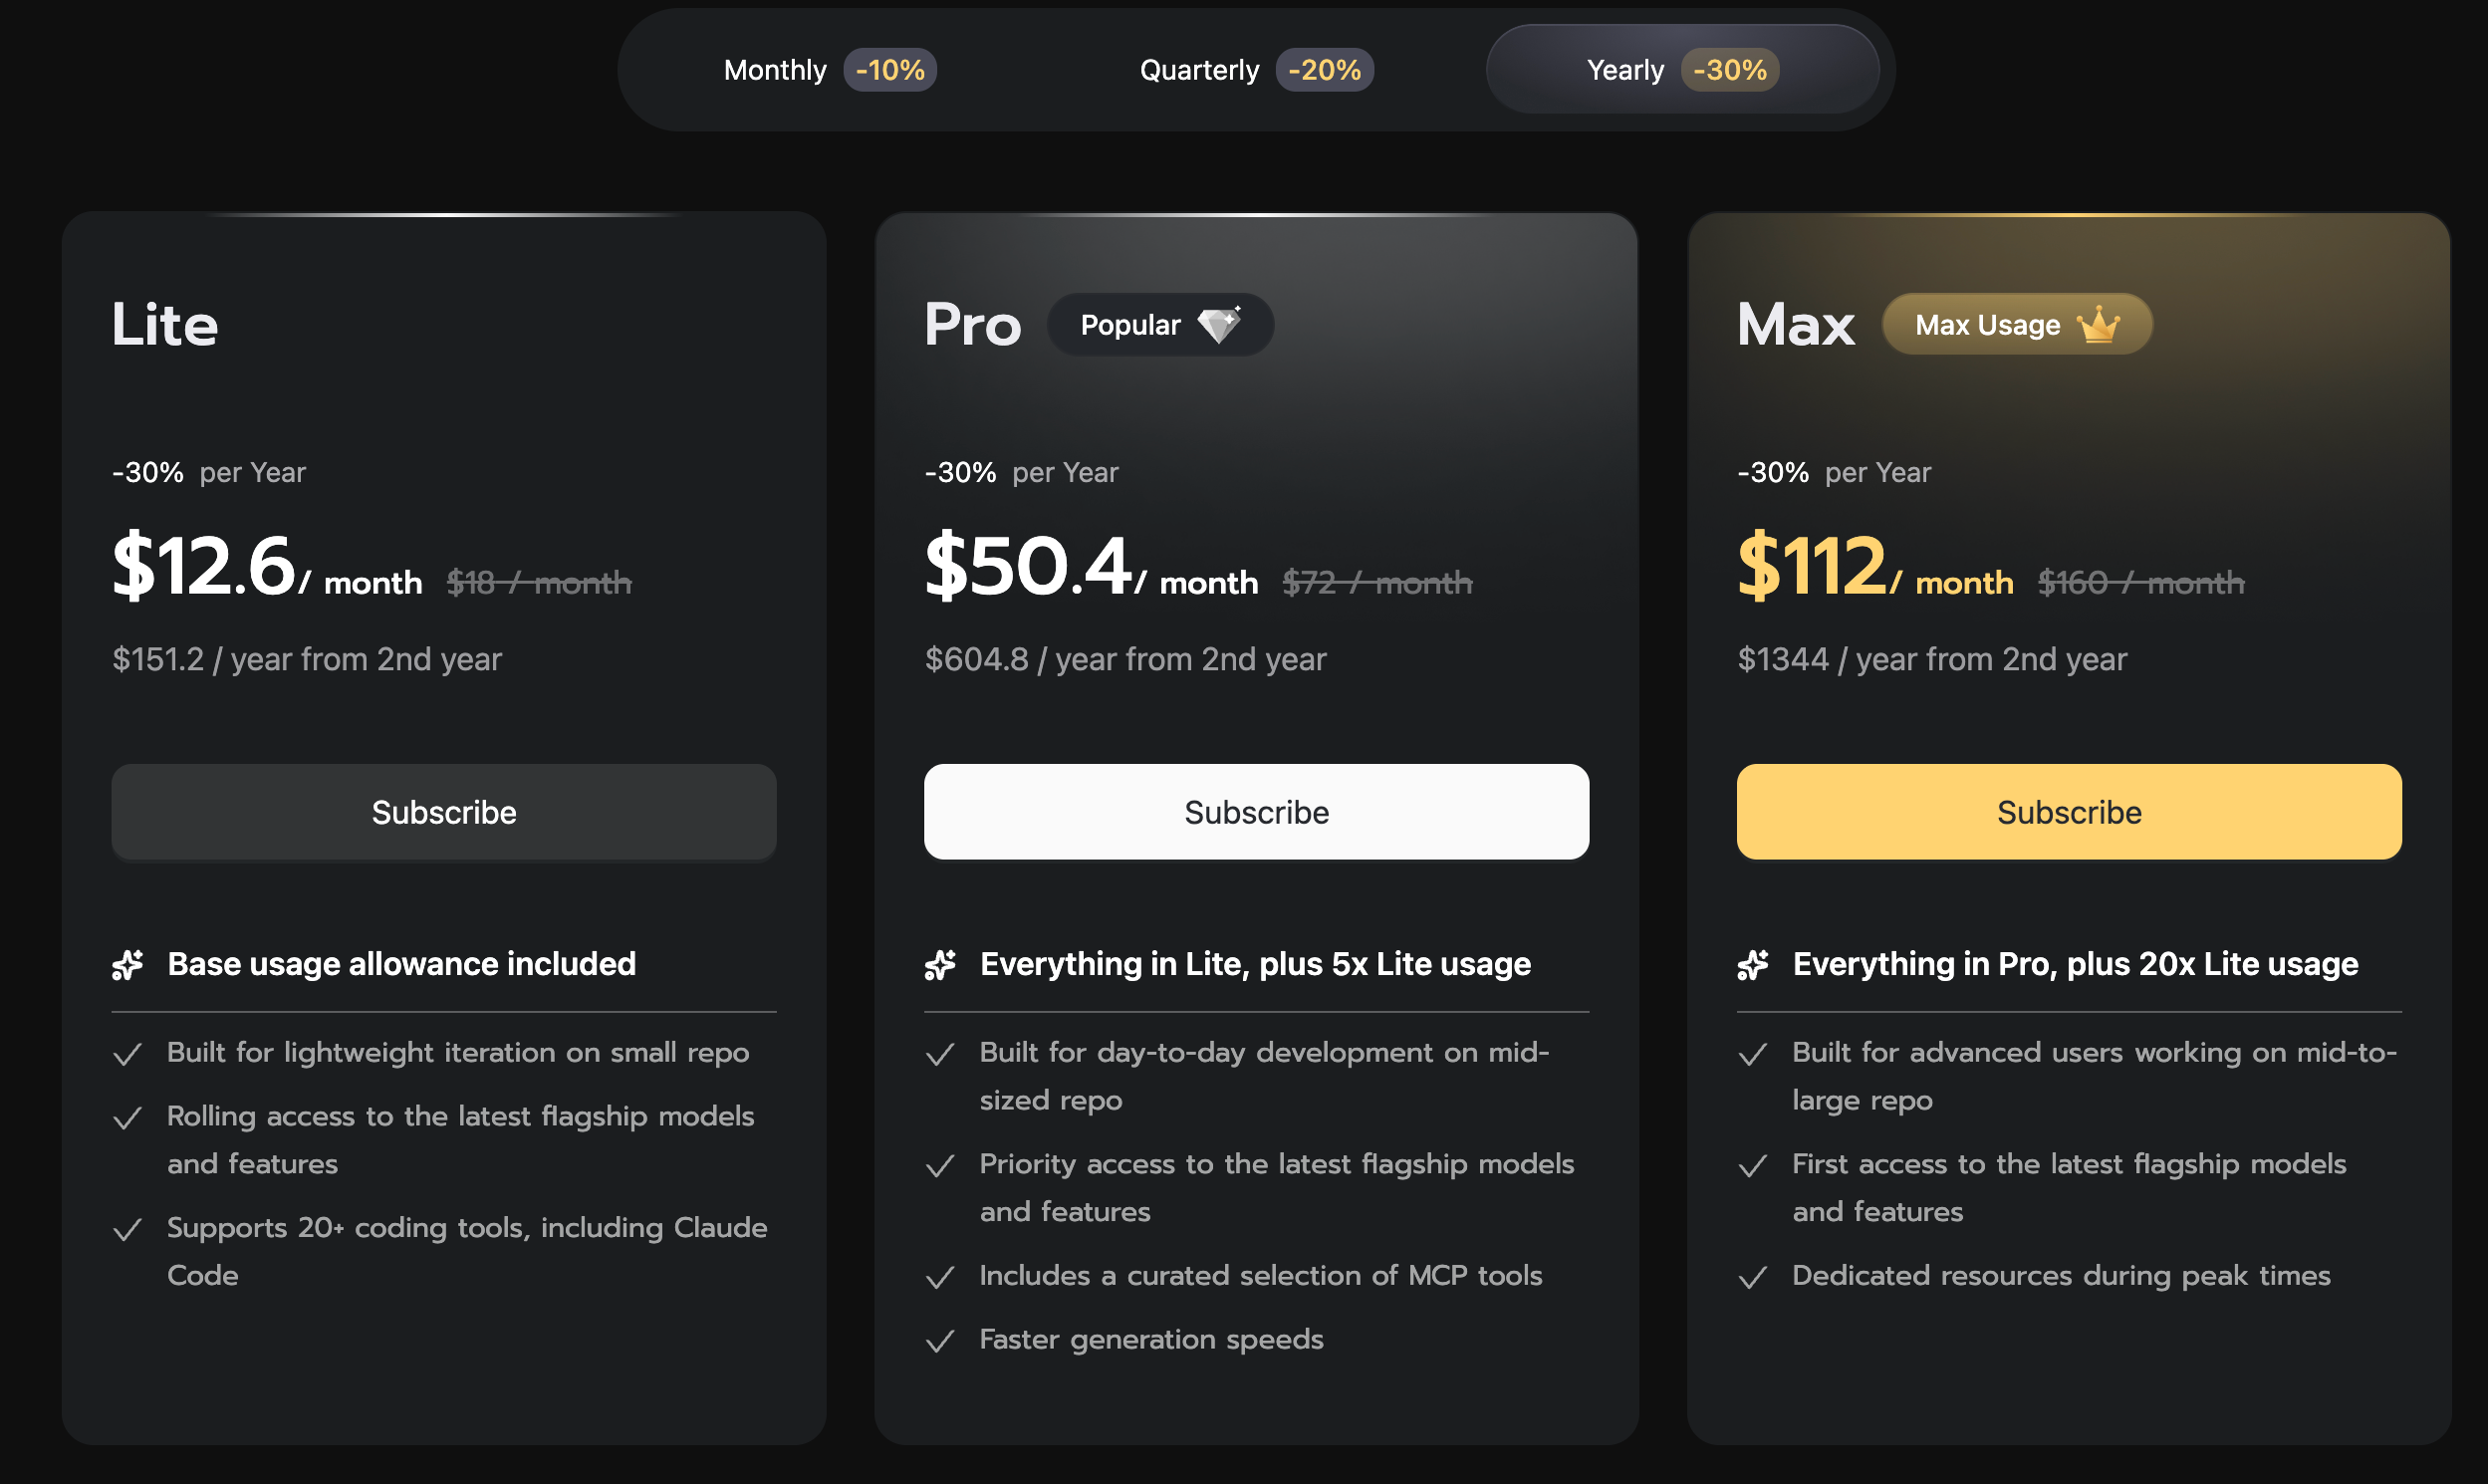
Gói Coding Plan cũng mở khóa đường dẫn tương thích với Anthropic, vì vậy bạn có thể trỏ Claude Code, Cline hoặc Cursor đến GLM-5.2. URL cơ sở cho lập trình là https://api.z.ai/api/coding/paas/v4 (một số nguồn hiển thị open.z.ai/api/paas/v4, vì vậy hãy xác minh trực tiếp). Một môi trường Claude Code hoạt động sẽ trông như thế này:
export ANTHROPIC_BASE_URL="https://api.z.ai/api/coding/paas/v4"
export ANTHROPIC_API_KEY="your-glm-coding-plan-key"
export ANTHROPIC_DEFAULT_SONNET_MODEL="glm-5.2[1m]"
export ANTHROPIC_DEFAULT_OPUS_MODEL="glm-5.2[1m]"
export CLAUDE_CODE_AUTO_COMPACT_WINDOW=1000000
export API_TIMEOUT_MS=3000000
Hậu tố [1m] chọn biến thể ngữ cảnh 1M. Đặt API_TIMEOUT_MS cao, nếu không Claude Code sẽ hủy các cuộc gọi ngữ cảnh lớn và dài trước khi chúng kết thúc. Để có hướng dẫn chi tiết hơn về công cụ đại lý, hãy xem GLM-5.2 với Claude Code, Cline và Cursor và hướng dẫn GLM-5.1 với Claude Code của thế hệ trước.
Giá đầu vào được lưu trữ và trả tiền theo mức sử dụng
Để truy cập API mà không cần đăng ký, API tổng quát tiêu chuẩn có giá 1.40 USD cho mỗi 1M token đầu vào và 4.40 USD cho mỗi 1M token đầu ra, được xác nhận bởi OpenRouter. Mức giá tương tự áp dụng cho dù bạn gọi trực tiếp z.ai hay qua OpenRouter dưới dạng trả tiền theo mức sử dụng.
Mẹo gần như miễn phí ở đây là đầu vào được lưu trữ. Được báo cáo vào khoảng 0.26 USD cho mỗi 1M token (theo VentureBeat, gán nguồn tương ứng), đầu vào được lưu trữ giúp giảm đáng kể chi phí cho các ngữ cảnh lặp lại, như một lời nhắc hệ thống dài hoặc một cơ sở mã cố định mà bạn truy vấn nhiều lần. Nếu khối lượng công việc của bạn tái sử dụng cùng một tiền tố, bạn sẽ trả toàn bộ giá một lần và một phần nhỏ sau đó. Đối với lập trình tầm xa, VentureBeat lưu ý GLM-5.2 “đánh bại GPT-5.5 về lập trình tầm xa với chi phí chỉ bằng khoảng một phần sáu,” đây là lập luận kinh tế trong một câu.
Một lần nữa, rõ ràng: không có cấp OpenRouter miễn phí nào cho glm-5.2. OpenRouter rẻ, không miễn phí. Nếu một hướng dẫn nào đó nói khác, thì nó sai.
Miễn phí so với gần như miễn phí: so sánh trung thực
| Tuyến đường | Chi phí ban đầu | Chi phí duy trì | Nỗ lực thiết lập | Tốt nhất cho |
|---|---|---|---|---|
| Tự lưu trữ (Ollama/vLLM) | Phần cứng hoặc thuê | Điện / Giờ GPU | Cao | Quyền riêng tư, không tính phí theo mức sử dụng, kiểm soát hoàn toàn |
| z.ai tín dụng dùng thử | Không | Miễn phí cho đến khi hết tín dụng | Thấp | Thử nghiệm ban đầu, kiểm tra nhanh |
| GLM Coding Plan Lite | ~3-6 USD/tháng (xác minh) | Cố định hàng tháng | Thấp | Lập trình hàng ngày trong Claude Code/Cline/Cursor |
| API + đầu vào được lưu trữ | Không | 1.40 USD/4.40 USD mỗi 1M; ~0.26 USD cho dữ liệu lưu trữ | Thấp | Ứng dụng, khối lượng công việc có ngữ cảnh lặp lại |
Một mô hình hữu ích: xác thực ý tưởng của bạn bằng tín dụng dùng thử, sau đó quyết định. Nếu bạn sẽ chạy nó hàng ngày và đó là lập trình, hãy chọn gói Lite. Nếu bạn cần quyền riêng tư hoặc muốn thoát khỏi việc thanh toán theo token hoàn toàn, hãy đầu tư vào việc tự lưu trữ. Nếu bạn đang xây dựng một sản phẩm với ngữ cảnh có thể tái sử dụng, API có bộ nhớ đệm là mức phí đáng tin cậy rẻ nhất.
Kiểm tra điểm cuối GLM-5.2 miễn phí của bạn với Apidog
Bất kể bạn chạy GLM-5.2 bằng cách nào, miễn phí hay trả phí, bạn sẽ muốn xác nhận điểm cuối thực sự hoạt động trước khi kết nối nó vào ứng dụng của mình. Cho dù đó là máy chủ Ollama cục bộ, một phiên bản vLLM hay API đám mây z.ai, phản hồi là một tải trọng chat-completions dạng streaming mà bạn cần kiểm tra.
Apidog là một nền tảng API tất cả trong một dành cho mục đích này. Bạn có thể gửi yêu cầu đến điểm cuối GLM-5.2 của mình, xem các Sự kiện gửi từ máy chủ (Server-Sent Events) được hiển thị theo thời gian thực, lưu yêu cầu dưới dạng một trường hợp có thể tái sử dụng và mô phỏng phản hồi để giao diện người dùng của bạn có thể xây dựng dựa trên đó trước khi mô hình hoạt động. Trỏ nó đến http://localhost:11434 cho Ollama hoặc đến URL cơ sở của z.ai cho đám mây, đặt tiêu đề Authorization của bạn và bạn sẽ có một bộ công cụ kiểm tra lặp lại trong một phút. Tải Apidog và giữ nó bên cạnh bất kỳ tuyến đường miễn phí nào bạn chọn.
Câu hỏi thường gặp
GLM-5.2 có thực sự miễn phí để sử dụng không? Các trọng số là miễn phí theo giấy phép MIT, vì vậy việc tự lưu trữ không tốn phí cấp phép. Bạn vẫn phải trả tiền cho phần cứng hoặc thuê GPU. API được lưu trữ là trả phí, mặc dù z.ai thường cung cấp tín dụng dùng thử và một cấp giới hạn tốc độ để bắt đầu (xác minh ưu đãi hiện tại).
Tôi có thể chạy GLM-5.2 miễn phí với Ollama trên máy tính xách tay thông thường không? Thực tế là không. Đây là một mô hình MoE khoảng 753B, và ngay cả một bản dựng lượng tử hóa cũng cần bộ nhớ nghiêm túc. Ollama giúp các lệnh dễ dàng, nhưng yêu cầu phần cứng cao. Một máy trạm VRAM cao, một máy Mac có bộ nhớ hợp nhất lớn hoặc một GPU thuê là những gì bạn cần. Xem nghiên cứu sâu cục bộ để biết kích thước.
Có cấp OpenRouter miễn phí nào cho GLM-5.2 không? Không. OpenRouter cung cấp GLM-5.2 dưới dạng trả tiền theo mức sử dụng với giá 1.40 USD đầu vào và 4.40 USD đầu ra cho mỗi 1M token. Nó rẻ, không miễn phí. Đừng tin bất kỳ nguồn nào tuyên bố có tùy chọn OpenRouter miễn phí.
Cách trả phí rẻ nhất để sử dụng GLM-5.2 cho lập trình là gì? Gói GLM Coding Plan Lite, khoảng 3-6 USD/tháng tính đến tháng 6 năm 2026 (xác minh tại z.ai). Nó cung cấp quyền truy cập lập trình với mức phí cố định và mở khóa điểm cuối tương thích Anthropic cho Claude Code, Cline và Cursor.
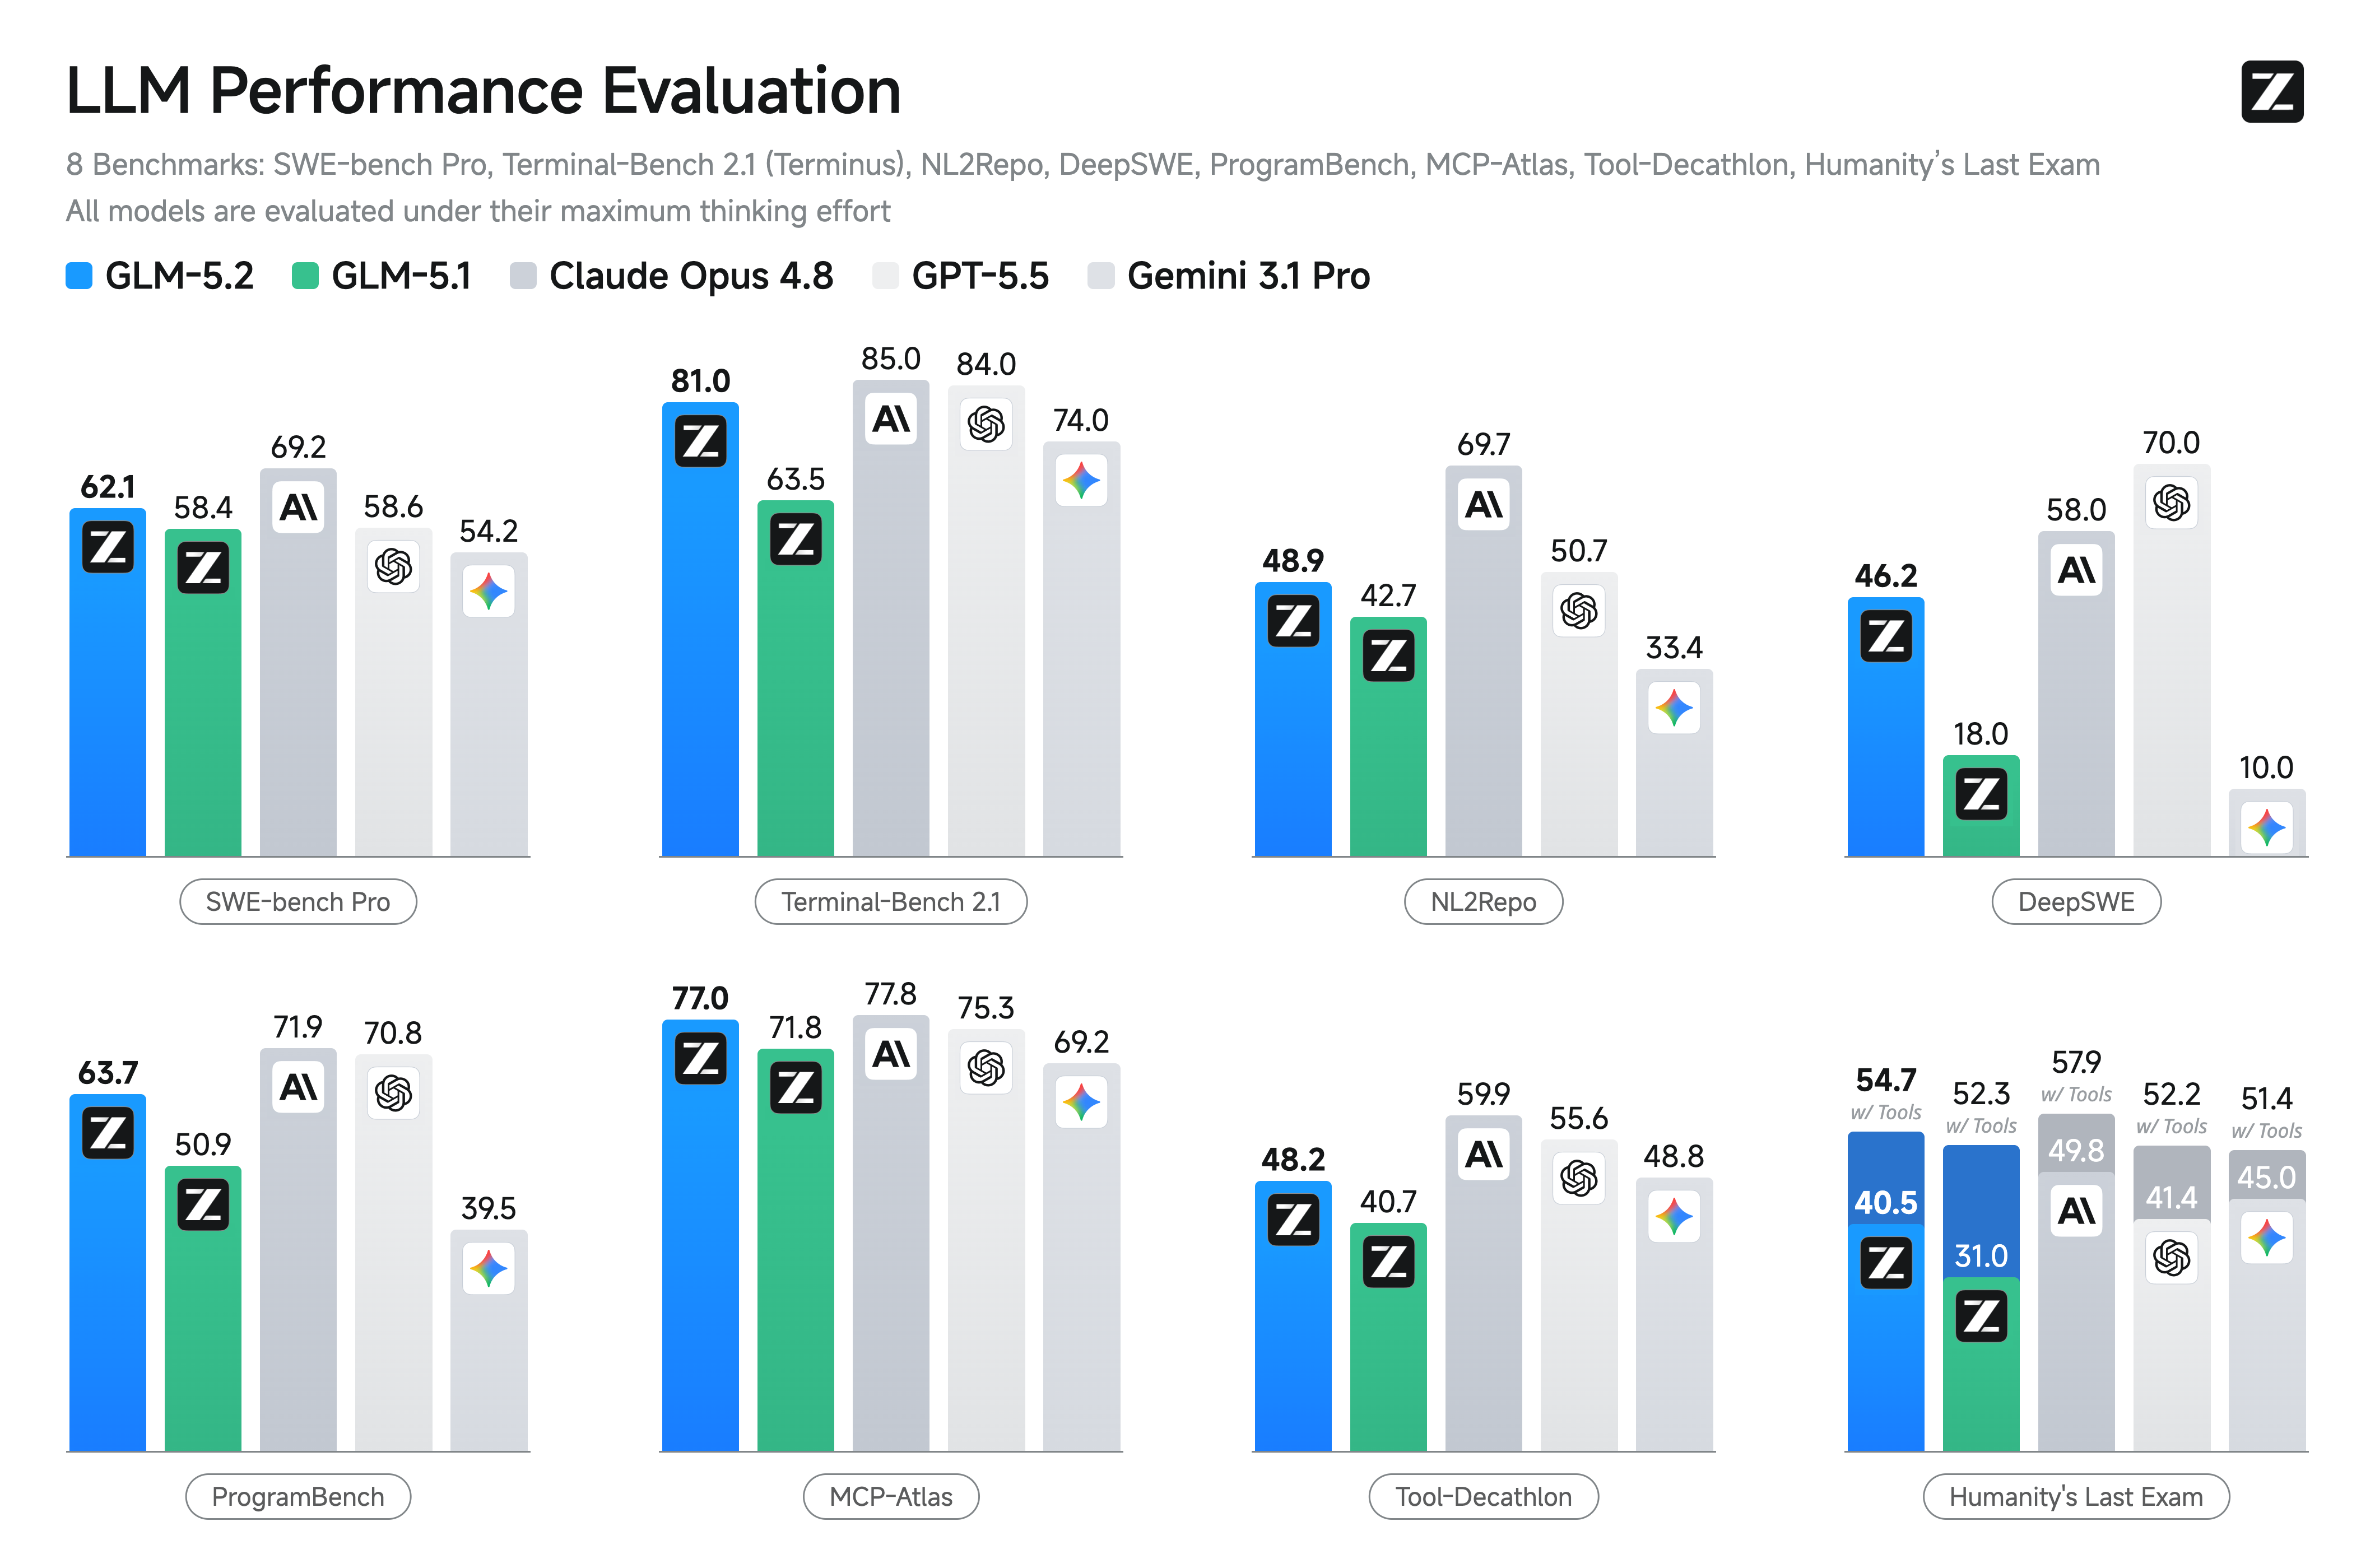
GLM-5.2 so với GPT-5.5 về chi phí như thế nào? Theo VentureBeat, GLM-5.2 đánh bại GPT-5.5 trên một số điểm chuẩn lập trình tầm xa với chi phí chỉ bằng khoảng một phần sáu. Để biết số liệu đầy đủ, hãy xem phân tích điểm chuẩn GLM-5.2 và so sánh trực tiếp.
Nên đi đâu tiếp theo
Tuyến đường rẻ nhất phụ thuộc hoàn toàn vào phần cứng của bạn và tần suất bạn sẽ chạy nó. Tự lưu trữ thắng về quyền riêng tư và không tính phí theo mức sử dụng nếu bạn có thể đáp ứng yêu cầu bộ nhớ. Tín dụng dùng thử và gói Lite thắng về sự tiện lợi. API với đầu vào được lưu trữ thắng cho các ứng dụng tái sử dụng ngữ cảnh.
Nếu bạn vẫn đang quyết định liệu GLM-5.2 có phải là mô hình phù hợp hay không, hãy bắt đầu với GLM-5.2 là gì và cách nó so sánh với GLM-5.1. Khi bạn sẵn sàng xây dựng dựa trên nó, hướng dẫn API GLM-5.2 và phân tích giá sẽ bao gồm phần còn lại, và Apidog xử lý việc kiểm tra ở giữa.