
Claude Fable 5.1 é o mais novo modelo de nível Fable da Anthropic, lançado em 1º de setembro de 2026, juntamente com seu gêmeo de acesso restrito, Claude Mythos 5.1. Ele substitui o Claude Fable 5 com o mesmo custo de $10 por milhão de tokens de entrada e $50 por milhão de tokens de saída, com uma mudança de preço que importa para agentes: as leituras do cache de prompt agora custam $0.25 por milhão de tokens, um quarto do que o Fable 5 cobrava. A Anthropic o posiciona “para raciocínio exigente e trabalho agêntico de longo horizonte,” e sua documentação ainda recomenda começar com o Opus 5 e recorrer ao Fable 5.1 apenas quando o Opus 5, com maior esforço, não for suficiente.
Este guia é o mapa para todo o lançamento: especificações, a história do preço da leitura do cache, as afirmações de benchmark da Anthropic e o peso que merecem, as três mudanças na API que quebram o código do Fable 5, os cinco recursos adicionais, o acesso ao plano e o teto honesto. Cada requisição neste cluster é HTTP simples com JSON, então você pode construí-las e inspecioná-las no Apidog antes que toquem o código da aplicação. A publicação de lançamento da Anthropic e a página do modelo Fable 5.1 são as fontes primárias.
Cada seção se conecta a um aprofundamento focado: o passo a passo da API, o cálculo de custos e a migração do Fable 5 e Opus 5.
Claude Fable 5.1 em um relance
| Especificação | Valor |
|---|---|
| ID do modelo da API | claude-fable-5-1 (sem sufixo de data) |
| Lançado | 1º de setembro de 2026 |
| Compromisso de desativação | Não antes de 1º de setembro de 2027 |
| Janela de contexto | 1.000.000 tokens, padrão e máximo, preço padrão em toda a janela |
| Saída máxima | 128.000 tokens na Messages API |
| Preço base | $10 por milhão de tokens de entrada, $50 por milhão de tokens de saída |
| Leituras de cache | $0.25 por milhão de tokens (0.025x entrada base; todos os outros modelos Claude são 0.1x) |
| API em lote | $5 de entrada, $25 de saída por milhão de tokens |
| Corte de conhecimento | Junho de 2026 (dados confiáveis e de treinamento) |
| Pensamento | Adaptável, sempre ativo; não pode ser desativado |
| Níveis de esforço | low, medium, high, xhigh, max; padrão para high |
| Latência comparativa | Mais lento que Opus 5 e Sonnet 5 |
| Nível de Prioridade | Não suportado (Fable 5 suportava) |
| Retenção de dados | Retenção de 30 dias exigida; sem retenção zero de dados, a menos que a Anthropic autorize expressamente |
| Disponibilidade | Claude API, Amazon Bedrock, Claude Platform na AWS, Google Cloud, Microsoft Foundry; claude.ai (Pro, Max, Team, Enterprise); Claude Code 2.1.250+ |
Três linhas merecem uma segunda olhada. O corte de junho de 2026 é o mais recente de qualquer modelo Claude; o Opus 5 está em maio de 2026 e o Sonnet 5 em janeiro de 2026. O Nível de Prioridade retrocedeu: o Fable 5 o suportava e o Fable 5.1 não. E a regra de retenção produz um erro confuso: uma requisição de uma organização sem retenção de 30 dias retorna 400 invalid_request_error, então verifique essa configuração antes de depurar um payload.
O que é o Claude Fable 5.1
O Fable 5.1 sucede o Fable 5 no mesmo nível, com o mesmo preço por token, no mesmo tokenizador (introduzido com o Opus 4.7, aproximadamente 30% mais tokens por texto do que os modelos anteriores ao 4.7). A Anthropic chama o Fable 5.1 e o Mythos 5.1 de “o mesmo modelo, mas com diferentes níveis de salvaguardas.” O Fable 5.1 está geralmente disponível. O Mythos 5.1 é oferecido apenas a clientes aprovados no Project Glasswing, através do Cyber Verification Program e do Life Sciences Verification Program, e alimenta o produto Claude Security da Anthropic. A comparação Mythos 5.1 vs Fable 5.1 aborda onde os dois divergem.
Se você acompanhou a história do Fable 5, o contexto importa. O Fable 5 foi suspenso em junho de 2026 sob os controles de exportação dos EUA e retornou em 1º de julho com um classificador de segurança retreinado. O Fable 5.1 mantém essa arquitetura de classificador e as mesmas categorias de recusa, mas a Anthropic relata que os classificadores são acionados com muito menos frequência em trabalhos benignos.
A documentação da Anthropic é direta sobre seu posicionamento: comece com o Opus 5 para a maioria das cargas de trabalho, e use o Fable 5.1 “para raciocínio exigente e trabalho agêntico de longo horizonte, ou quando suas avaliações no Claude Opus 5 com maior esforço ainda ficarem aquém.” A comparação Fable 5.1 vs Opus 5 explora essa regra por carga de trabalho.
A história do preço da leitura de cache
Os preços por token não se moveram. O multiplicador de leitura de cache sim. Todos os outros modelos Claude precificam um acerto de cache em 0.1x da entrada base. O Fable 5.1 e o Mythos 5.1 o precificam em 0.025x, o que corresponde a $0.25 por milhão.
| Modelo | Entrada base | Leitura de cache | Saída |
|---|---|---|---|
| Claude Fable 5.1 | $10 | $0.25 | $50 |
| Claude Fable 5 | $10 | $1.00 | $50 |
| Claude Opus 5 | $5 | $0.50 | $25 |
| Claude Sonnet 5 | $2 | $0.20 | $10 |
Duas consequências. Um acerto de cache do Fable 5.1 é mais barato do que um acerto de cache do Opus 5, mesmo que o preço base do Fable 5.1 seja o dobro. E sessões agênticas longas que relêem um prefixo em cache a cada turno obtêm a maior parte da economia, razão pela qual a Anthropic cita “uma estimativa de 25%” mais barato para cargas de trabalho típicas e “até aproximadamente 45%” para as altamente agênticas. Essas são as estimativas da Anthropic para a sua própria combinação; a análise de preços reproduz os cálculos para que você possa inserir sua própria taxa de acerto de cache. As gravações de cache ($12.50 e $20 por milhão) e o mínimo de cache de 512 tokens permanecem inalterados. Como uma falha agora custa 40 vezes mais que um acerto, manter o cache aquecido é mais importante do que era no Fable 5.
O que a Anthropic diz que os benchmarks mostram
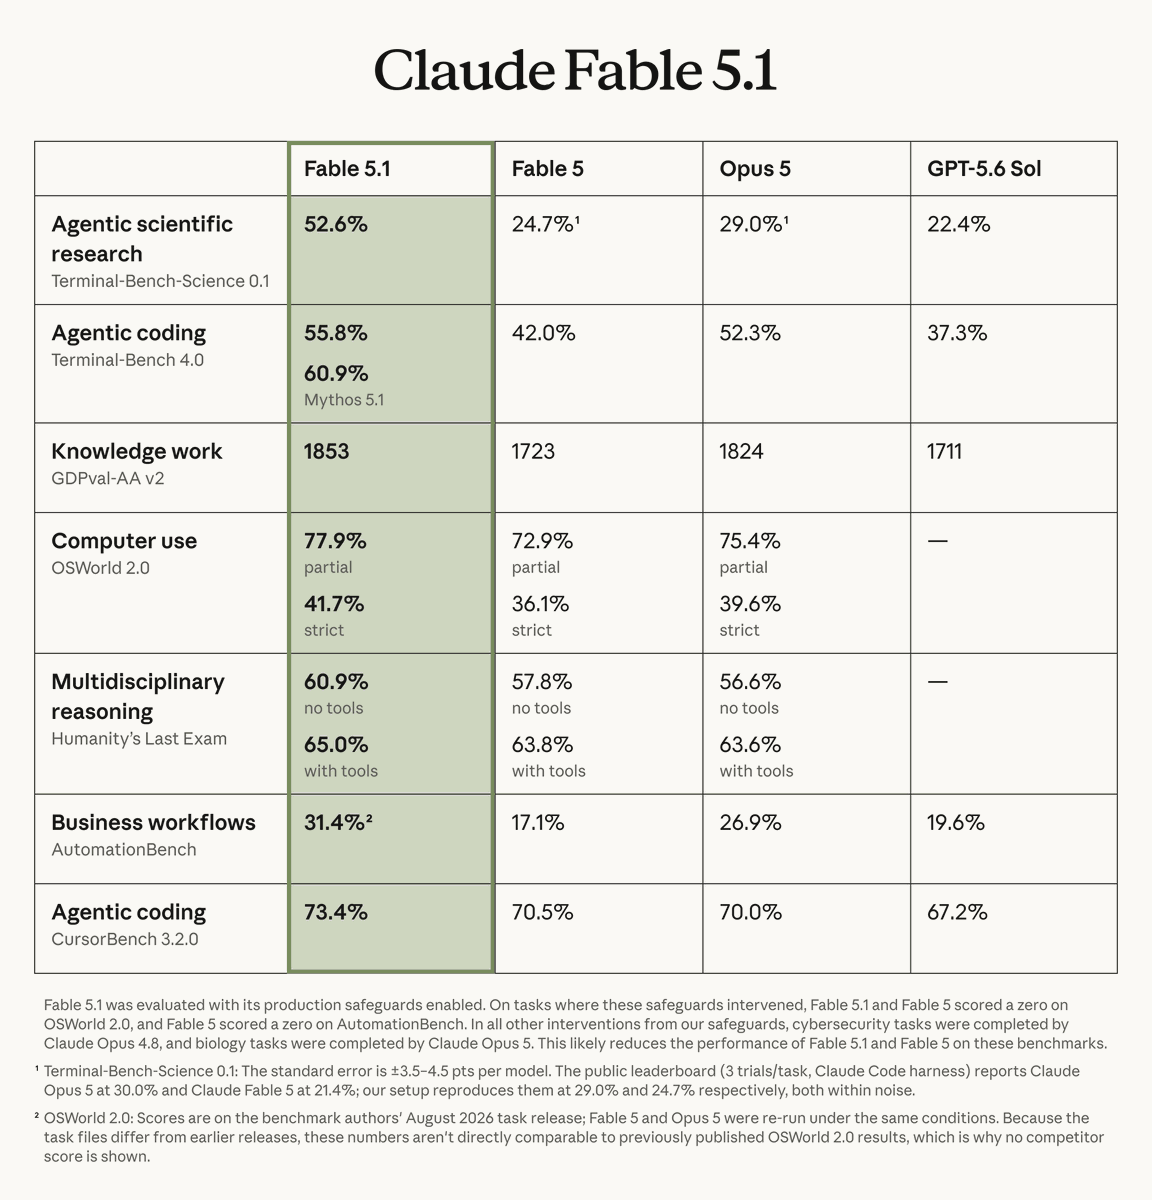
Todos os números são executados pela Anthropic, sem reprodução independente ainda.
| Benchmark | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 52.3% | 37.3% |
| GDPval-AA v2 (trabalho de conhecimento) | 1853 | 1723 | 1824 | 1711 |
| OSWorld 2.0 (crédito parcial) | 77.9% | 72.9% | 75.4% | não reportado |
| OSWorld 2.0 (estrito) | 41.7% | 36.1% | 39.6% | não reportado |
| Último Exame da Humanidade (sem ferramentas) | 60.9% | 57.8% | 56.6% | não reportado |
| Último Exame da Humanidade (com ferramentas) | 65.0% | 63.8% | 63.6% | não reportado |
| AutomationBench | 31.4% | 17.1% | 26.9% | 19.6% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 70.0% | 67.2% |
A Anthropic também relata o Mythos 5.1 com 60.9% no Terminal-Bench 4.0, cinco pontos acima do Fable 5.1, o que é a evidência publicada mais clara de que as salvaguardas custam alguma capacidade na codificação agêntica.
O resultado do Terminal-Bench-Science mais que dobra o Fable 5 e é o número que todas as publicações destacaram. A diferença do CursorBench para o Opus 5 é de 3.4 pontos, uma vantagem real, mas modesta, para um modelo que custa o dobro por token. A análise detalhada dos benchmarks segue linha por linha.
As três mudanças que quebram o código do Fable 5
A migração do Fable 5 é em grande parte direta, mas três coisas retornam erros que o Fable 5 nunca apresentou, todas documentadas em Novidades no Claude Fable 5.1.
- 1. O uso forçado de ferramentas retorna um 400.
tool_choice: {"type": "any"}e{"type": "tool", "name": "..."}são rejeitados comtool_choice: type "tool" and "any" are not supported for this model.A substituição éautomais uma instrução nomeando a ferramenta, comstrict: truena ferramenta se você precisar de argumentos válidos de esquema, ou saídas estruturadas se a chamada forçada existia apenas para obter JSON de volta. - 2. Modelos mais antigos não conseguem ler blocos de pensamento do Fable 5.1. O Fable 5.1 lê blocos do Opus 5, Fable 5 e modelos anteriores. O inverso não é verdadeiro. Quando um roteador, nova tentativa ou fallback de recusa move uma conversa do Fable 5.1 para o Opus 5, a API descarta os blocos, sem cobrança, e o modelo de destino replaneja sem eles.
- 3. Editar turnos anteriores invalida blocos de pensamento. Um bloco de pensamento do Fable 5.1 é válido apenas em relação ao prompt de sistema exato, array de ferramentas e histórico que o precederam. Altere qualquer um deles e a próxima requisição falhará com um 400 dizendo que o bloco está “vinculado a uma conversa diferente”. A verificação é imposta para contas criadas em ou após 31 de agosto de 2026, e a Anthropic a enquadra como uma medida anti-destilação. Se seu código constrói o array
messagespor conta própria, reserve tempo aqui. O guia de pensamento preservado explica o erro, a opção de escapedrop_blocke os padrões de apenas adicionar que mantêm tanto o pensamento quanto o cache intactos.
Todo o resto é mantido: o pensamento não pode ser desativado, o preenchimento retorna um 400, a temperature não padrão retorna um 400, e thinking.display assume o padrão "omitted". O guia de migração contém os trechos antes e depois.
Os cinco recursos adicionais
- Esforço por mensagem (beta). Uma mensagem
role: "system"com conteúdo vazio eoutput_config: {"effort": "low"}altera o esforço a partir do próximo turno do usuário sem invalidar o cache. Cabeçalhomid-conversation-output-config-2026-07-01. - Mensagens de sistema com escopo de turno (beta).
clear_at: "next_user_message"confere a uma mensagem de sistema no meio da conversa autoridade por um turno, e então para de renderizar. Cabeçalhomid-conversation-system-clear-at-2026-08-21. Isso substitui a injeção de um lembrete e sua exclusão na próxima requisição. - Atualizações de progresso entre chamadas de ferramentas (beta).
thinking.display: "updates"retorna as notas do modelo entre as ferramentas como texto, enquanto o raciocínio permanece oculto. Cabeçalhothinking-display-updates-2026-08-18. - Preço de leitura de cache mais baixo. Abordado acima.
- Proveniência de conteúdo. O texto carrega a marca d'água estatística da Anthropic em todas as plataformas; mídias suportadas da sandbox de execução de código carregam credenciais C2PA via Files API. Nosso explicador de marca d'água cobre o mecanismo.
Como o Fable 5.1 se comporta de forma diferente
O guia de prompt da Anthropic lista as mudanças que você notará sem alterar o código. Três afetam as integrações da API: uma chamada de ferramenta por turno em loops de agente longos onde o Fable 5 agrupava várias; menos mensagens de progresso entre as chamadas de ferramentas; e mais respostas da memória com esforço low. O restante são de estilo: prosa mais densa, menos formatação de chat, citações não marcadas em resumos e reescritas de arquivos inteiros. Cada um tem uma correção de um parágrafo, coletada no guia de prompt. Quanto ao esforço, comece em high e refaça sua varredura; a Anthropic afirma que medium se iguala aproximadamente ao Fable 5 com custo mais baixo.
O teto honesto
O Fable 5.1 ainda executa classificadores de segurança. Uma requisição recusada retorna HTTP 200 com stop_reason: "refusal" e um stop_details.category de cyber, bio, frontier_llm, reasoning_extraction, ou general_harms. Os números de melhoria da Anthropic: os classificadores de biologia são acionados 85% menos frequentemente em perguntas benignas do que os do Fable 5 no lançamento, e as salvaguardas cibernéticas causam cerca de 60% menos intervenções por sessão do Claude Code. O Fable 5.1 agora pode identificar vulnerabilidades em códigos que você possui, mas não desenvolverá exploits; isso fica com o Mythos 5.1.
Lide com recusas no código. Os alvos de fallback permitidos são Opus 4.8 e Opus 5, e a configuração mais simples é fallbacks: "default" com o cabeçalho server-side-fallback-2026-07-01. Uma recusa antes de qualquer saída não é cobrada. Nosso guia de tratamento de recusas ainda se aplica, com a ressalva de que o modelo de fallback não pode ler os blocos de pensamento do Fable 5.1. Mais dois limites: o Mythos 5.1 supera o Fable 5.1 onde ambos foram publicados, e os classificadores são mais amplos do que o conjunto apenas cibernético do Opus 5.
Onde você pode executá-lo
O Fable 5.1 está disponível na Claude API como claude-fable-5-1, no Amazon Bedrock como anthropic.claude-fable-5-1, e na Claude Platform na AWS, Google Cloud e Microsoft Foundry como claude-fable-5-1. A configuração em cada um é a mesma do Fable 5, que nosso guia de disponibilidade em nuvem abrange. Nos aplicativos Claude, ele está disponível nas versões Pro, Max, Team e Enterprise, não na Free. O Max inclui modelos Fable para até 50% do limite semanal; o Pro os mede por meio de créditos de uso. O Claude Code precisa da versão 2.1.250 ou posterior. O guia do Claude Code e o guia de caminhos gratuitos e mais baratos contêm os detalhes.
Testando requisições do Fable 5.1 no Apidog
No Apidog, crie um POST para https://api.anthropic.com/v1/messages com os cabeçalhos x-api-key e anthropic-version: 2023-06-01 e este corpo:
{
  "model": "claude-fable-5-1",
  "max_tokens": 16000,
  "output_config": {"effort": "high"},
  "messages": [
    {"role": "user", "content": "Revise este handler de paginação e liste os casos de borda que ele não considera."}
  ]
}
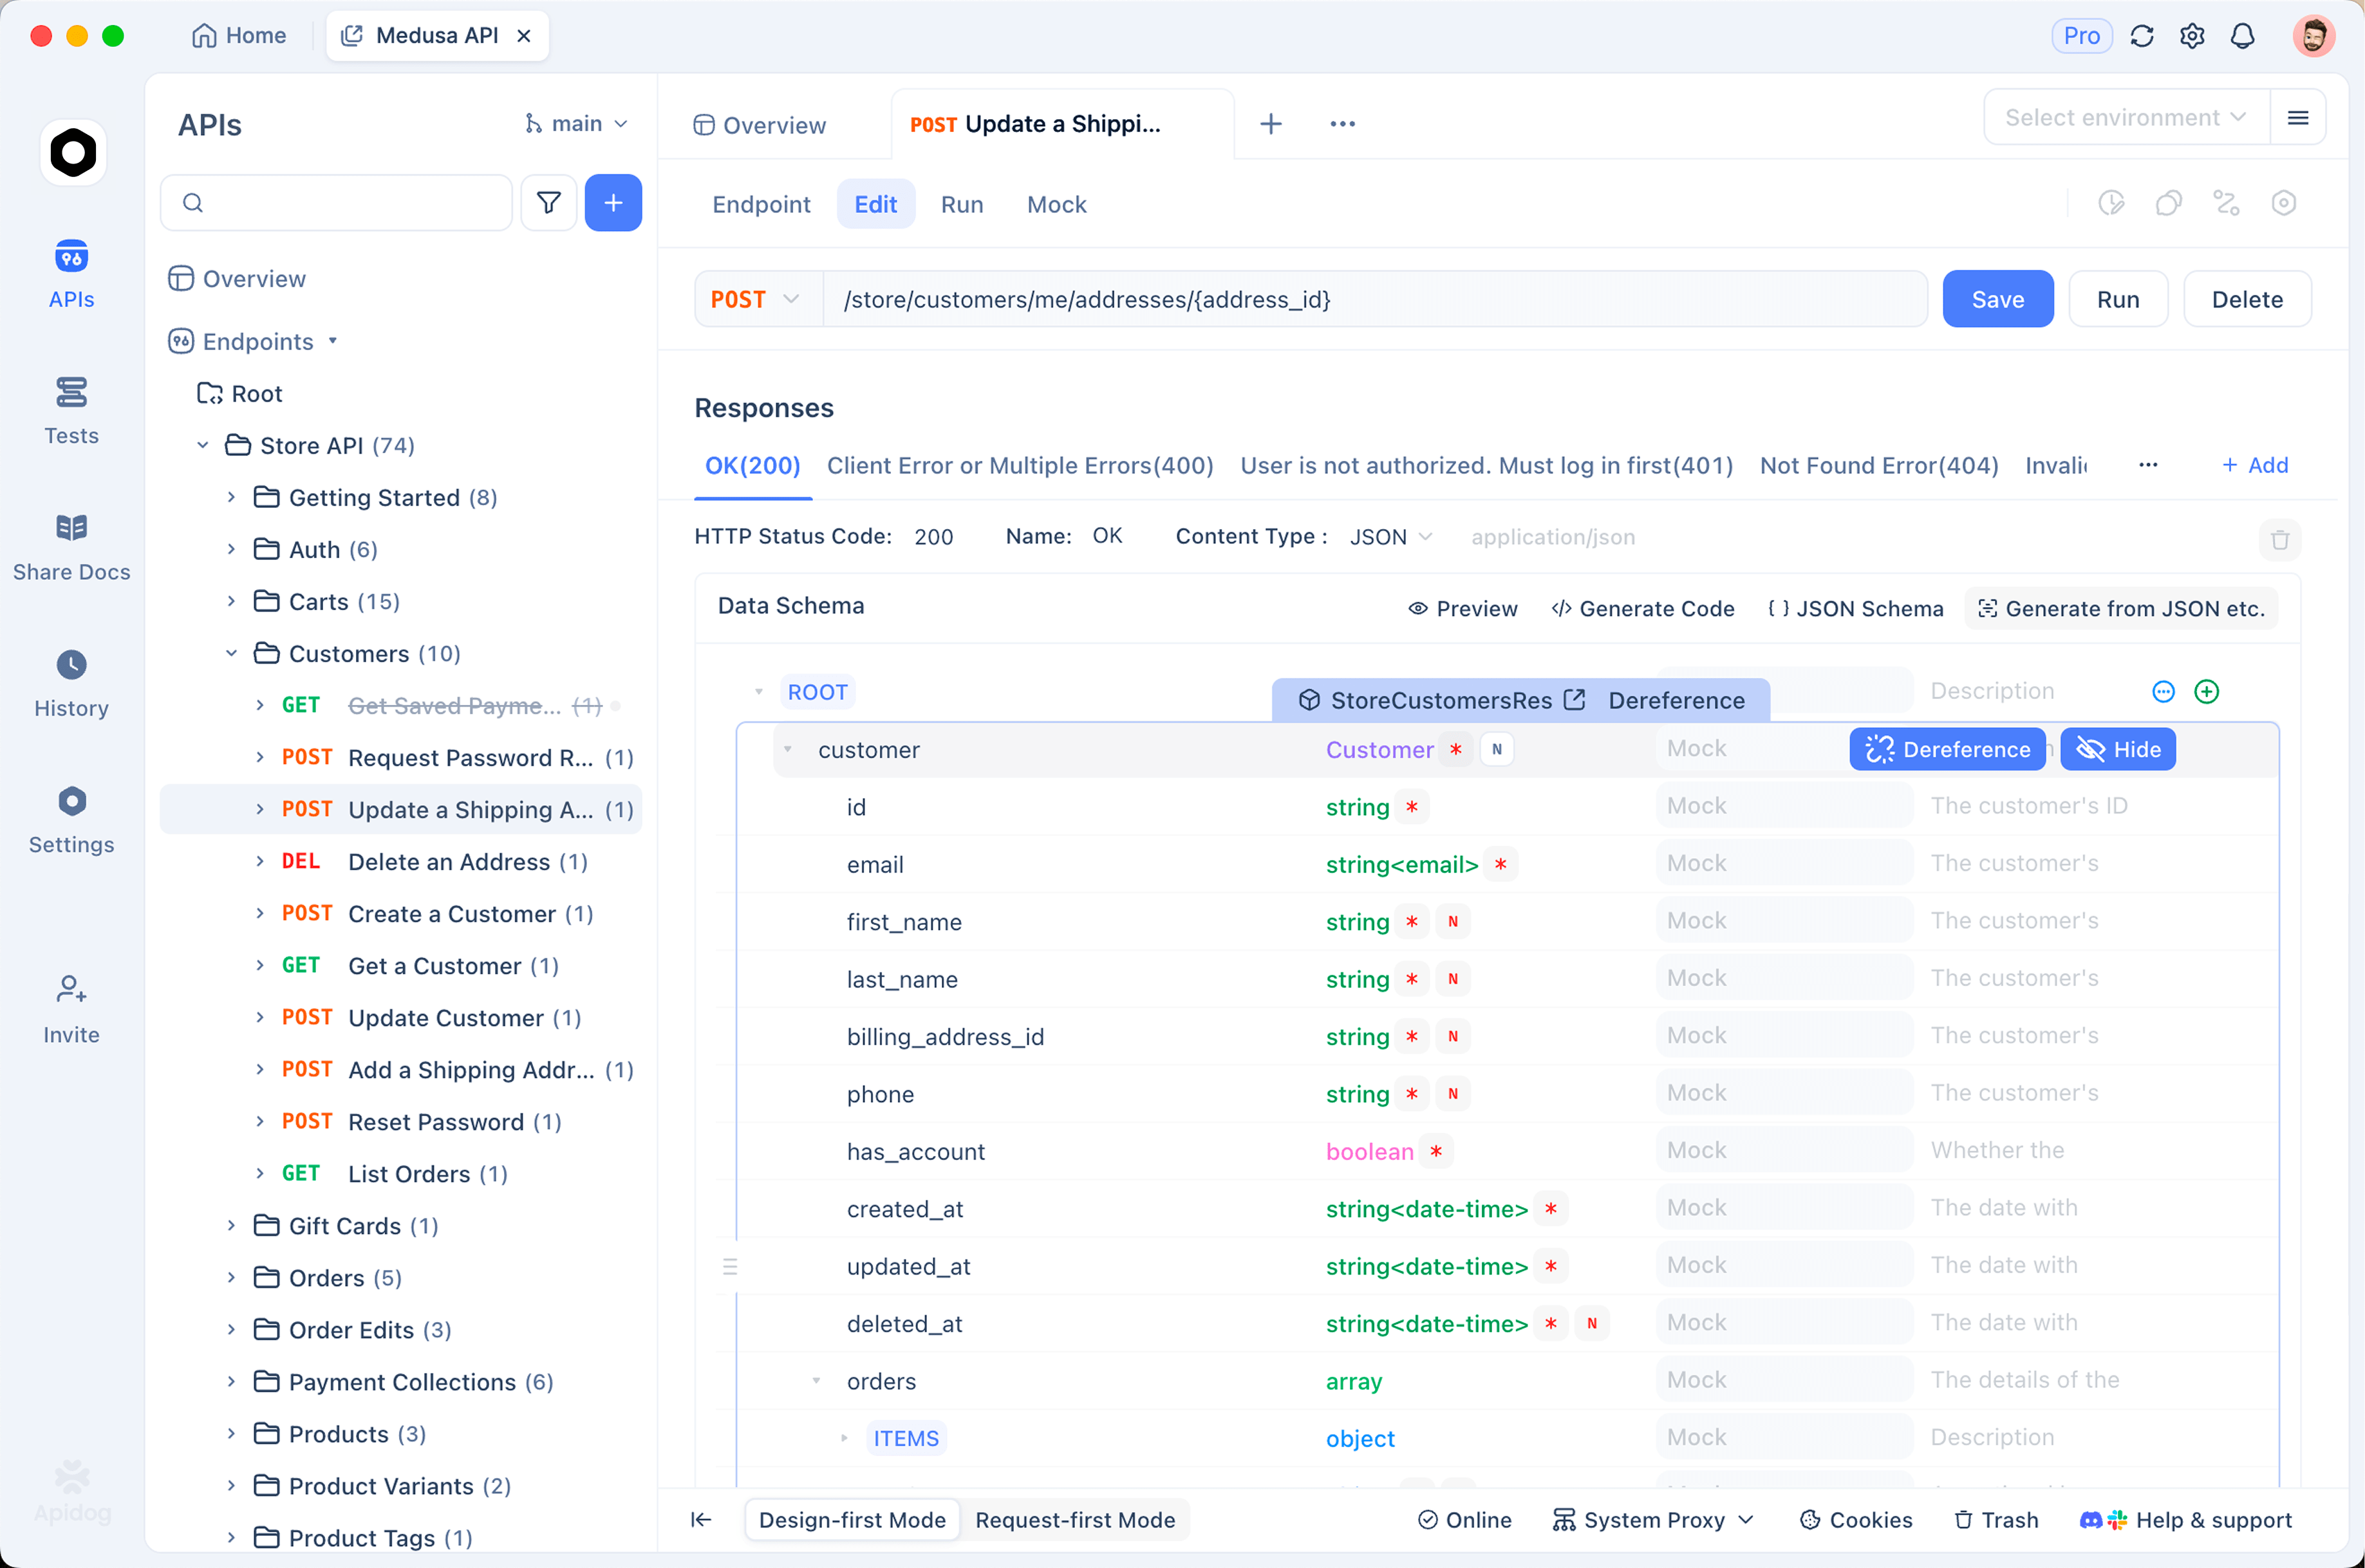
Nenhum campo thinking é necessário. Dê espaço para max_tokens, pois ele limita o pensamento e a resposta juntos. Inspecione stop_reason (ramifique em refusal antes de ler content), o bloco thinking vazio e usage.cache_read_input_tokens no segundo envio, onde a taxa de $0.25 aparece. Baixe o Apidog para salvá-lo como um caso de teste.
Quem deve usar o Claude Fable 5.1
Recorra a ele quando seus agentes rodarem por horas, quando você estiver usando o Fable 5 hoje (mesmo preço, cache mais barato, melhores números; veja a comparação Fable 5.1 vs Fable 5), quando o Opus 5 em xhigh ainda falhar, ou quando você precisar de conhecimento até junho de 2026. Mantenha-se onde está quando o Nível de Prioridade for crítico, quando sua organização tiver retenção zero de dados, quando seu sistema editar o histórico de conversas, ou quando a carga de trabalho for barata e de alto volume, onde o Opus 5 ou o Sonnet 5 são suficientes.
FAQ
Qual é o ID do modelo para Claude Fable 5.1? A string exata claude-fable-5-1. No Amazon Bedrock, use anthropic.claude-fable-5-1.
Quanto custa o Claude Fable 5.1? $10 por milhão de tokens de entrada e $50 por milhão de tokens de saída, o mesmo que o Fable 5. As leituras de cache custam $0.25 por milhão, uma redução de $1. O processamento em lote é de $5 e $25. Sem modo rápido, sem Nível de Prioridade.
O Claude Fable 5.1 é melhor que o Fable 5? Em todos os benchmarks publicados pela Anthropic, sim, com os maiores ganhos no Terminal-Bench-Science (52.6% vs 24.7%) e no AutomationBench (31.4% vs 17.1%). Esses são resultados executados pelo fornecedor.
O que quebra quando mudo do Fable 5? O tool_choice forçado retorna um 400, modelos mais antigos não conseguem ler blocos de pensamento do Fable 5.1, e a edição de turnos anteriores invalida blocos de pensamento posteriores em contas criadas em ou após 31 de agosto de 2026.
O Fable 5.1 ainda recusa requisições de cibersegurança? Às vezes. A Anthropic relata cerca de 60% menos intervenções cibernéticas por sessão do Claude Code e permite encontrar vulnerabilidades em códigos. O desenvolvimento de exploits ainda é recusado.
Posso usar o Claude Fable 5.1 gratuitamente? Não no plano Gratuito. O Pro usa créditos de uso; o Max o inclui para até 50% do limite semanal. A API não possui um nível gratuito além do crédito de inscrição.