A Anthropic lançou o Claude Fable 5 em 9 de junho de 2026, e ele chegou com um preço que força uma decisão real: a questão Claude Fable 5 vs Opus 4.8 é, em sua essência, uma questão de dinheiro. O Fable 5 custa exatamente o dobro por token que o Opus 4.8. A entrada custa $10 por milhão de tokens contra $5 do Opus 4.8, e a saída custa $50 por milhão contra $25. Então, antes de ler uma única alegação de benchmark, a matemática é clara: mesmo fornecedor, mesma API de Mensagens, e um prêmio de 2x pelo modelo mais novo. A parte interessante é descobrir quando esse prêmio se paga, e quando você está queimando dinheiro. Se você quiser o panorama completo sobre o modelo mais antigo primeiro, nosso guia para Claude Opus 4.8 cobre o que ele é e onde ele se encaixa na linha de produtos.
TL;DR
Claude Fable 5 e Opus 4.8 são da mesma família. O Fable 5 custa exatamente o dobro do Opus 4.8 por token ($10/$50 vs $5/$25). Para a maioria dos trabalhos de chat, geração de código e recuperação, o Opus 4.8 é a compra mais inteligente. Opte pelo Fable 5 quando precisar de trabalho autônomo de muito longo prazo que se mantenha coerente em milhões de tokens. Caso contrário, economize dinheiro.
Claude Fable 5 vs Opus 4.8: um vislumbre
Aqui está a comparação lado a lado para que você possa ver a troca em um só lugar.
| Dimensão | Claude Fable 5 | Claude Opus 4.8 |
|---|---|---|
| ID do modelo de API | claude-fable-5 |
claude-opus-4-8 |
| Preço de entrada (por 1M de tokens) | $10.00 | $5.00 |
| Preço de saída (por 1M de tokens) | $50.00 | $25.00 |
| Custo relativo | 2x Opus 4.8 | Linha de base |
| Contexto | Opera em milhões de tokens; nenhum número fixo publicado | Janela de contexto de 1M de tokens |
| Pensamento e esforço | Pensamento adaptativo | Pensamento adaptativo + esforço (baixo/médio/alto/muito alto/máximo) |
| Posicionamento | Um modelo de classe Mythos seguro para uso geral; o mais capaz que a Anthropic disponibilizou publicamente | Altamente capaz; era o modelo mais capaz da Anthropic disponível publicamente antes do Fable 5 |
| Melhor para | Trabalho autônomo de muito longo prazo, grandes migrações, agentes de várias horas | A maioria das cargas de trabalho de chat, codegen, RAG e interativas |
Uma nota sobre o contexto: A Anthropic não publicou um número exato para a janela de contexto do Fable 5. A empresa o descreve como permanecendo focado em milhões de tokens, então trate seu comportamento de longo contexto como uma força qualitativa em vez de uma especificação que você pode fixar. O Opus 4.8, em contraste, tem uma janela documentada de 1M de tokens. Se sua decisão depender de um número de contexto preciso, o Opus 4.8 é aquele com um número que você pode citar em um documento de design; a documentação geral dos modelos da Anthropic lista as especificações publicadas para a linha. Para uma introdução em linguagem simples ao novo modelo, nosso explicativo sobre o que é Claude Fable 5 cobre o básico, e nossa análise de preços do Opus 4.8 aprofunda o lado dos custos.
Preço: Fable 5 custa exatamente o dobro
Este é o fato mais claro em toda a comparação, então comece por aqui.
O Fable 5 cobra $10 por milhão de tokens de entrada e $50 por milhão de tokens de saída. O Opus 4.8 cobra $5 por milhão de entrada e $25 por milhão de saída. Duas vezes a taxa de entrada, duas vezes a taxa de saída. Não há asterisco, nenhum desconto em camadas que altere a proporção, e nenhum sobretaxa de longo contexto que a incline. O Fable 5 é 2x o Opus 4.8 em todos os aspectos. Você pode confirmar as taxas atuais na página de preços da Anthropic.
Por 1.000 tokens, isso se traduz em:
- Fable 5: $0.010 de entrada, $0.050 de saída
- Opus 4.8: $0.005 de entrada, $0.025 de saída
Esses números parecem pequenos isoladamente, e é exatamente assim que os orçamentos escapam das equipes. A proporção é o que importa uma vez que o volume aparece.
Vamos a um exemplo mensal realista. Digamos que um recurso de produção processe 200 milhões de tokens de entrada e gere 40 milhões de tokens de saída em um mês. No Opus 4.8, isso é 200 x $5 + 40 x $25, ou $1.000 + $1.000 = $2.000. No Fable 5, a mesma carga de trabalho é 200 x $10 + 40 x $50, ou $2.000 + $2.000 = $4.000. Mesmos tokens, mesmo trabalho, $2.000 contra $4.000. O prêmio escala linearmente com o uso, então uma carga de trabalho que funciona o dia todo, todos os dias, dobra sua fatura de modelo no momento em que você troca a string do modelo.
Essa contextualização importa porque a decisão de upgrade não é 'o Fable 5 é melhor?'. Quase sempre é. A decisão é 'o Fable 5 é melhor o suficiente para justificar dobrar este item de custo específico?'. Para uma ferramenta interna de baixo volume, $2.000 extras por mês podem ser insignificantes. Para um endpoint de alto volume voltado para o cliente, pode ser a diferença entre uma margem saudável e uma negativa. Precie a carga de trabalho, não o modelo. Se você quiser uma análise de custo mais aprofundada sobre a opção mais barata, consulte nossa análise de preços do Opus 4.8; para a tabela de preços do novo modelo especificamente, nosso guia de preços do Claude Fable 5 tem os detalhes.
Capacidade: onde o Fable 5 se destaca
O Fable 5 não é uma reformulação de marketing do Opus 4.8. É um modelo genuinamente mais capaz, e a diferença se manifesta mais claramente em trabalhos longos e autônomos.
Em seu anúncio do Claude Fable 5, a Anthropic descreve o Fable 5 como um modelo de classe Mythos tornado seguro para uso geral, o modelo mais capaz que a empresa disponibilizou publicamente. Ele é construído para trabalho autônomo de muito longo prazo e mantém o foco em milhões de tokens. Essa última frase é todo o argumento de venda. Muitos modelos podem escrever uma boa função ou responder a uma pergunta. Muito menos podem rodar por horas, manter um plano coerente em uma enorme quantidade de contexto e ainda tomar boas decisões no final.
A demonstração mais clara é o resultado da Stripe. O Fable 5 realizou uma migração de base de código Ruby de 50 milhões de linhas para a Stripe em um único dia, um trabalho que a equipe estimou que teria levado dois meses ou mais. Isso não é uma abstração de benchmark. É uma migração real de uma base de código real em uma escala onde o gargalo é a coerência sustentada, não a qualidade bruta por token. Um modelo que divaga ou perde o fio da meada após algumas centenas de milhares de tokens não pode fazer esse trabalho a qualquer preço. Esta é a carga de trabalho para a qual o Fable 5 foi construído.
A memória amplifica a diferença. Em um teste de Slay the Spire, dar ao Fable 5 memória de arquivo persistente produziu uma melhoria de 3x sobre o Opus 4.8. A lição se generaliza bem além de um jogo de cartas: quando uma tarefa abrange muitos passos e o modelo pode escrever notas para si mesmo e lê-las de volta, o Fable 5 transforma essa memória em resultados notavelmente melhores em execuções longas. Se seu agente mantém um bloco de rascunhos, um arquivo de plano ou um armazenamento de memória estruturado ao longo de uma sessão longa, esse é exatamente o cenário onde a força de longo prazo do Fable 5 se traduz em vitórias mensuráveis.
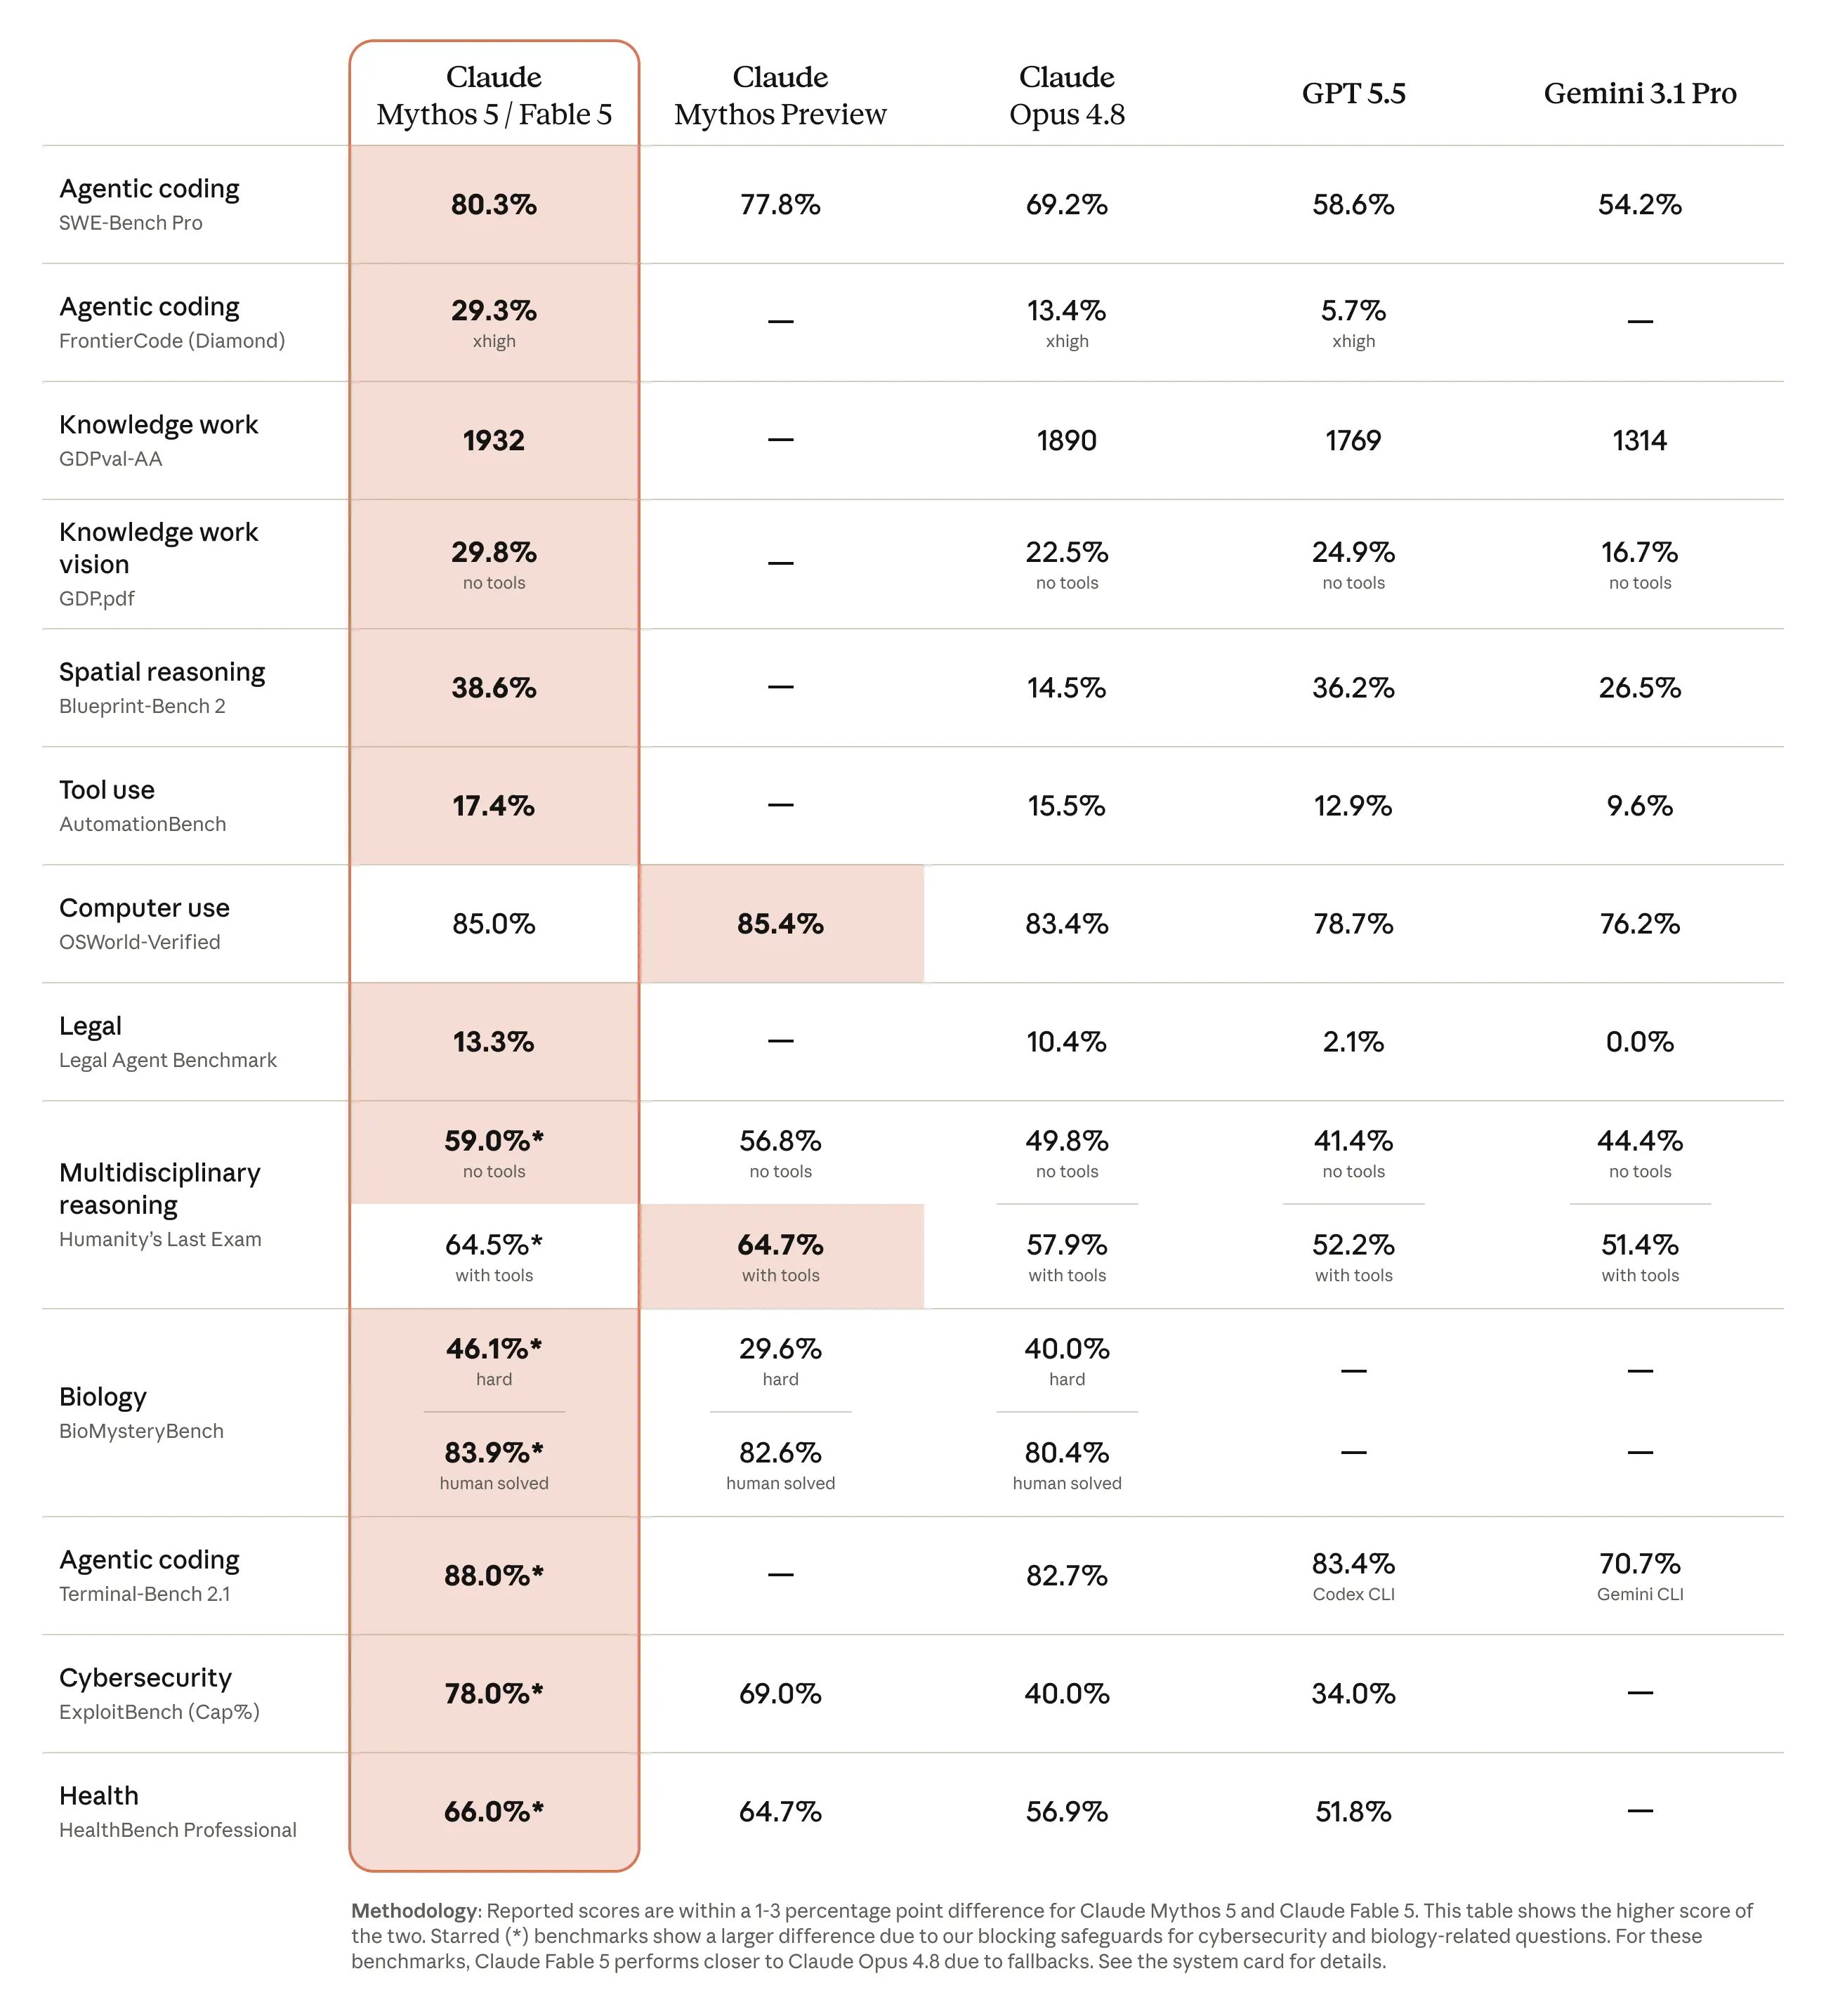
Em benchmarks, o Fable 5 alcançou posições de ponta em quase todos eles. Ele superou o FrontierCode e o FrontierBench da Cognition, o CursorBench e o Hebbia’s Finance Benchmark, entre outros. A Anthropic não divulgou pontuações públicas para estes, então trate as classificações como direcionais, e não como números para citar. O padrão é consistente: o Fable 5 lidera em avaliações de codificação, agenticas e financeiras. O principal não é uma diferença no placar; é que o modelo se posiciona no topo ou perto do topo dos tipos de tarefas difíceis e multifacetadas que se traduzem em trabalho caro no mundo real.
Mais uma coisa que vale a pena saber para uma comparação justa: o Fable 5 vem com salvaguardas que direcionam certas consultas sensíveis, solicitações de segurança cibernética, biologia e química, e destilação de modelos, para o Opus 4.8 em vez de responder diretamente. A Anthropic afirma que isso é acionado em menos de 5% das sessões, então raramente afeta o uso normal, mas é uma diferença comportamental real. Para a maioria das cargas de trabalho, você nunca verá isso. Para um confronto com outros fornecedores, nossa comparação do Opus 4.8 contra GPT-5.5 e Gemini 3.5 e o artigo correspondente Fable 5 contra GPT-5.5 e Gemini 3.5 colocam cada modelo contra o campo mais amplo.
Onde o Opus 4.8 é a compra mais inteligente
Esta é a parte que os anúncios de lançamento tendem a pular: para uma grande parcela do trabalho de produção, o Opus 4.8 é a melhor escolha econômica, e não por pouco.
O Opus 4.8 era o modelo mais capaz da Anthropic disponível publicamente antes da chegada do Fable 5. Ele não piorou no dia em que o Fable 5 foi lançado. Ainda é um modelo forte, de nível de fronteira, com uma janela de contexto documentada de 1M de tokens, pensamento adaptativo e a gama completa de esforço de baixo a máximo. Para a maioria das interfaces de chat, a maioria da geração de código e a maioria da geração aumentada por recuperação (RAG), o Opus 4.8 produz excelentes resultados pela metade do custo por token. Se a tarefa se encaixa confortavelmente em um milhão de tokens e se resolve em uma única vez ou em um loop curto, você provavelmente está pagando o dobro por uma margem que não usará ao escolher o Fable 5.
Três formatos de carga de trabalho se inclinam fortemente para o Opus 4.8:
- Chat interativo e assistentes, onde cada turno é curto, a latência importa, e o modelo raramente precisa sustentar um plano de várias horas.
- Geração e revisão de código no nível de função, arquivo ou pull-request, onde o contexto é limitado e a tarefa é concluída rapidamente.
- RAG e Q&A de documentos, onde você insere contexto relevante em uma janela de 1M de tokens e faz uma pergunta focada. A janela é o ativo aqui, e o Opus 4.8 a possui.
Há também um argumento discretamente persuasivo escondido no próprio design do Fable 5. Quando o Fable 5 encontra uma de suas categorias de salvaguarda, ele encaminha a consulta para o Opus 4.8. O modelo mais novo literalmente recorre ao mais antigo para os casos sensíveis. Esse é um forte sinal de que o Opus 4.8 é confiável, capaz e bom o suficiente para substituir o modelo principal no tráfego real. Se ele é a rede de segurança sob o modelo mais caro que a Anthropic vende, é mais do que adequado para a maioria das suas solicitações diárias.
O padrão sensível ao custo, então, é direto: comece com o Opus 4.8, meça e atualize apenas as cargas de trabalho específicas que comprovem a necessidade de autonomia de longo prazo. Se até mesmo o Opus 4.8 for mais do que uma carga de trabalho precisa, o Claude Sonnet 4.6 está abaixo dele, custando $3 de entrada e $15 de saída, e lida com tarefas mais simples e de alto volume por uma fração do custo. Para detalhes de configuração sobre os níveis mais baratos do Claude, nosso guia da API Opus 4.8 descreve as chamadas.
Um framework de decisão: qual você deve escolher?
Ignore as intuições e direcione pela carga de trabalho. Estas regras cobrem a maioria dos casos reais.
- Tarefas curtas e de uma única rodada (chat, classificação, extração, um trecho rápido de código): Use o Opus 4.8. O prêmio de 2x não lhe traz nada aqui porque a tarefa nunca exerce a vantagem de longo prazo do Fable 5.
- Geração e revisão de código limitada (uma função, um arquivo, um PR): Use o Opus 4.8. Resultados fortes, metade do custo e o contexto se encaixa.
- RAG, Q&A de documentos e análise dentro de uma janela de 1M de tokens: Use o Opus 4.8. A janela documentada de um milhão de tokens é o recurso pelo qual você está pagando, e o Opus 4.8 a possui.
- Agentes autônomos de várias horas que devem permanecer coerentes em uma execução muito longa: Use o Fable 5. Esta é a carga de trabalho para a qual ele foi construído, e a diferença de coerência justifica o preço.
- Grandes migrações e refatorações que abrangem uma enorme base de código de uma só vez: Use o Fable 5. A migração da Stripe de 50 milhões de linhas é o modelo. Nessa escala, o foco sustentado é o gargalo, e o Fable 5 o supera.
- Agentes de longa execução com memória persistente: Use o Fable 5. O resultado de 3x de memória indica que o benefício composto ao longo de sessões longas é real.
- O custo é a restrição mais forte: Use o Opus 4.8, ou mude para o Sonnet 4.6 para trabalhos simples de alto volume. Reserve o Fable 5 para as poucas tarefas que realmente precisam dele.
A meta-regra: use o Opus 4.8 por padrão e promova cargas de trabalho individuais para o Fable 5 apenas quando elas demonstrarem a necessidade de autonomia de longo prazo. Dobrar o custo de forma generalizada porque um trabalho se beneficia é a maneira mais comum de as equipes gastarem demais em um modelo principal.
Alternando entre eles no código
A boa notícia para quem está ponderando esta decisão: a troca é trivial. Ambos os modelos funcionam sob a mesma API de Mensagens. Não há migração de SDK, novo fluxo de autenticação ou corpo de solicitação remodelado. Você altera a string do ID do modelo e nada mais. claude-fable-5 para o novo modelo, claude-opus-4-8 para o mais barato.
import anthropic

client = anthropic.Anthropic()

# Cheaper, frontier-tier default
response = client.messages.create(
    model="claude-opus-4-8",          # swap to "claude-fable-5" for the flagship
    max_tokens=16000,
    thinking={"type": "adaptive"},
    messages=[{"role": "user", "content": "Summarize this design doc and list open questions."}],
)

for block in response.content:
    if block.type == "text":
        print(block.text)
Como a única diferença é a string do modelo, você pode rotear por solicitação. Envie o tráfego diário para claude-opus-4-8, e altere a string para claude-fable-5 para as poucas tarefas que precisam de autonomia de longo prazo, tudo a partir do mesmo cliente e do mesmo caminho de código. Isso torna a implementação de uma estratégia de 'padrão econômico, upgrade sob demanda' fácil: um único valor de configuração ou uma condicional de uma linha decide qual modelo lida com uma determinada solicitação. Para a superfície completa de solicitação do modelo mais antigo, consulte nosso guia da API Opus 4.8; o guia da API Fable 5 correspondente cobre o novo modelo.
Compare-os você mesmo com Apidog
Tabelas de preços e alegações de benchmark só te levam até certo ponto. A maneira honesta de resolver a questão Claude Fable 5 vs Opus 4.8 para sua carga de trabalho é disparar o mesmo prompt para ambos os IDs de modelo e ver o que retorna. Essa é uma tarefa que o Apidog gerencia de forma limpa.
Configure uma solicitação contra a API de Mensagens da Anthropic, depois duplique-a e altere apenas o campo do modelo, claude-fable-5 em um, claude-opus-4-8 no outro. Envie ambos com um prompt que realmente se assemelhe ao seu tráfego de produção, não uma pergunta trivial. Em seguida, compare as duas respostas lado a lado: qual resposta é mais correta, qual é mais completa e se a diferença de qualidade é grande o suficiente para importar para o seu caso de uso.
O Apidog também exibe os números que impulsionam a decisão de custo. Você pode observar a latência em cada chamada e ler o uso de tokens diretamente de cada resposta, incluindo as contagens de entrada e saída que determinam o que você realmente pagará. Coloque o uso de ambos os modelos ao lado da diferença de qualidade, e o prêmio de 2x deixa de ser abstrato. Você pode ver, para o seu prompt real, se a saída do Fable 5 vale os tokens e dólares extras ou se o Opus 4.8 já faz o trabalho. Salve as duas solicitações como uma pequena coleção e você terá um dispositivo de teste A/B repetível que pode ser executado novamente sempre que seus prompts mudarem ou um novo modelo for lançado. Se você quiser experimentar, Baixe o Apidog e crie as duas solicitações em alguns minutos. É um caminho mais rápido para uma resposta confiante do que ler mais uma folha de especificações, e o Apidog mantém toda a comparação em um só lugar.