
Muse Wonder는 2026년 10월 12일 Meta Superintelligence Labs가 공개한 Meta의 첫 프론티어급 AI 모델입니다. 라인업은 “Wonder”와 “Wonder Full” 두 가지 크기로 구성되어 있습니다. Muse Wonder는 오늘 시점에서 Meta Model API를 통해 muse-wonder-1.0이라는 모델 ID로 제공되며, 가격은 입력 백만 토큰당 $4, 출력은 $20입니다. 또한 Meta의 터미널 코딩 에이전트인 Muse Code에도 탑재되어 있습니다. 반면 한 단계 큰 Muse Wonder Full은 Muse Code 상위 두 개 플랜을 구독하는 사용자만 사용할 수 있으며, API로는 제공되지 않고 토큰 단가도 공개되어 있지 않습니다. 두 모델 모두 텍스트, 이미지, 영상, 오디오라는 네 가지 모달리티를 입력으로 받고 출력으로는 텍스트를 반환하며, 100만(1M) 토큰에 이르는 넓은 컨텍스트 윈도우를 갖추고 있습니다.
Meta가 이 두 모델을 처음부터 겨냥한 것은 에이전트, 즉 사용자를 대신해 이메일을 읽고, 코드를 실행하고, 양식을 작성하고, 문제가 생겨도 작업을 멈추지 않고 계속 이어 가는, 말하자면 자율적으로 움직이는 소프트웨어입니다. 이 포지셔닝은 두 개의 대표 기능 설계부터 Meta가 공개하기로 고른 벤치마크 선정에 이르기까지 이번 출시를 특징짓는 모든 부분을 규정합니다. 이 가이드에서는 두 모델이 각각 어떤 것인지, Meta 자체 테스트와 독립 벤치마크에서 각각 어느 정도의 점수를 내는지, 접근 권한을 얻는 방법, 실제로 드는 비용, 그리고 주의할 점까지 이 순서대로 다룹니다. 오늘 바로 호출해 보고 싶다면 Muse Wonder API 가이드가 Apidog에서의 첫 요청을 보내는 방법을 단계별로 안내해 줍니다.
두 모델의 기본 사양 한눈에 비교하기
| Muse Wonder | Muse Wonder Full | |
|---|---|---|
| 모델 ID | muse-wonder-1.0 |
muse-wonder-full-1.0(카탈로그에만 등재) |
| 이용 경로 | Meta Model API, Muse Code(모든 플랜 대상) | Muse Code Power(월 $50) 및 Maximum(월 $200) |
| API 가격 | 입력 $4 / 출력 $20 / 캐시 $0.20(1M 토큰당) | 공개되지 않음 |
| 컨텍스트 윈도우 | 1M 토큰 | 1M 토큰 |
| 입력 | 텍스트, 이미지, 영상, 오디오 | Wonder와 동일 |
| 출력 | 텍스트 | 텍스트 |
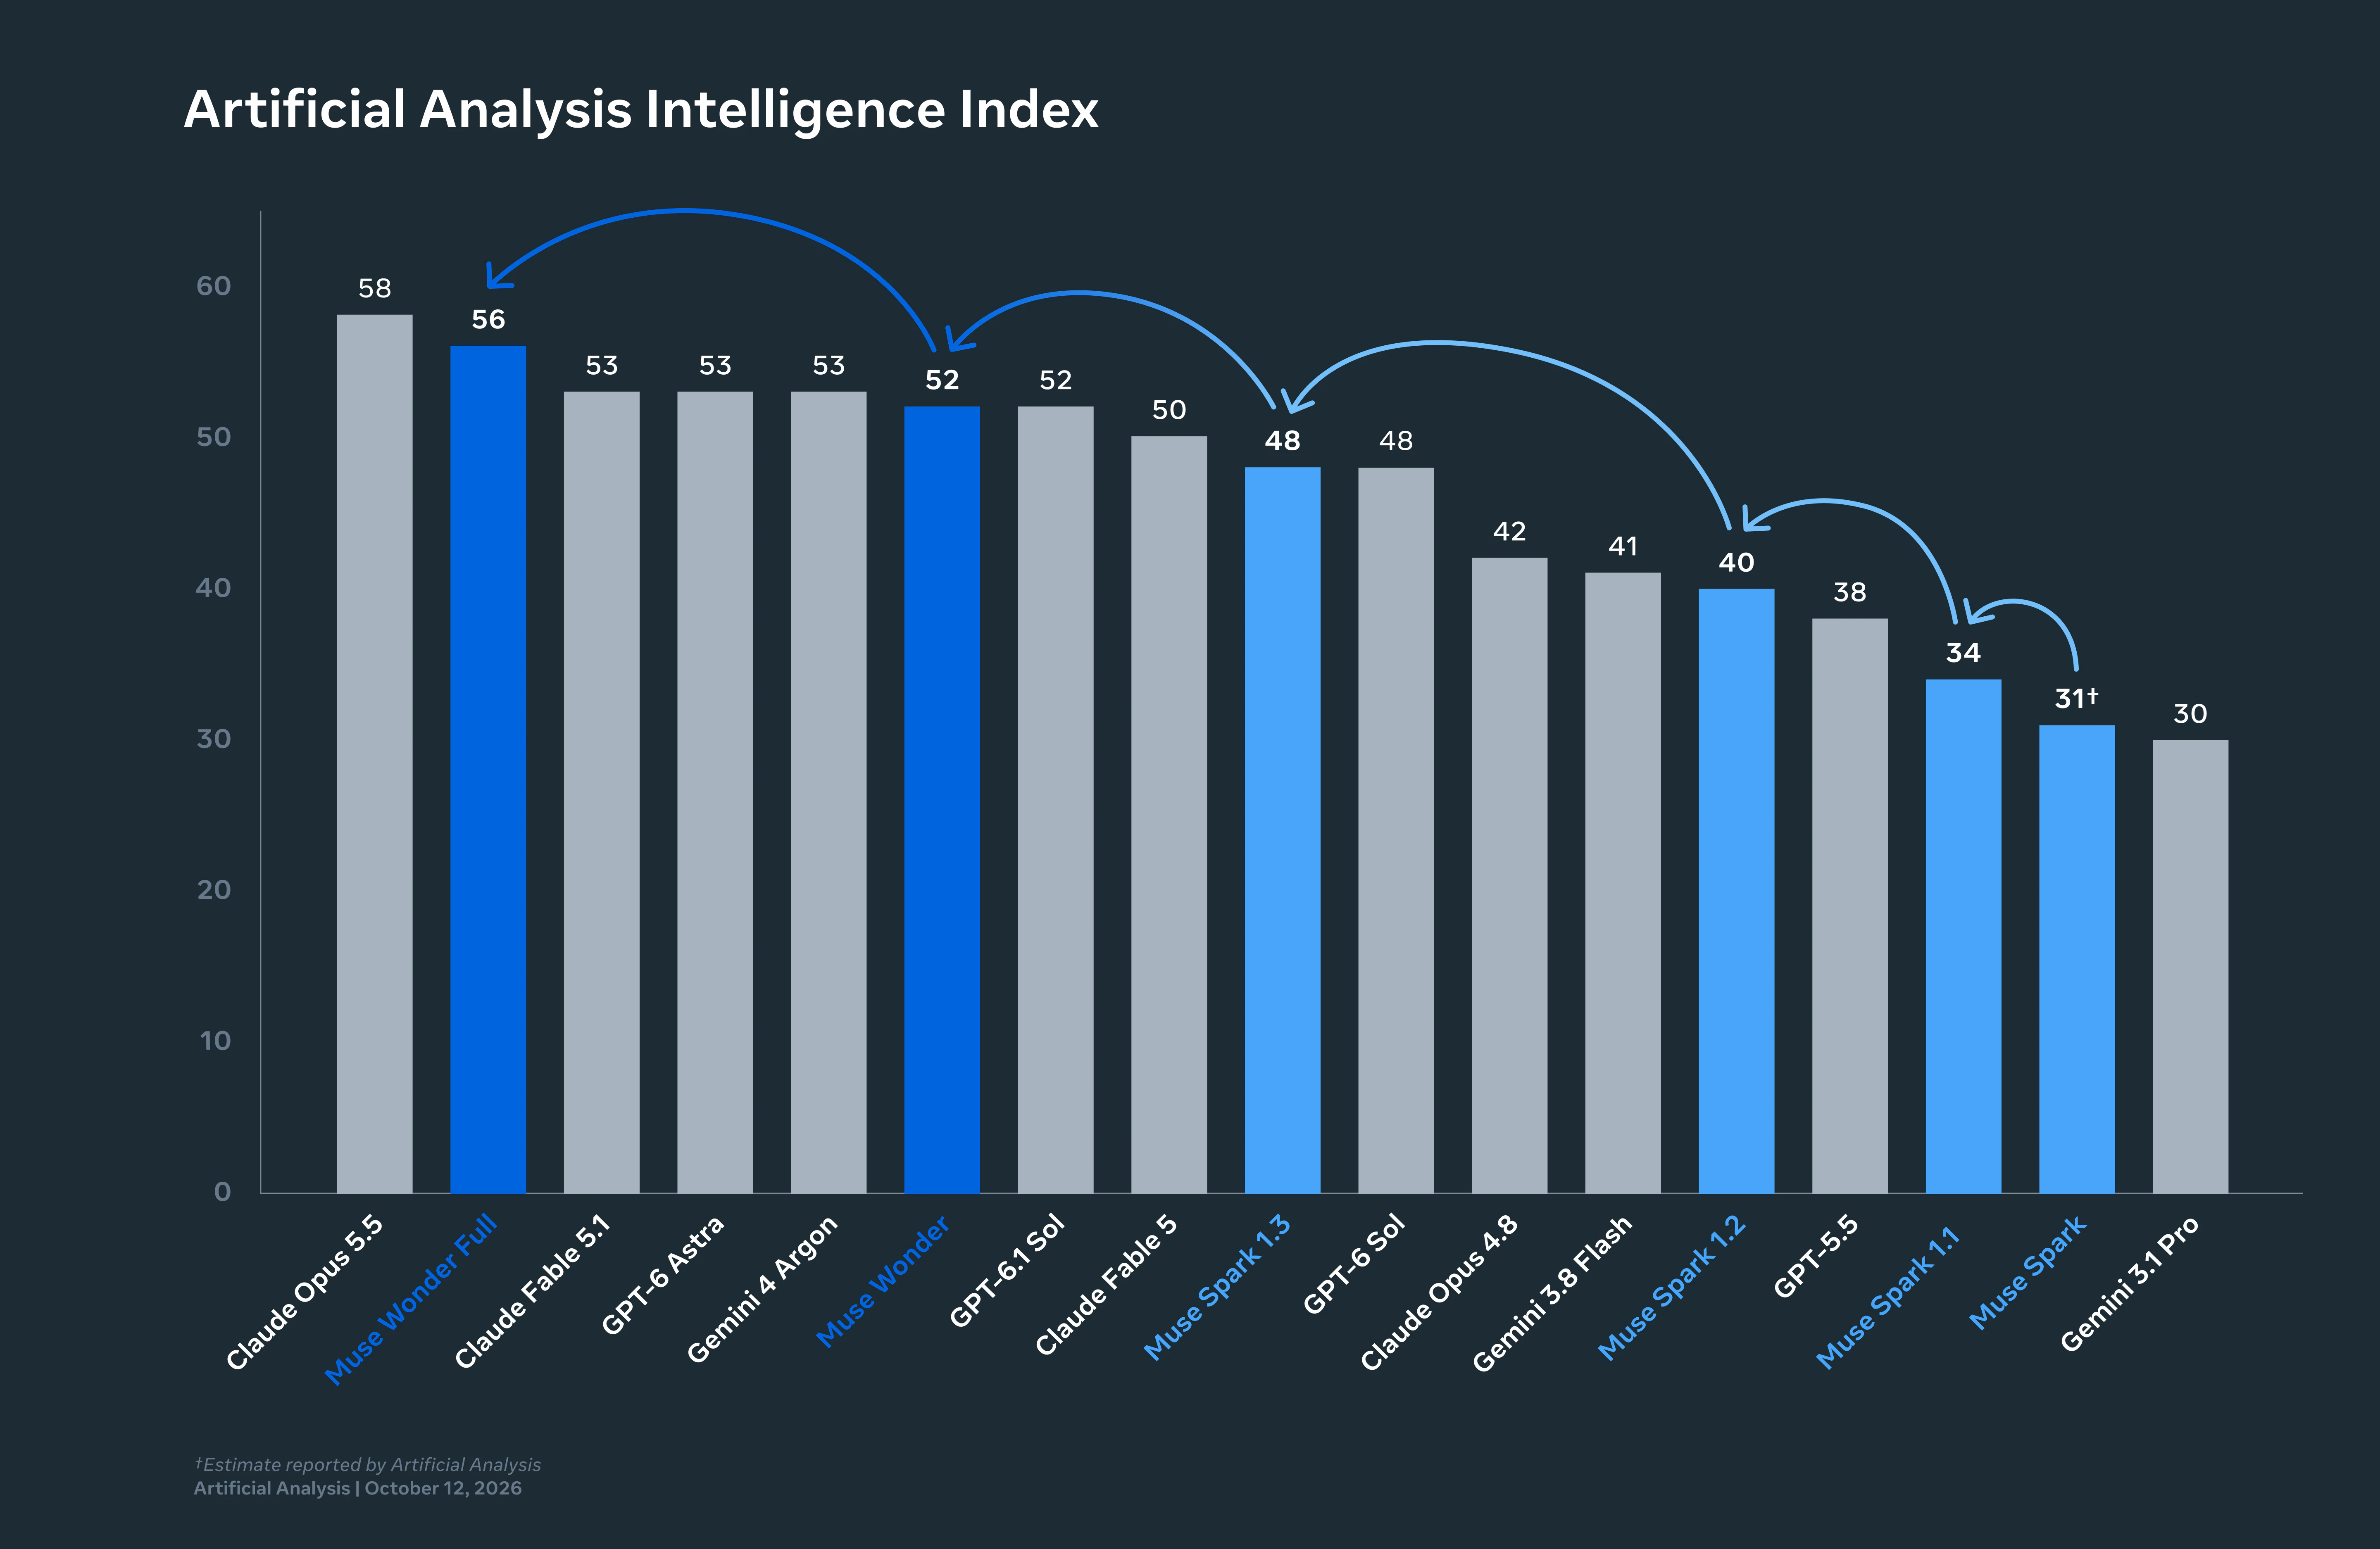
| Artificial Analysis Intelligence Index | 52 | 56 |
| 가중치 | 공개되지 않음 | 공개되지 않음 |
두 모델이 세상에 나온 것은 전 세대인 Muse Spark 1.3으로부터 약 6주 뒤였습니다. Spark 1.3는 같은 지수에서 48점을 기록했고 가격은 $1.25 / $4.25 조합이었습니다. Mark Zuckerberg는 X에 올린 글에서 Wonder를 Spark보다 “훨씬 더 크고 진보된 클래스의 모델”이라고 표현했습니다. Meta의 공식 연구 블로그에 따르면, 두 모델은 올해 가동을 시작한 오하이오주의 기가와트급 데이터센터 Prometheus에서 학습되었다고 설명되어 있습니다.
새로운 기능: Active Memory와 Active Focus
Meta는 Wonder 시리즈를 이전 모델과 구별 짓는 것으로 꼽는 능력이 두 가지 있습니다.
Active Memory는 한 사람에 대한 컨텍스트를 여러 대화에 걸쳐 계속 유지하고, 관련 있는 부분만 현재 작업으로 끌어옵니다. Meta 자신의 설명대로라면 이것은 별도의 메모리 API가 아니라 모델 자체의 동작이며, 메모리를 기록하는 엔드포인트는 존재하지 않습니다. 64K~100K 토큰에 이르는 대화 속에 사실을 숨겨 두고 대화 중간에 그중 일부를 바꿔버리는 Meta 내부 벤치마크 MemoryBench에서는 Muse Wonder가 85.6점이라는 점수를 기록했습니다. 이에 비해 Claude Opus 5.5는 81.5, GPT-6 Astra는 81.4에 그쳤습니다.
Active Focus는 어려운 목표를 향해 끈질기게 작업을 이어 가는 힘을 가리키는 Meta의 용어입니다. 막히면 다른 접근 방식을 시도하고, 장애물이 되는 부분을 하나씩 해치고, 새로운 정보에 적응하는 것, 그리고 Meta의 표현을 빌리면 필요할 때는 명확히 묻고 중요한 작업 전에는 반드시 확인을 거치는 것을 말합니다. 내부 벤치마크인 FocusBench에서는 Wonder Full이 54.2%로 선두에 섰고, GPT-6 Astra가 47.7%, Opus 5.5가 45.8%, 작은 쪽 Wonder가 44.9%라는 순서로 이어졌습니다.
두 벤치마크 모두 Meta가 자체적으로 설계한 것이라 Meta 외부에서는 재실행할 수 없습니다. 이는 모델이 무엇을 위해 학습되었는지에 대한 의지 표명으로 받아들여야 하며, 그 의도가 실제로 어떻게 나타났는지는 뒤에서 다룰 독립 수치로 확인하기 바랍니다.
이 두 가지에 더해, Meta는 법률·금융·헬스 각 분야의 도메인 전문성, 대규모 저장소를 아우르는 프론티어급 코딩, 컴퓨터 사용(브라우저, 데스크톱, 모바일 앱 조작), 서브에이전트로의 작업 위임, 병렬 도구 호출, 오류 복구를 꼽고 있습니다.
벤치마크가 말해 주는 것
Meta가 공개한 모델 카드는 추론 강도(reasoning effort)를 최대로 설정한 상태에서 이 두 모델을 GPT-6 Astra, Claude Opus 5.5와 비교합니다. 선정된 항목은 에이전트 업무와 전문 업무에 유리한 내용으로 기울어져 있습니다.
| 벤치마크 | Wonder Full | Wonder | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| Harvey LAB-AA(법률) | 13.1 | 10.0 | 8.6 | 4.2 |
| SWE-Marathon(장시간 코딩 실행) | 57.5 | 53.1 | 42.5 | 46.3 |
| DeepSWE 1.1 | 79.0 | 78.8 | 74.1 | 74.2 |
| JobBench | 75.3 | 70.5 | 66.1 | 75.4 |
| Terminal-Bench 4.0-AA | 57.1 | 52.0 | 59.1 | 59.6 |
| HealthBench Pro | 62.3 | 60.5 | 65.3 | 65.6 |
점수 경향은 일관됩니다. Wonder는 장시간에 걸쳐 이어지는 에이전트 업무와 법률 태스크에서 앞서는 반면, 터미널 작업과 헬스 분야에서는 Opus 5.5와 Astra에 뒤처지는 결과를 보입니다. Meta 자체 카드에도 경쟁 모델 실행이 최선 노력(best-effort)으로 이루어졌고 일부 코딩 비교에서는 서로 다른 도구가 사용되었다는 주석이 붙어 있습니다.
독립적인 시각으로 참조할 곳은 Artificial Analysis입니다. 이 회사가 공개하는 Intelligence Index v4.3에서 Wonder Full은 56점을 기록해 Claude Sonnet 5.5와 동률을 이뤘습니다. 58점을 기록한 Opus 5.5에는 못 미치지만, 각각 53점이었던 GPT-6 Astra, Gemini 4 Argon, Claude Fable 5.1의 세 모델은 앞섭니다. 반면 Wonder의 점수는 52점입니다. Spark 1.3 대비 Full이 가장 크게 오른 항목은 Terminal-Bench 4.0으로, 33%에서 57%로 올라갔습니다. 환각(할루시네이션)률은 33%에서 23%로 떨어져 프론티어 모델 가운데 두 번째로 낮은 수준이 되었습니다. 약점은 여전히 지식 재현에 있어, AA-Omniscience에서는 30점에 그치고 Opus 5.5는 46점입니다. 벤치마크 해설 글에서는 Meta 표와 Artificial Analysis의 판단이 엇갈리는 항목까지 포함해 모든 행을 자세히 다룹니다.
접근 권한 얻는 방법
Meta Model API. dev.meta.ai에서 키를 새로 만들고, 아무 OpenAI SDK나 https://api.meta.ai/v1로 향하게 한 뒤 모델을 muse-wonder-1.0으로 설정하면 준비 끝입니다. 이 API는 Chat Completions와 Anthropic 호환 Messages 엔드포인트도 함께 제공하므로, 몇 가지 환경 변수만 설정하면 Claude Code와 Codex도 그 위에서 그대로 돌릴 수 있습니다. 레이트 리밋은 분당 요청 3,000건과 토큰 400만 개이며, 키 단위가 아니라 팀 전체 단위로 공유된다는 점에 유의하세요.
Muse Code. Meta의 터미널 에이전트는 curl 명령 한 줄만 실행하면 설치되며, 월 $5 Everyday 플랜부터 모든 구독에 Muse Wonder가 처음부터 포함되어 있습니다. Power($50)와 Maximum($200) 플랜에서는 Muse Wonder Full이 열립니다. 구독은 기본값이 Contributor 모드로, 더 많은 사용량을 조건으로 사용자의 프롬프트·코드·출력을 Meta가 학습에 사용할 수 있게 해 줍니다. 이 모드는 끌 수도 있습니다.
Muse 앱. 일반 소비자용 에이전트 앱 자체는 무료로 쓸 수 있지만, Muse Wonder는 먼저 $20와 $100 구독자를 대상으로 순차 공개되고 있습니다. 현재 시점에서 이 모델로 가는 무료 경로는 존재하지 않습니다. 무료 이용 해설 글에 실제로 존재하는 방법과 각각의 비용이 정리되어 있으니 참고하기 바랍니다.
서드파티. Vercel AI Gateway와 Cloudflare Workers AI 양쪽 서비스 모두 동일한 토큰 가격으로 meta/muse-wonder-1.0을 제공합니다.
실제로 드는 비용
$4 / $20이라는 정가(리스트 가격)는 Claude Opus 5.5와 완전히 같은 수준이며, $10 / $50인 GPT-6 Astra와 Claude Fable 5.1보다는 60% 저렴합니다. $0.20짜리 캐시 입력은 95% 할인입니다. 롱 컨텍스트에 대한 할증 요금도 없어서, 900K 토큰 프롬프트도 9K 프롬프트와 토큰당 비용이 완전히 같습니다.
정가는 태스크 단위의 가격이 아닙니다. Artificial Analysis의 측정에 따르면 Wonder가 Intelligence Index 태스크 하나당 쓰는 비용은 약 $4.52로, Opus 5.5의 $5.98과 GPT-6 Astra의 $3.26 사이에 위치합니다. 그 이유는 소비 토큰 수에 있습니다. Wonder는 이 지수 전체에서 실로 769만 개의 입력 토큰을 소모했는데, 이는 OpenAI와 Google 모델의 2~7배에 해당하며, 비용 대부분은 새 입력이 아니라 캐시 쓰기와 읽기에 쓰였습니다. 언뜻 싸 보이는 요금이라도 출력이 장황해지기 쉬운 에이전트에서는 총액이 비쌀 수 있습니다. 가격 해설 글에서 구체적인 예를 다루며, Apidog에서는 모든 응답 안에 usage.input_tokens_details.cached_tokens가 표시되므로 돈이 어디로 가는지 세밀하게 파악할 수 있습니다.
주의할 점
- 최고 모델은 API에 없다. 출시 헤드라인이 주장하는 프론티어 성능의 전부는 Muse Code 구독을 하지 않으면 쓸 수 없는 Wonder Full에 기반합니다. 반면 API로 제공되는 모델은 그보다 4포인트 낮은 값입니다.
- 사내 벤치마크. MemoryBench, FocusBench, Personal Superintelligence Index는 Meta 외에는 실시할 수 없는 테스트입니다. Meta의 표는 Artificial Analysis 행에 Full을 59.0으로 싣고 있지만, Artificial Analysis 본인이 공표하는 수치는 56입니다.
- 데이터 모드가 중요하다. Standard 모드의 API 트래픽은 학습에 쓰이지 않습니다. 반면 Muse Code 구독이 기본으로 하는 Contributor 모드는 쓰입니다. 제로 데이터 보존(데이터를 보존하지 않는 설정)은 승인된 조직에 제공되지만, 그 경우 서버 측 대화 상태, 백그라운드 요청, 파일 업로드, 내장 웹 검색이 모두 비활성화됩니다.
- 출시 주간의 버그. 첫날 Wonder와 Wonder Full이 Muse Code 쿼터를 비정상적으로 빠른 속도로 소진하는 문제가 발생해 화제가 되었습니다. Meta는 쿼터를 초기화했고, Alexandr Wang은 “아직 다듬고 있는 문제가 있다”고 말했습니다.
- 안전 보고서는 대기 중. Meta는 안전장치를 두지 않으면 화학·생물학적 오용의 고위험 기준을 배제할 수 없다고 밝히고, 안전장치가 있을 때 잔여 리스크를 중간 이하로 평가했으며, 전체 보고서를 곧 공개하겠다고 약속했습니다.
- 에이전트는 아직 실수한다. Meta 스스로 중요한 작업을 실행하기 전에 사람의 확인을 거칠 것을 권고합니다. 이는 API를 조작할 수 있는 모든 에이전트에 대해 우리가 하는 조언과 같은 것입니다.
자주 묻는 질문
Muse Wonder는 Llama처럼 오픈 웨이트인가요? 아니요, 다릅니다. 두 Wonder 모델 모두 비공개이며 Meta의 API, Muse Code, 그리고 파트너 게이트웨이를 통해서만 제공됩니다. 내려받을 수 있는 가중치는 존재하지 않습니다.
어떤 API 형식을 사용하나요? 실제로는 세 가지입니다. Responses API는 여러 단계 작업에 Meta가 권하는 인터페이스이고, Chat Completions는 어떤 OpenAI SDK로도 동작하며, Messages 엔드포인트는 Anthropic 형식 요청을 받아들일 수 있습니다. 추론 강도는 minimal부터 max 사이에서 고를 수 있습니다. none을 보내면 400이 돌아옵니다. 이 모델은 항상 추론을 수행하기 때문입니다.
Claude Opus 5.5보다 나은가요? Meta의 에이전트 벤치마크에서는 장시간 코딩 실행과 법률 업무에서 Wonder Full이 앞섭니다. 반면 독립 지수에서는 Opus 5.5가 여전히 두 Wonder 모델보다 앞서며, 터미널 태스크와 헬스 분야에서도 이깁니다. 맞대결 글에서 자세히 다루지만, 요약하면 가격은 같고 잘하는 일이 서로 다르다는 것입니다.
결제 전에 써볼 수 있나요? API에서 몇 센트 정도를 쓰는 방법밖에 없습니다. $4 / $20 요금이면 테스트 몇 번은 커피 한 잔보다도 씁니다. Apidog를 내려받아 키를 시크릿 변수로 저장하면 한 프로젝트에서 실행할 수 있습니다.
정리: 이것이 당신에게 의미하는 것
Muse Wonder는 Opus 5.5급 가격에 놓인, 실력을 갖춘 프론티어 모델입니다. 장시간 에이전트 태스크에서는 뚜렷한 강점이 있고, 지식과 터미널 작업에서는 뚜렷한 공백이 있습니다. Meta의 대표 벤치마크를 장식하는 모델 뒤에는 $50짜리 구독이 있습니다. 에이전트를 만든다면, 정가가 아니라 소모 토큰으로 측정하면서 이번 주 안에 자신의 태스크에 한번 시험해 볼 가치가 충분히 있습니다.