
GLM-5.2は現在利用できる最も高性能なオープンウェイトモデルの1つであり、オープンなMITライセンスは「無料」が現実的であることを意味します。ただし、約753Bの混合エキスパートモデルにとって、「無料」と「簡単」は同じではありません。このガイドでは、完全に無料のセルフホスティングから、ほぼ無料のトライアルクレジット、そして最も安価な有料プランまで、実際の利用方法を、ハードウェアと制限に関する正直な注意点とともに解説します。
手短に言えば、もしハードウェア(または安価なレンタルGPU)をお持ちなら、オープンウェイトをセルフホストしてください。そうでない場合は、z.aiのトライアルクレジットか、最も安価なGLM Coding Planのティアを利用しましょう。glm-5.2向けの無料のOpenRouterの利用経路はないため、探さないでください。
迅速な意思決定ツリー
該当する行を選び、そのセクションにスキップしてください。
| あなたの状況 | 最適な経路 | 実際の費用 |
|---|---|---|
| 強力なGPUボックスを所有している(またはレンタルできる) | オープンウェイトをセルフホスト(Ollama / vLLM) | ウェイトは$0;電気代またはGPUレンタル料 |
| セットアップもカード登録も不要 | z.aiの無料トライアルクレジット / レート制限付きティア | クレジットがなくなるまで無料(現在の提供状況を確認してください) |
| 最も安価で信頼できる有料パスが必要 | GLM Coding Plan Lite、またはキャッシュ入力APIの料金 | 〜$3-6/月(要確認)または1回の呼び出しにつき数セント |
| コミットメントなしで従量課金制を希望 | OpenRouter API | 入力100万トークンあたり$1.40、出力100万トークンあたり$4.40 |
経験則として:本当に無料とはセルフホストを意味します。ほぼ無料とはトライアルクレジットまたはLiteプランを意味します。
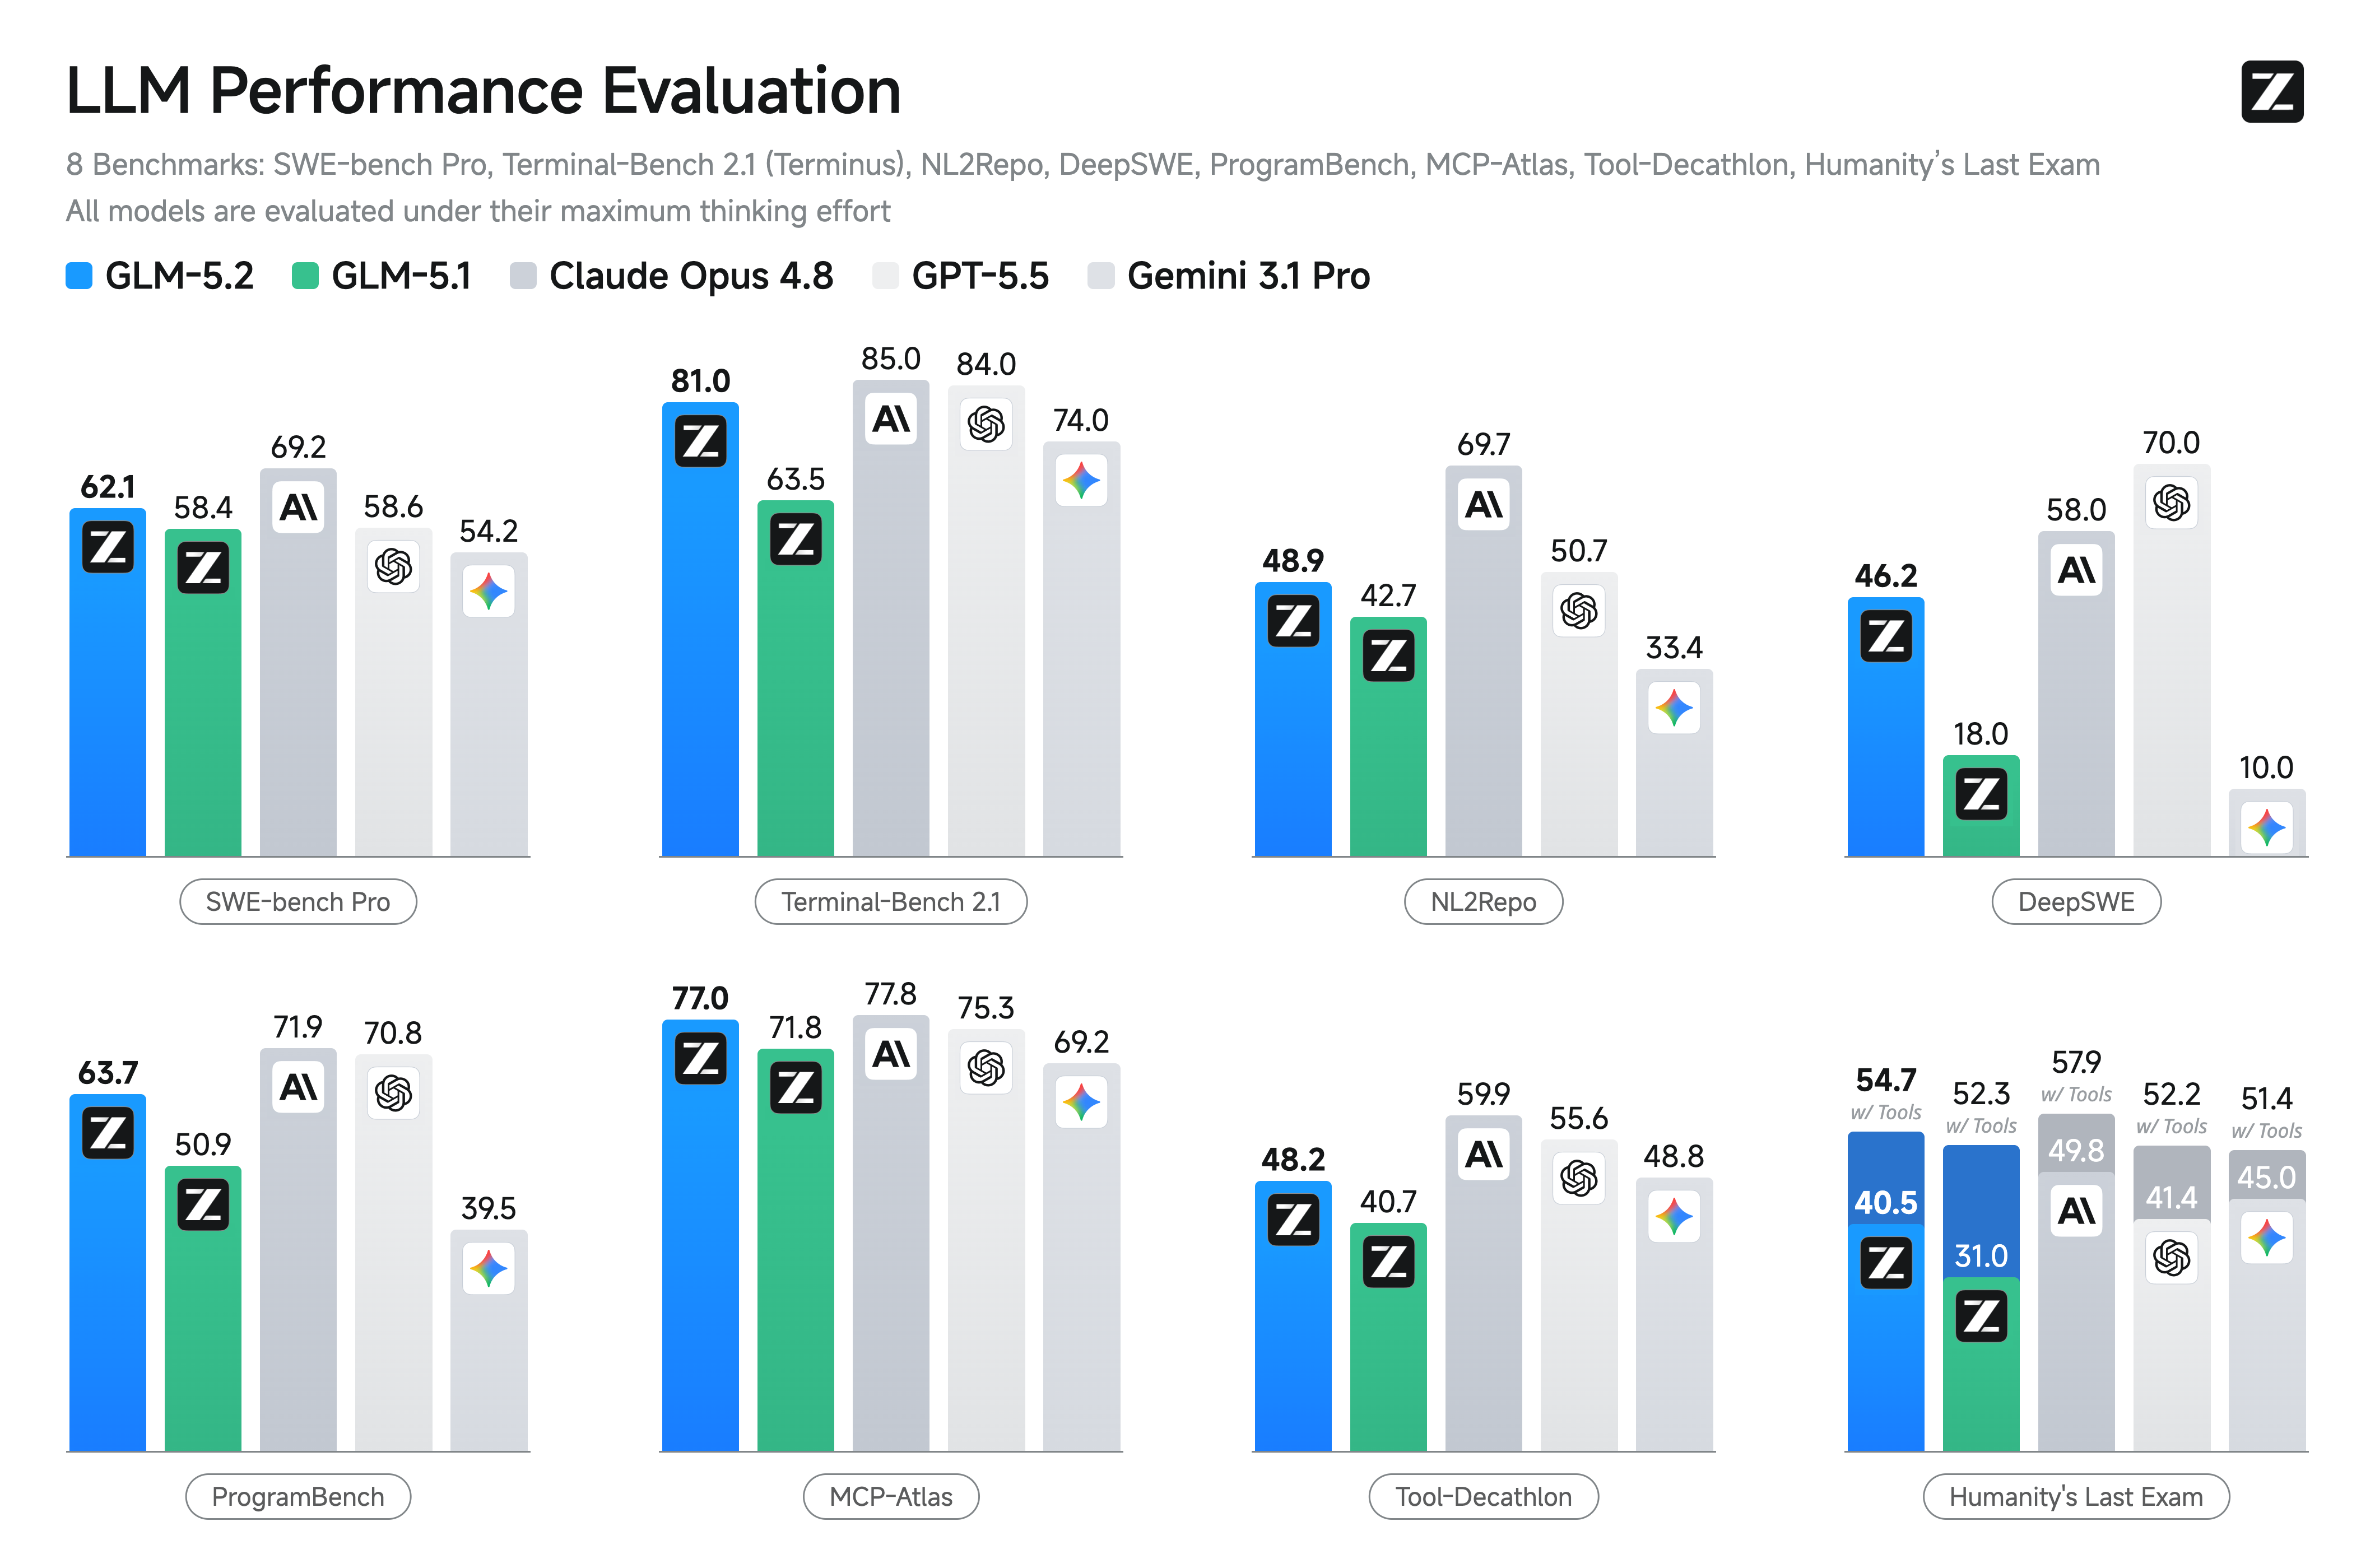
ルート1:オープンなMITウェイトをセルフホストする(完全に無料)
GLM-5.2はMITライセンスのもと地域制限なしで提供されているため、誰にも支払うことなくウェイトをダウンロードし、自身のハードウェアで実行できます。ウェイトはHugging Faceのzai-org/GLM-5.2にあります。
正直なところ:これはBF16で約753BパラメータのMoEモデルです。トークンごとに活性化されるパラメータはごく一部ですが、全ウェイトセットはメモリに常駐する必要があります。BF16では、これは1テラバイトをはるかに超える生ウェイトです。これをノートパソコンで実行することはできません。セルフホストするほとんどの人は、次の2つのうちいずれかを行います。
- メモリフットプリントを削減するために量子化されたビルド(4ビットなど)を実行し、わずかな品質トレードオフを受け入れる。
- クラウドプロバイダーから時間単位でマルチGPUインスタンスをレンタルし、使用後に停止する。
したがって、ここでの「無料」とはライセンス費用が無料であることを意味します。ハードウェア、電気代、またはGPUレンタル料は依然として支払う必要があります。ほとんどの個人にとって、高VRAMワークステーションでの量子化ビルド、または短時間のレンタルセッションが現実的な選択肢です。
OllamaでGLM-5.2を実行する
Ollamaは最も使いやすいローカルランナーです。GLM-5.2はOllamaライブラリで利用でき、以下の2つのコマンドで実行できます。
# モデルをプルする(非常に大きなダウンロードが予想されます)
ollama pull glm-5.2:cloud
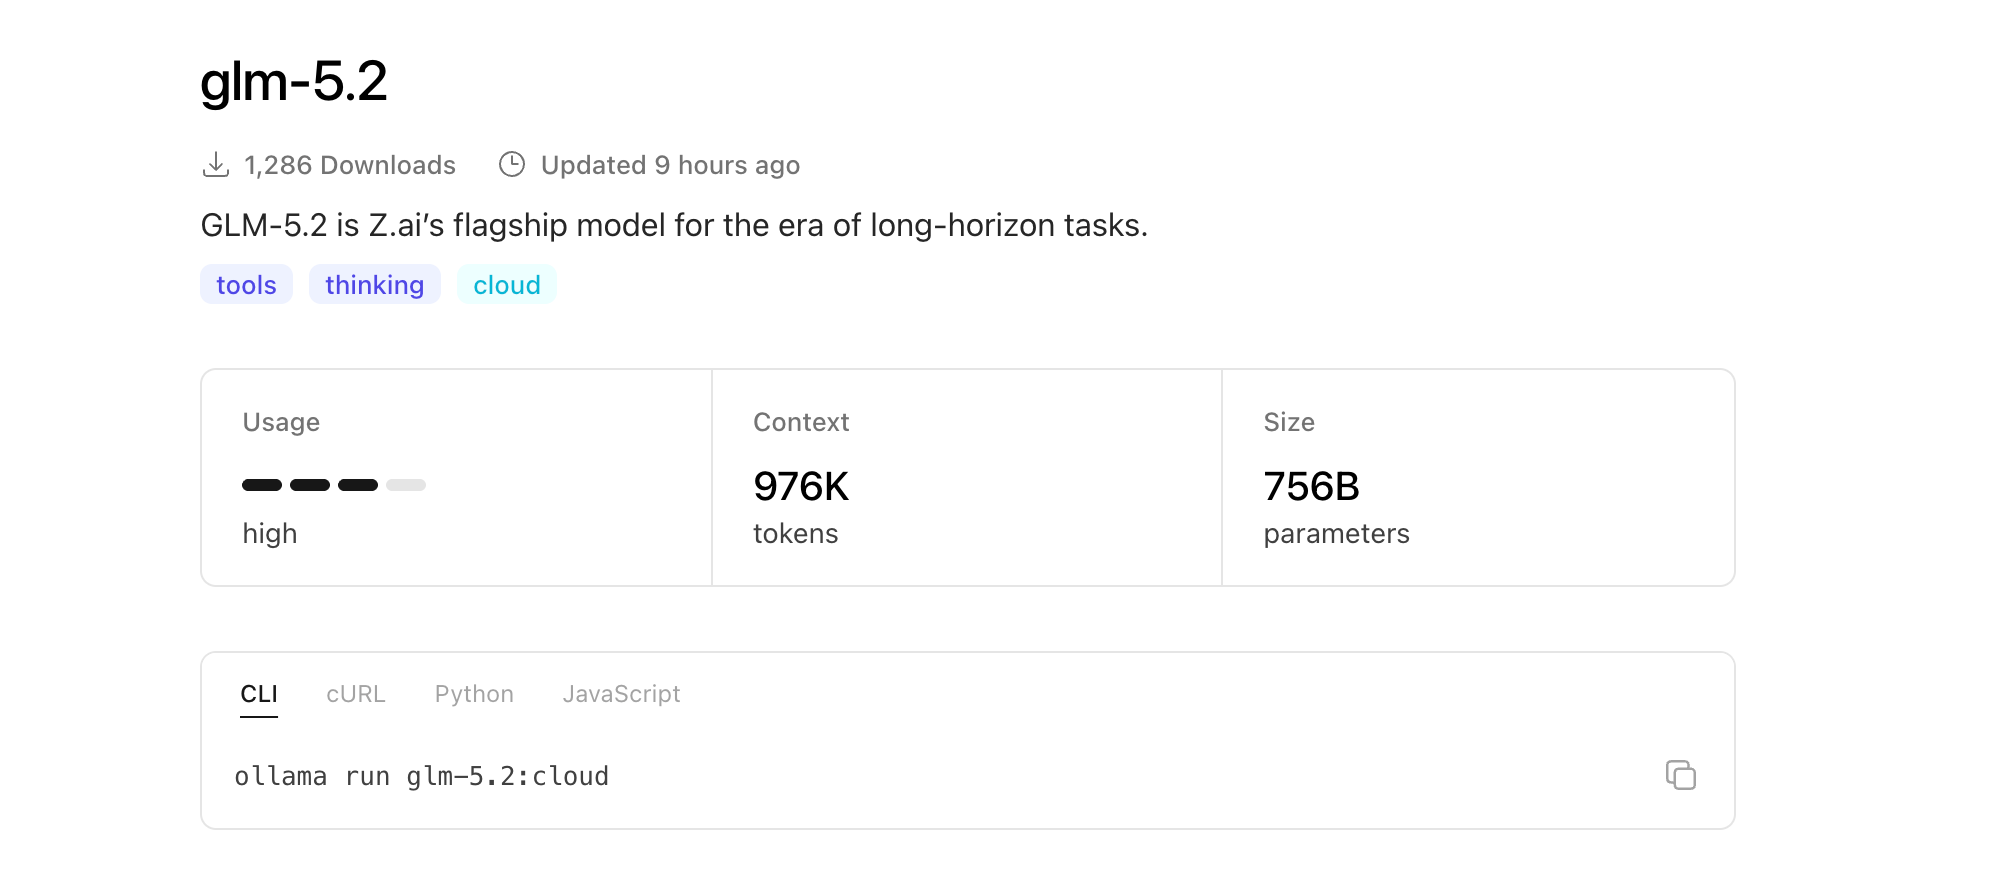
Ollamaはデフォルトで量子化されたバリアントを使用するため、このサイズのモデルでも一般消費者向けのハードウェアで実行可能となります。OllamaのローカルなOpenAI互換エンドポイントを介してアクセスすることもできます。
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.2",
    "messages": [{"role": "user", "content": "Write a Python function to parse an RFC 3339 timestamp."}]
  }'
RAMとVRAMに注意してください。モデルがディスクにスピルすると、生成速度が極端に低下します。量子化ビルドと十分なユニファイドメモリ、またはマルチGPU分割が、使用可能か不可能かの分かれ目となります。
詳細なローカルでの手順が必要な場合は、前世代からのパターンがほぼそのまま適用されます。完全なセットアップ、量子化の選択、およびトラブルシューティングについては、「GLM-5を無料でローカルで実行する」と「OllamaでGLM-5を無料で利用する」を参照してください。モデルタグをglm-5.2に置き換えれば、ワークフローは同じです。
vLLMでGLM-5.2を実行する
スループットと複数のリクエスト処理には、vLLMが本番環境レベルの選択肢です。vLLMはGPU間でのテンソル並列処理を扱い、これが実際に753BのMoEを適合させる方法です。
pip install vllm

python -m vllm.entrypoints.openai.api_server \
  --model zai-org/GLM-5.2 \
  --tensor-parallel-size 8 \
  --max-model-len 131072
この--tensor-parallel-size 8は8つのGPUを前提としています。正確な数は、使用するカードと、量子化されたチェックポイントをロードするかどうかによって異なります。vLLMはOpenAI互換のサーバーを公開しているため、チャット補完形式を話すクライアントであれば変更なしで動作します。1Mトークンのコンテキスト(1,048,576トークン)は主要な機能ですが、100万トークンのKVキャッシュを保持するには大量のメモリが必要となるため、--max-model-lenは実際に必要な値に設定してください。
ルート2:z.aiの無料トライアルクレジットとレート制限付きティア
セルフホスティングが手の届かない場合、次に安価な方法はz.ai独自のプラットフォームです。新規アカウントは通常**無料トライアルクレジット**を受け取ることができ、軽い実験用の**レート制限付き無料ティア**も通常存在します(2026年6月時点。トライアルの条件は頻繁に変更されるため、z.aiで現在の提供状況を確認してください)。
これは、セットアップなしで実際のモデルを試す最も速い方法です。アカウントを作成し、APIキーを取得して、OpenAI互換のエンドポイントを呼び出します。
curl https://api.z.ai/api/paas/v4/chat/completions \
  -H "Authorization: Bearer $ZAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.2",
    "messages": [{"role": "user", "content": "Explain IndexShare sparse attention in two sentences."}],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "max"
  }'
これらのクレジットを使う際に知っておくべきGLM-5.2のいくつかの具体的な点:
thinkingは推論のオン/オフを切り替えます。コーディングの場合、z.aiはreasoning_effort: "max"を介してMaxの推論努力レベルを推奨しています。努力レベルはHighとMaxの2つがあります。- 出力長はz.aiのドキュメントによると最大128Kとされていますが、二次情報源には常に記載されているわけではないため、これは厳密な保証ではなく、実際に確認すべき数値として扱ってください。
トライアルクレジットはいずれ期限切れになります。期限切れになった場合は、有料プランに移行するか、セルフホスティングに戻るかのどちらかになります。全パラメータの詳細は、z.aiのGLM-5.2ガイドに記載されています。
ルート3:最も安価な有料プラン(ほぼ無料)
無料クレジットがなくなると、コストをほぼゼロに抑える2つの方法があります。
GLMコーディングプランLite
主な用途がコーディングである場合、GLMコーディングプランは価値のある選択肢です。エントリーレベルのLiteティアは月額約$12です(2026年6月時点。公開されているティアは情報源によって異なるため、z.aiで現在の料金を確認してください)。これにより、計測されるトークンではなく定額の月額料金でコーディングアクセスが得られ、毎日のヘビーユースが予測可能になります。
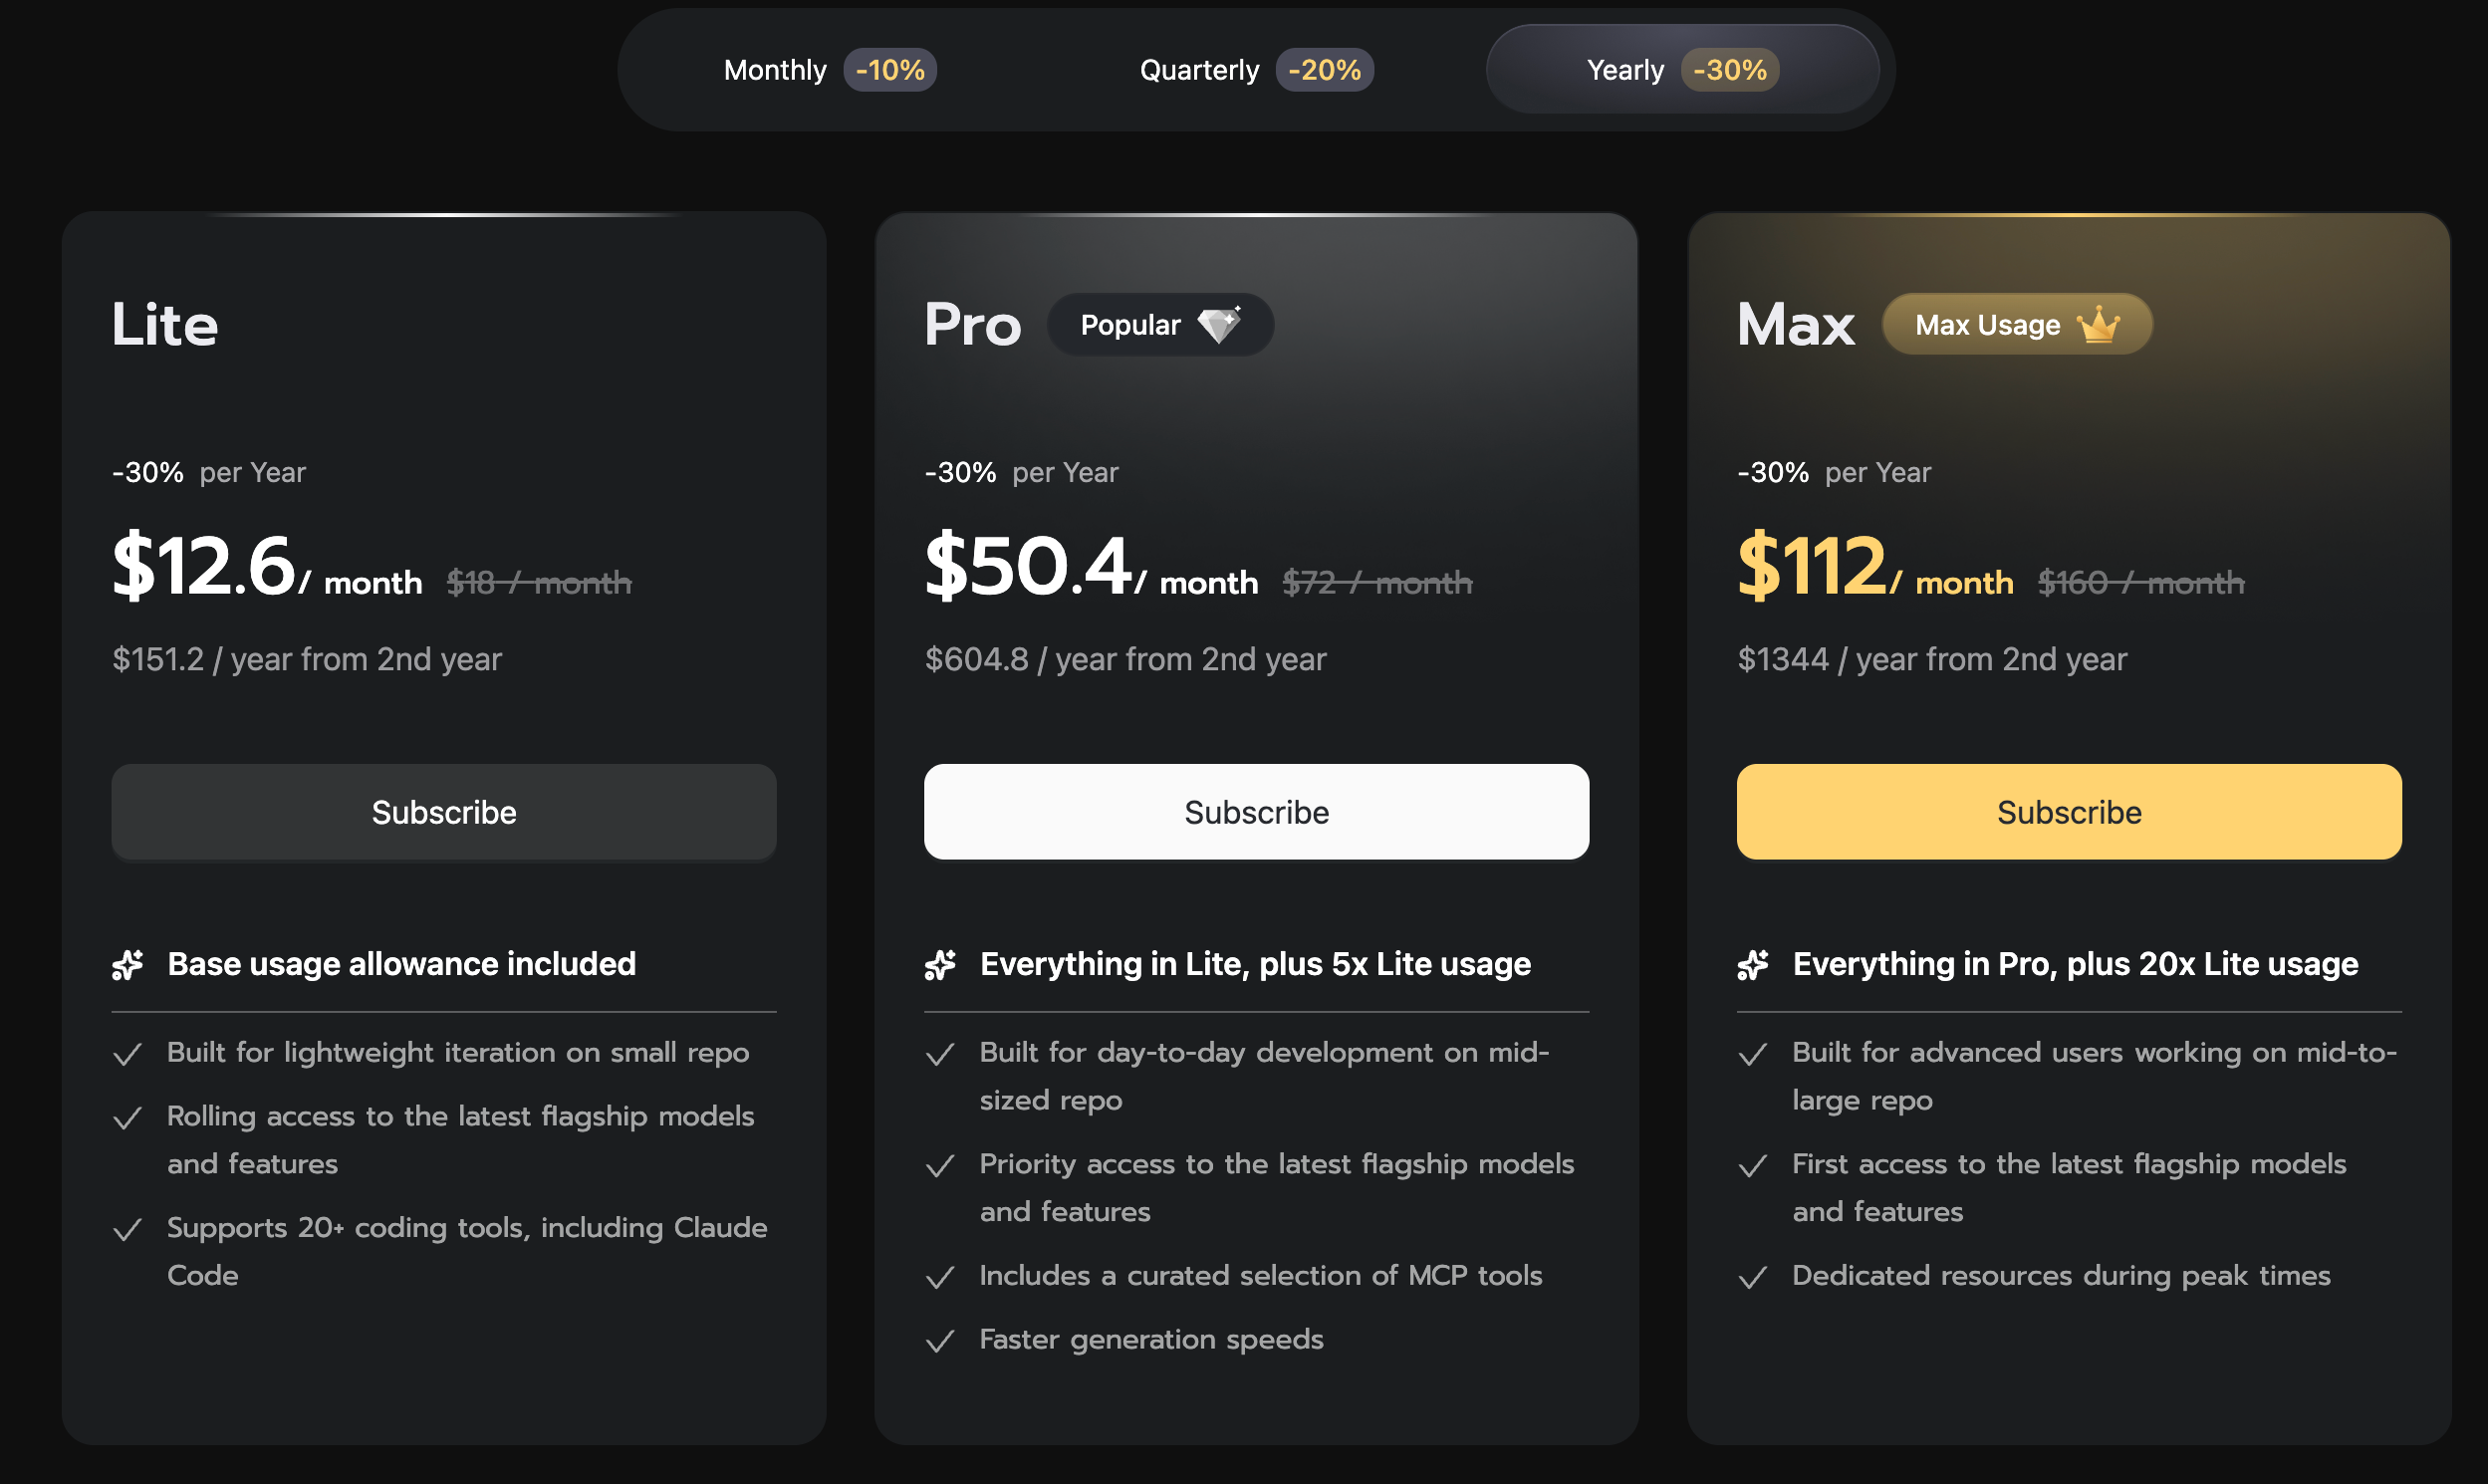
コーディングプランはAnthropic互換のパスもアンロックするため、Claude Code、Cline、またはCursorをGLM-5.2に向けることができます。コーディングのベースURLはhttps://api.z.ai/api/coding/paas/v4です(一部の情報源ではopen.z.ai/api/paas/v4と表示されているため、実際に確認してください)。動作するClaude Code環境は次のようになります。
export ANTHROPIC_BASE_URL="https://api.z.ai/api/coding/paas/v4"
export ANTHROPIC_API_KEY="your-glm-coding-plan-key"
export ANTHROPIC_DEFAULT_SONNET_MODEL="glm-5.2[1m]"
export ANTHROPIC_DEFAULT_OPUS_MODEL="glm-5.2[1m]"
export CLAUDE_CODE_AUTO_COMPACT_WINDOW=1000000
export API_TIMEOUT_MS=3000000
[1m]の接尾辞は1Mコンテキストのバリアントを選択します。API_TIMEOUT_MSを高く設定しないと、Claude Codeは長い大コンテキストの呼び出しが完了する前に終了させてしまいます。より詳細なエージェントツール連携の手順については、「Claude Code、Cline、CursorでGLM-5.2を使用する」と前世代の「Claude CodeでGLM-5.1を使用する」ガイドを参照してください。
キャッシュ入力の料金と従量課金制
サブスクリプションなしでAPIにアクセスする場合、標準の一般的なAPIは、OpenRouterで確認されたように、**入力100万トークンあたり$1.40、出力100万トークンあたり$4.40**です。z.aiを直接呼び出すか、従量課金制でOpenRouterを介してルーティングするかに関わらず、同じ料金が適用されます。
ここでの「ほぼ無料」のトリックは**キャッシュ入力**です。VentureBeatによると、100万トークンあたり約$0.26と報告されており(適宜出典を明記)、キャッシュ入力は、長いシステムプロンプトや繰り返しクエリをかける固定のコードベースなど、繰り返されるコンテキストのコストを大幅に削減します。ワークロードが同じプレフィックスを再利用する場合、一度だけ全額を支払い、その後はわずかな料金で済みます。長期間にわたるコーディングについて、VentureBeatはGLM-5.2が「長期間にわたるコーディングにおいて、GPT-5.5を約6分の1のコストで打ち負かす」と指摘しており、これが経済的な議論を簡潔に表しています。
もう一度、明確に言います:glm-5.2向けの**無料のOpenRouterティアはありません**。OpenRouterは安価ですが、無料ではありません。もし別のガイドがそう主張しているなら、それは間違いです。
無料 vs ほぼ無料:正直な比較
| 経路 | 初期費用 | 継続費用 | セットアップ労力 | 最適な用途 |
|---|---|---|---|---|
| セルフホスト (Ollama/vLLM) | ハードウェアまたはレンタル | 電気代 / GPU使用時間 | 高 | プライバシー、計測なし、完全な制御 |
| z.aiトライアルクレジット | なし | クレジット終了まで無料 | 低 | 最初の試用、迅速なテスト |
| GLMコーディングプランLite | 〜$3-6/月(要確認) | 月額定額 | 低 | Claude Code/Cline/Cursorでの日常的なコーディング |
| API + キャッシュ入力 | なし | 100万トークンあたり$1.40/$4.40;キャッシュ利用時は約$0.26 | 低 | アプリケーション、繰り返しコンテキストのワークロード |
役立つパターンとして:まずトライアルクレジットでアイデアを検証し、それから決定してください。毎日実行し、それがコーディングであれば、Liteプランを選びましょう。プライバシーが必要な場合や、トークンごとの課金から完全に逃れたい場合は、セルフホスティングに投資してください。再利用可能なコンテキストを持つ製品を構築している場合は、キャッシュ付きAPIが最も安価で信頼できる基盤となります。
Apidogで無料のGLM-5.2エンドポイントをテストする
GLM-5.2を無料か有料かに関わらず、どのように動作させるにしても、アプリに組み込む前にエンドポイントが実際に機能することを確認したいでしょう。ローカルのOllamaサーバーであれ、vLLMインスタンスであれ、z.aiのクラウドAPIであれ、レスポンスは検査する必要があるストリーミング形式のチャット補完ペイロードです。
Apidogはまさにこの目的のためのオールインワンAPIプラットフォームです。GLM-5.2エンドポイントにリクエストを送信し、ストリーミングされたServer-Sent Eventsがリアルタイムでレンダリングされるのを確認し、リクエストを再利用可能なケースとして保存し、モデルが稼働する前にフロントエンドがそれに対して構築できるようにレスポンスをモックすることができます。Ollamaの場合はhttp://localhost:11434に、クラウドの場合はz.aiのベースURLに向けて、Authorizationヘッダーを設定すれば、1分で繰り返し可能なテストハーネスが手に入ります。Apidogをダウンロードして、あなたが選んだ無料ルートの隣に置いておきましょう。
よくある質問
GLM-5.2は実際に無料で利用できますか? ウェイトはMITライセンスのもとで無料なので、セルフホスティングにライセンス費用はかかりません。ハードウェアやGPUのレンタル費用は依然として支払う必要があります。ホスト型APIは有料ですが、z.aiは通常、開始用のトライアルクレジットとレート制限付きティアを提供しています(現在の提供状況を確認してください)。
通常のノートパソコンでOllamaを使ってGLM-5.2を無料で実行できますか? 現実的には、できません。これは約753BのMoEモデルであり、量子化されたビルドでさえかなりのメモリを必要とします。Ollamaはコマンドを簡単にしますが、ハードウェアの敷居は高いです。高VRAMワークステーション、大容量のユニファイドメモリを搭載したMac、またはレンタルGPUが必要です。サイズの詳細については、ローカルの詳細解説を参照してください。
GLM-5.2の無料OpenRouterティアはありますか? ありません。OpenRouterは、GLM-5.2を従量課金制で、入力100万トークンあたり$1.40、出力100万トークンあたり$4.40で提供しています。安価ですが、無料ではありません。無料のOpenRouterの利用経路があると主張する情報源は信用しないでください。
GLM-5.2をコーディングに使う最も安価な有料方法は? GLMコーディングプランLiteティアで、2026年6月現在で月額およそ$3-6です(z.aiで確認してください)。これにより、定額のコーディングアクセスが提供され、Claude Code、Cline、Cursor向けのAnthropic互換エンドポイントがアンロックされます。
GLM-5.2はコスト面でGPT-5.5と比較してどうですか? VentureBeatによると、GLM-5.2はいくつかの長期間のコーディングベンチマークでGPT-5.5を約6分の1のコストで上回ります。詳細な数値については、GLM-5.2ベンチマークの内訳と直接比較を参照してください。
次にするべきこと
最も安価なルートは、お使いのハードウェアと実行頻度によって全く異なります。メモリの制約をクリアできれば、セルフホスティングはプライバシーと計測なしという点で優れています。トライアルクレジットとLiteプランは利便性で勝ります。キャッシュ入力付きAPIは、コンテキストを再利用するアプリケーションに最適です。
GLM-5.2がそもそも適切なモデルであるかどうかまだ迷っている場合は、GLM-5.2とは何か、そしてGLM-5.1と比較してどうかに目を通してください。それを使って構築する準備ができたら、GLM-5.2 APIガイドと料金の内訳で残りの情報がカバーされており、その間のテストはApidogが対応します。