Anthropicは2026年6月9日にClaude Fable 5をリリースしました。その価格設定は、現実的な決断を迫るものです。Claude Fable 5とOpus 4.8の比較は、本質的には費用の問題です。Fable 5はOpus 4.8のちょうど2倍のトークンあたりの費用がかかります。入力はOpus 4.8の100万トークンあたり5ドルに対し、Fable 5は10ドル、出力はOpus 4.8の25ドルに対し、Fable 5は50ドルです。したがって、ベンチマークの主張を読む前に、計算は明確です。同じベンダー、同じMessages APIでありながら、新しいモデルには2倍のプレミアムがかかります。興味深いのは、そのプレミアムがいつ元が取れるのか、そしていつ無駄な出費になるのかを見極めることです。古いモデルに関する詳細な情報が必要な場合は、弊社のClaude Opus 4.8ガイドでその内容とラインナップでの位置付けについて解説しています。
要約
Claude Fable 5とOpus 4.8は同じファミリーのモデルです。Fable 5はトークンあたりの費用がOpus 4.8のちょうど2倍です(10ドル/50ドル対5ドル/25ドル)。ほとんどのチャット、コード生成、および検索作業では、Opus 4.8の方が賢明な選択です。何百万ものトークンにわたって一貫性を保つ、非常に長期的な自律作業が必要な場合にのみFable 5を使用してください。それ以外の場合は、費用を節約しましょう。
Claude Fable 5 vs Opus 4.8:比較概要
トレードオフを一目で確認できるよう、両モデルを並べて比較します。
| 項目 | Claude Fable 5 | Claude Opus 4.8 |
|---|---|---|
| APIモデルID | claude-fable-5 |
claude-opus-4-8 |
| 入力価格(100万トークンあたり) | $10.00 | $5.00 |
| 出力価格(100万トークンあたり) | $50.00 | $25.00 |
| 相対コスト | Opus 4.8の2倍 | 基準 |
| コンテキスト | 数百万トークンにわたって機能;公開されている固定数値なし | 100万トークンのコンテキストウィンドウ |
| 思考と労力 | 適応的思考 | 適応的思考 + 労力(低/中/高/超高/最大) |
| 位置付け | 一般利用向けに安全化されたMythosクラスモデル;Anthropicが一般公開した中で最も高性能 | 非常に高性能;Fable 5登場前はAnthropicが一般公開した中で最も高性能なモデル |
| 最適な用途 | 非常に長期的な自律作業、大規模な移行、複数時間エージェント | ほとんどのチャット、コード生成、RAG、およびインタラクティブなワークロード |
コンテキストに関する注意点:AnthropicはFable 5の正確なコンテキストウィンドウの数値を公開していません。同社は数百万トークンにわたって集中力を維持すると説明しており、その長いコンテキストの動作は、固定できる仕様というよりは質的な強みとして捉えるべきです。一方、Opus 4.8には、文書化された100万トークンのウィンドウがあります。もしあなたの決定が正確なコンテキスト数値に依存するなら、Opus 4.8が設計ドキュメントで引用できる数値を持つモデルです。Anthropicのモデル概要ドキュメントには、ラインナップの公開仕様が記載されています。新しいモデルの分かりやすい紹介については、弊社のClaude Fable 5とは何かに関する解説が基本を網羅しており、Opus 4.8の価格内訳では費用面について詳しく掘り下げています。
価格:Fable 5はちょうど2倍の費用がかかる
これは、この比較全体で最も明確な事実なので、ここから始めましょう。
Fable 5は、入力トークン100万個あたり10ドル、出力トークン100万個あたり50ドルです。Opus 4.8は、入力100万個あたり5ドル、出力100万個あたり25ドルです。入力レートも出力レートも2倍です。アスタリスクや、比率が変わるような階層的な割引、あるいは長文コンテキストに対する追加料金などもありません。Fable 5は全体的にOpus 4.8の2倍の費用がかかります。最新の料金は、Anthropicの料金ページで確認できます。
1,000トークンあたりの費用は以下の通りです。
- Fable 5:入力 $0.010、出力 $0.050
- Opus 4.8:入力 $0.005、出力 $0.025
これらの数値は単独で見ると非常に小さく見えますが、それこそがチームの予算管理が難しくなる原因です。一度ボリュームが増加すれば、比率が重要になります。
現実的な月間例を挙げてみましょう。あるプロダクション機能が月に2億の入力トークンを処理し、4000万の出力トークンを生成するとします。Opus 4.8の場合、2億 x 5ドル + 4000万 x 25ドルとなり、1,000ドル + 1,000ドル = 2,000ドルです。Fable 5の場合、同じワークロードで2億 x 10ドル + 4000万 x 50ドルとなり、2,000ドル + 2,000ドル = 4,000ドルです。同じトークン数、同じ作業で、2,000ドル対4,000ドルとなります。プレミアムは使用量に比例して増加するため、毎日終日実行されるワークロードの場合、モデル文字列を切り替えた瞬間にモデル費用が2倍になります。
この見方は重要です。なぜなら、アップグレードの決定は「Fable 5の方が優れているか」ではないからです。ほとんどの場合、優れています。決定は「Fable 5が、この特定の項目を2倍にする費用を正当化するほど十分に優れているか」です。低ボリュームの社内ツールの場合、月2,000ドルの追加は微々たるものかもしれません。しかし、高ボリュームの顧客向けエンドポイントの場合、健全な利益と赤字の分かれ目になる可能性があります。モデルではなく、ワークロードに価格を設定してください。安価なオプションについてより詳細な費用分析が必要な場合は、弊社のOpus 4.8料金分析をご覧ください。新しいモデルの料金表については、Claude Fable 5料金ガイドに詳細が記載されています。
能力:Fable 5が優位に立つ点
Fable 5はOpus 4.8の単なるマーケティング的な再パッケージではありません。これは真に優れた能力を持つモデルであり、その差は特に長期的で自律的な作業において最も明確に現れます。
AnthropicはClaude Fable 5の発表で、Fable 5を一般利用向けに安全化されたMythosクラスのモデルであり、同社が一般公開した中で最も高性能なモデルであると説明しています。これは、非常に長期的な自律作業向けに構築されており、数百万のトークンにわたって集中力を維持します。この最後のフレーズが、その全体的なセールスポイントです。多くのモデルは優れた関数を作成したり、質問に答えたりすることができます。しかし、何時間も稼働し、膨大なコンテキストにわたって一貫した計画を維持し、最終的に良い決定を下せるモデルははるかに少ないです。
最も明確な実証はStripeの事例です。Fable 5は、Stripeの5,000万行のRubyコードベース移行を1日で完了させました。これはチームが見積もっていた2ヶ月以上かかる作業でした。これはベンチマークの抽象化ではありません。トークンあたりの生データ品質ではなく、一貫性の維持がボトルネックとなる規模での、実際のコードベースの実際の移行です。数十万トークン後に逸脱したり、話の筋を見失ったりするモデルでは、どんな価格であってもこの仕事をこなすことはできません。これがFable 5が構築されたワークロードです。
メモリがこの差を拡大させます。Slay the Spireのテストでは、Fable 5に永続的なファイルメモリを与えることで、Opus 4.8に対して3倍の改善が見られました。この教訓はカードゲームにとどまらず広く一般化できます。タスクが多くのステップに及び、モデルが自身にメモを書き込み、それを読み返すことができる場合、Fable 5はそのメモリを複合して、長期間にわたる実行で著しく優れた結果を生み出します。もしエージェントが長いセッションにわたってスクラッチパッド、計画ファイル、または構造化されたメモリストアを維持する場合、それはFable 5の長期的な強みが測定可能な成果につながるまさにその設定です。
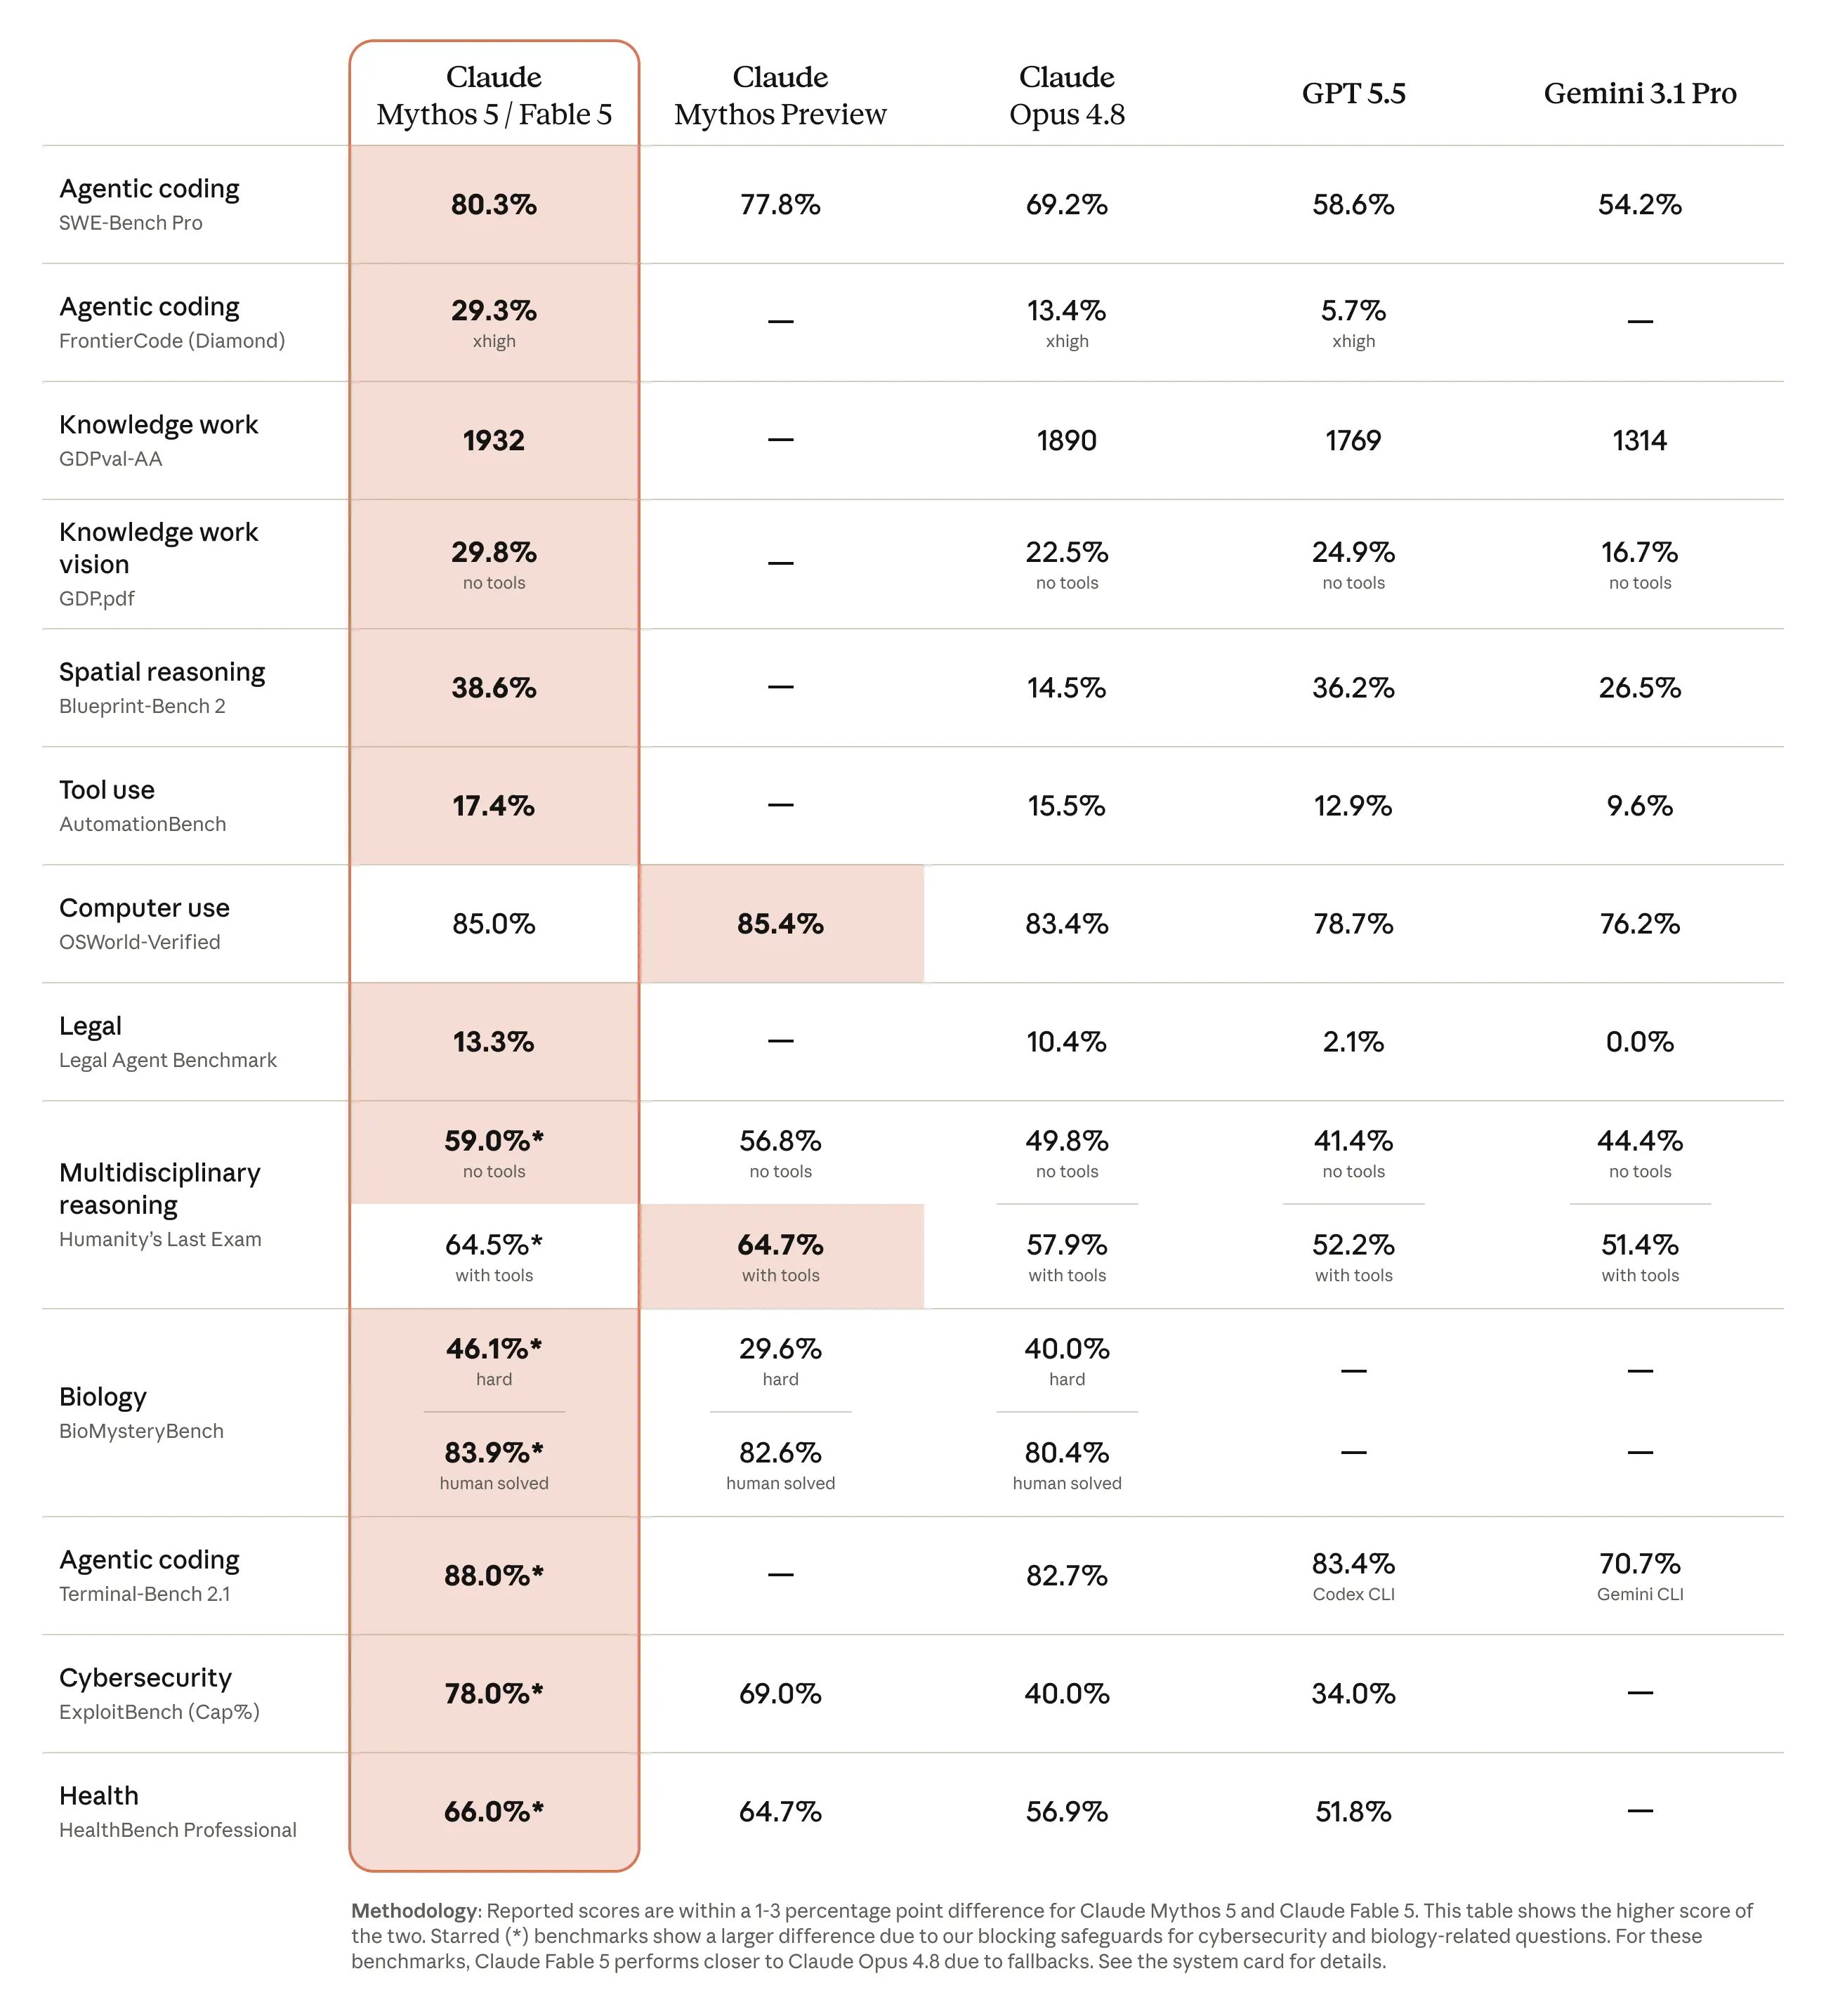
ベンチマークでは、Fable 5はほとんどすべてのベンチマークで最先端の成績を収めました。CognitionのFrontierCodeおよびFrontierBench、CursorBench、HebbiaのFinance Benchmarkなどでトップを記録しました。Anthropicはこれらの公開スコアをリリースしていないため、これらの成績は引用すべき数値としてではなく、方向性を示すものとして扱ってください。このパターンは一貫しています。Fable 5はコーディング、エージェント的、金融関連の評価でリードしています。ここでの要点はリーダーボードの差分ではありません。それは、高価な現実世界の作業に対応するような、難しく多段階のタスクにおいて、このモデルがトップクラスまたはその近くに位置しているということです。
公平な比較のために知っておくべきもう1つのこととして、Fable 5には、特定の機密性の高いクエリ、サイバーセキュリティ、生物学および化学、モデル蒸留の要求を、直接回答するのではなくOpus 4.8にルーティングするセーフガードが搭載されています。Anthropicによると、これがトリガーされるのはセッションの5%未満であり、通常の利用に影響することはめったにありませんが、これは実際の動作上の違いです。ほとんどのワークロードではこれを見ることはないでしょう。他のベンダーとの直接比較については、弊社のOpus 4.8対GPT-5.5およびGemini 3.5の比較と、それに対応するFable 5対GPT-5.5およびGemini 3.5の比較記事で、各モデルをより広範な分野と比較しています。
Opus 4.8がより賢明な選択肢となる場合
ここでは、新モデル発表で言及されがちな部分が省かれています。多くの本番環境での作業において、Opus 4.8は経済的に見てはるかに優れた選択肢です。
Opus 4.8は、Fable 5が登場するまでAnthropicが一般公開していた中で最も高性能なモデルでした。Fable 5がリリースされたからといって、その性能が低下したわけではありません。今でも、文書化された100万トークンのコンテキストウィンドウ、適応的思考、そして低から最大までの全範囲の労力設定を備えた、強力な最先端モデルです。ほとんどのチャットインターフェース、ほとんどのコード生成、そしてほとんどの検索拡張生成において、Opus 4.8はトークンあたりの費用が半分でありながら、優れた結果を生み出します。もしタスクが100万トークン内に収まり、1回のターンまたは短いループで解決できるのであれば、Fable 5を選択すると、使用しない余力に対して2倍の費用を支払っている可能性が非常に高いです。
以下の3つのワークロードタイプは、Opus 4.8を強く推奨します。
- インタラクティブなチャットやアシスタント。各ターンが短く、レイテンシが重要であり、モデルが長時間にわたる計画を維持する必要がほとんどない場合。
- 関数、ファイル、またはプルリクエストレベルでのコード生成とレビュー。コンテキストが限定されており、タスクが迅速に完了する場合。
- RAGおよびドキュメントQ&A。関連するコンテキストを100万トークンのウィンドウに詰め込み、焦点を絞った質問をする場合。ここではウィンドウが資産であり、Opus 4.8にはそれが明示的にあります。
Fable 5自身の設計にも、控えめながら説得力のある議論が隠されています。Fable 5がセーフガードカテゴリに該当する際、そのクエリはOpus 4.8にルーティングされます。新しいモデルは、機密性の高いケースでは文字通り古いモデルにフォールバックするのです。これは、Opus 4.8が信頼され、有能であり、実際のトラフィックにおいてフラッグシップの代わりを務めるのに十分優れているという強いシグナルです。Anthropicが販売する最も高価なモデルの安全ネットであるならば、日常のほとんどの要求に対しては十分に適切であると言えます。
したがって、費用を重視する場合のデフォルト設定は簡単です。Opus 4.8から始め、測定し、長期的な自律性が必要であることが証明された特定のワークロードのみをアップグレードします。もしOpus 4.8でさえワークロードに必要なものよりも多い場合、Claude Sonnet 4.6がその下に位置し、入力3ドル、出力15ドルで、高ボリュームでシンプルなタスクをはるかに低コストで処理します。安価なClaudeティアの設定詳細については、弊社のOpus 4.8 APIガイドで呼び出し方法を解説しています。
意思決定フレームワーク:どちらを選ぶべきか?
雰囲気で決めるのではなく、ワークロードによって選択しましょう。以下のルールはほとんどの実際のケースをカバーします。
- 短い、単一ターンのタスク(チャット、分類、抽出、短いコードスニペット): Opus 4.8を使用してください。Fable 5の長期的な利点はタスクで発揮されないため、2倍のプレミアムを支払っても何も得られません。
- 限定されたコード生成とレビュー(関数、ファイル、プルリクエスト): Opus 4.8を使用してください。優れた結果が得られ、費用は半分で、コンテキストにも収まります。
- RAG、ドキュメントQ&A、100万トークンウィンドウ内での分析: Opus 4.8を使用してください。文書化された100万トークンのウィンドウこそが支払うべき機能であり、Opus 4.8はそれを持っています。
- 非常に長い実行にわたって一貫性を保つ必要がある、数時間稼働する自律エージェント: Fable 5を使用してください。これはFable 5が構築されたワークロードであり、一貫性の差が価格を正当化します。
- 一度に膨大なコードベースにまたがる大規模な移行やリファクタリング: Fable 5を使用してください。Stripeの5,000万行の移行がその典型です。この規模では、持続的な集中がボトルネックとなり、Fable 5がそれを解消します。
- 永続的なメモリを持つ長期間稼働するエージェント: Fable 5を使用してください。3倍のメモリ結果は、長期間のセッションにおける複合的な効果が本物であることを示しています。
- コストが厳しい制約である場合: Opus 4.8を使用するか、高ボリュームでシンプルな作業にはSonnet 4.6に落としてください。Fable 5は本当に必要なごく一部のタスクのためにとっておきましょう。
メタ・ルール:デフォルトはOpus 4.8とし、長期的な自律性が必要であることが証明された場合にのみ、個別のワークロードをFable 5に昇格させてください。ある1つのジョブが恩恵を受けるからといって、全体的にコストを2倍にすることは、チームがフラッグシップモデルに過剰な支出をしてしまう最も一般的な方法です。
コードでの切り替え
この決定を検討している方にとって朗報です。切り替えは非常に簡単です。両モデルは同じMessages APIの背後に存在します。SDKの移行も、新しい認証フローも、リクエストボディの再構築も必要ありません。変更するのはモデルIDの文字列だけです。新しいモデルにはclaude-fable-5を、安価なモデルにはclaude-opus-4-8を使用します。
import anthropic

client = anthropic.Anthropic()

# より安価なフロンティア層のデフォルト
response = client.messages.create(
    model="claude-opus-4-8",          # フラッグシップモデルには"claude-fable-5"に切り替える
    max_tokens=16000,
    thinking={"type": "adaptive"},
    messages=[{"role": "user", "content": "この設計ドキュメントを要約し、未解決の質問をリストアップしてください。"}],
)

for block in response.content:
    if block.type == "text":
        print(block.text)
唯一の違いがモデル文字列であるため、リクエストごとにルーティングできます。日常的なトラフィックはclaude-opus-4-8に送信し、長期的な自律性が必要な少数のジョブには文字列をclaude-fable-5に切り替えることで、すべて同じクライアントと同じコードパスから処理できます。これにより、「デフォルトは安価なモデル、必要に応じてアップグレード」という戦略を簡単に実装できます。単一の設定値または1行の条件分岐で、特定の要求をどのモデルが処理するかを決定します。古いモデルの完全なリクエストインターフェースについては、弊社のOpus 4.8 APIウォークスルーをご覧ください。対応するFable 5 APIガイドでは新しいモデルについて解説しています。
Apidogで自分で比較してみる
料金表やベンチマークの主張だけでは、限界があります。あなたのワークロードにとってClaude Fable 5とOpus 4.8のどちらが最適かという問いに対する正直な答えを得るには、両方のモデルIDに同じプロンプトを送信し、返ってくる結果を見ることです。これはApidogがうまく処理します。
Anthropic Messages APIに対するリクエストを1つ設定し、それを複製してモデルフィールドだけを変更します。片方にはclaude-fable-5、もう片方にはclaude-opus-4-8を設定します。おもちゃのような質問ではなく、実際のプロダクションのトラフィックに似たプロンプトで両方を送信します。そして、2つの応答を並べて比較します。どちらの回答がより正確か、より完全か、そして品質の差があなたのユースケースにとって十分に重要であるかどうかを確認します。
Apidogは、コスト決定の根拠となる数値も表示します。各呼び出しのレイテンシを監視し、各応答から直接トークン使用量を読み取ることができます。これには、実際に支払う金額を決定する入力と出力のカウントも含まれます。両モデルの使用量を品質差の隣に置くと、2倍のプレミアムが抽象的なものではなくなります。あなたの実際のプロンプトに対して、Fable 5の出力が追加のトークンとドルの価値があるのか、あるいはOpus 4.8がすでにその仕事をこなしているのかを確認できます。2つのリクエストを小さなコレクションとして保存すれば、プロンプトが変更されたり新しいモデルがリリースされたりするたびに再実行できる反復可能なA/Bテストハーネスが手に入ります。試してみたい場合は、Apidogをダウンロードして、数分で2つのリクエストを作成してください。これは、もう1枚の仕様書を読むよりも確実な答えにたどり着くためのより速い道であり、Apidogはすべての比較を一箇所にまとめてくれます。