
Ketika xAI merilis Grok 4.5 pada 8 Juli 2026, Elon Musk memilih perbandingan itu sendiri: “model kelas Opus, namun lebih cepat, lebih efisien dalam penggunaan token, dan lebih murah.” Itu adalah klaim yang spesifik dan dapat diperiksa mengenai Claude Opus 4.8, model pengkodean andalan Anthropic.
Jadi, mari kita periksa. Perbandingan ini menggunakan angka yang diterbitkan xAI dalam pengumumannya, harga yang diterbitkan Anthropic, dan bagian-bagian cerita yang tidak disebutkan oleh kedua vendor dalam judul utama. Versi singkatnya: klaim tersebut sebagian besar benar, dengan dua kekalahan benchmark dan satu tanda bintang besar mengenai verifikasi.
Kartu skor
xAI menerbitkan empat benchmark pengkodean. Berikut adalah hasilnya, dengan kedua model beserta konteks terkini di sekitarnya:
| Benchmark | Grok 4.5 | Opus 4.8 (maks) | Pemenang |
|---|---|---|---|
| DeepSWE 1.0 (pass@1) | 62.0% | 55.75% | Grok 4.5 (+6.25) |
| DeepSWE 1.1 | 53% | 59% | Opus 4.8 (+6) |
| Terminal Bench 2.1 | 83.3% | 78.9% | Grok 4.5 (+4.4) |
| SWE Bench Pro (resolusi) | 64.7% | 69.2% | Opus 4.8 (+4.5) |
Masing-masing dua kemenangan. Pada grafik xAI sendiri, "kelas Opus" akurat sebagai tingkat kemampuan tetapi salah sebagai klaim superioritas, yang, patut diakui untuk xAI, bukanlah klaim yang dibuat Musk.
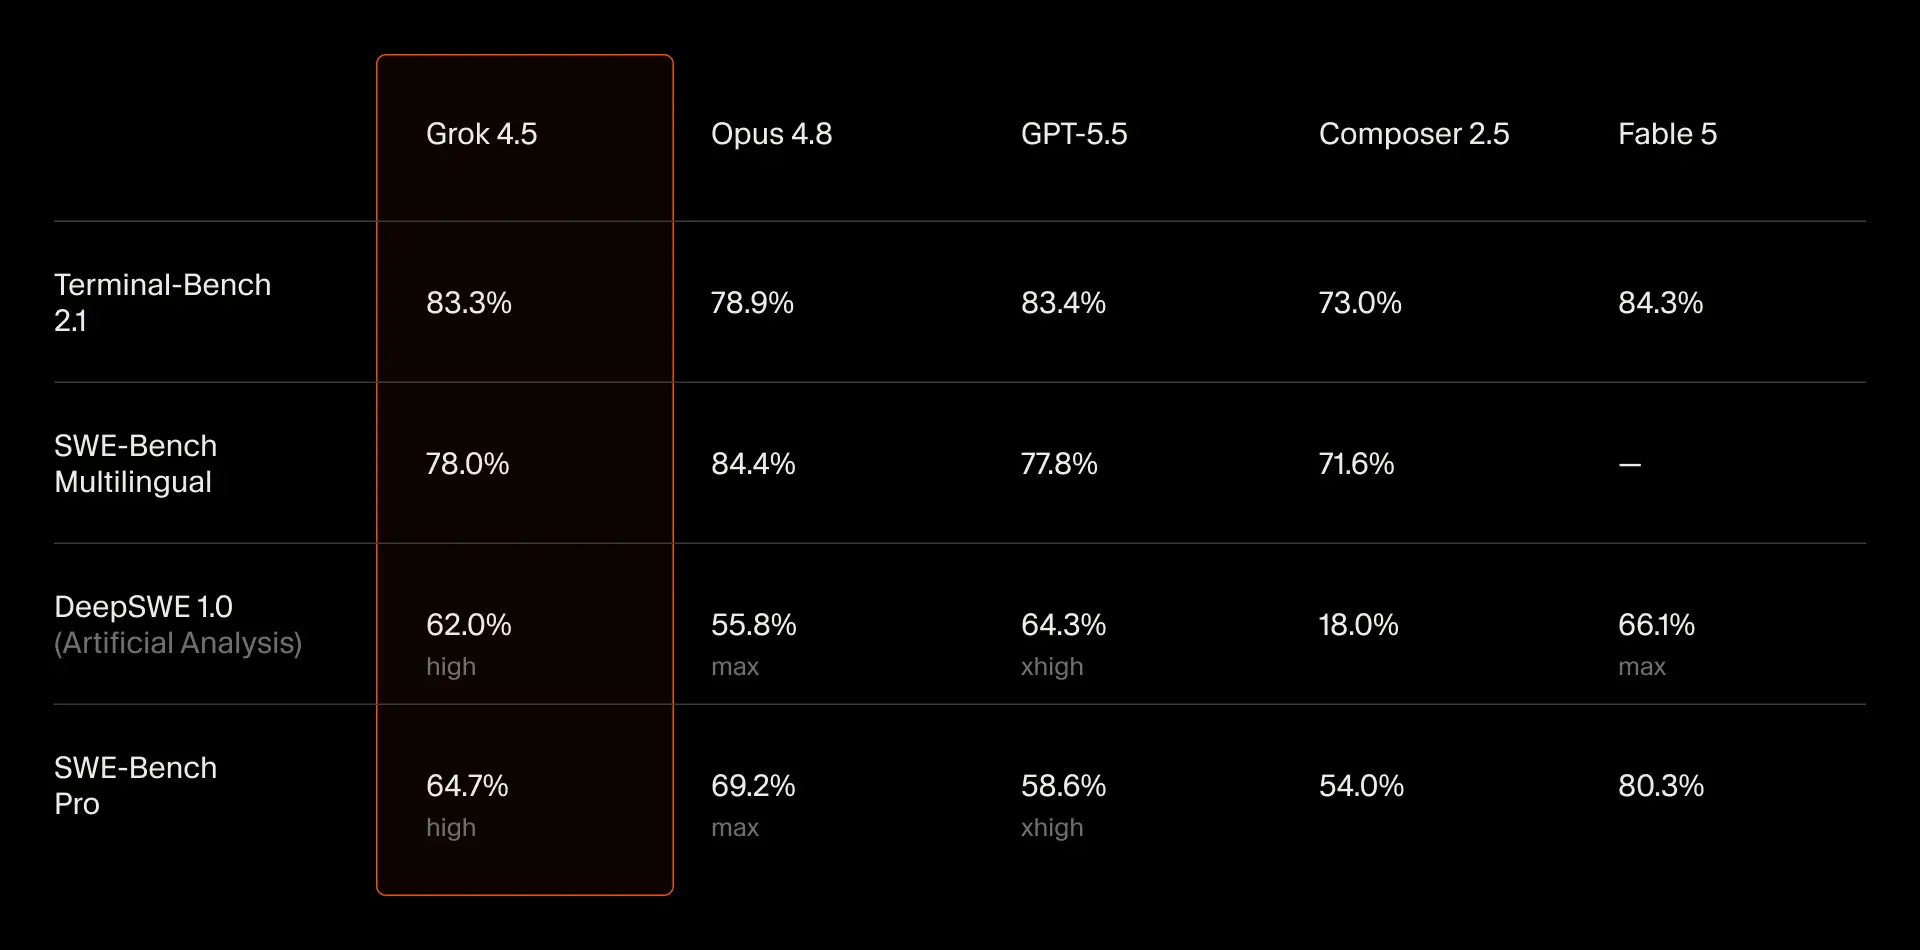
Perlu dicatat: Claude Fable 5 (maks) menduduki puncak keempat grafik ini (66.1 / 70 / 84.3 / 80.4), dan GPT 5.5 (xhigh) mengalahkan kedua model pada tiga dari empat grafik. Grok 4.5 bersaing di tingkat di bawah batas terdepan, melawan model yang dihargai Anthropic untuk pekerjaan sehari-hari, bukan untuk kemampuan puncak. Jika Anda menginginkan pertarungan terdepan, itu adalah Fable 5 vs Opus 4.8.
Tanda bintang asal usul
Ini bukan hasil tes independen. xAI mencatat bahwa angka pesaing berasal dari “kartu sistem atau papan peringkat benchmark yang diterbitkan oleh masing-masing pengembang,” dengan evaluasi DeepSWE dibuat oleh Datacurve dan dijalankan dengan alat bantu masing-masing penyedia. Itu lebih baik daripada pelaporan mandiri yang tidak jelas, tetapi mencampur sumber berarti perbedaan alat bantu dan kerangka kerja dapat mempengaruhi perbandingan. Belum ada pihak ketiga yang sepenuhnya independen yang telah melakukan benchmark Grok 4.5. Penelusuran mendalam benchmark kami melacak situasi tersebut.
Harga: Grok menang di atas kertas, lebih besar dalam praktik
Harga stiker per juta token:
| Grok 4.5 | Opus 4.8 | |
|---|---|---|
| Input | $2.00 | $5.00 |
| Output | $6.00 | $25.00 |
Itu adalah 40% dari harga input Opus dan 24% dari harga outputnya. (Rincian lengkap dari Anthropic dapat ditemukan di analisis harga Opus 4.8 kami.)
Jeda melebar ketika Anda mempertimbangkan verbositas. xAI melaporkan Grok 4.5 menyelesaikan tugas SWE Bench Pro dengan rata-rata 15.954 token output; Opus 4.8 (maks) rata-rata 67.020 pada benchmark yang sama. Kalikan per tugas yang diselesaikan:
- Grok 4.5: 15.954 token × $6/Jt ≈ $0.10 output per tugas
- Opus 4.8 (maks): 67.020 token × $25/Jt ≈ $1.68 output per tugas
Kira-kira 17 kali lebih murah pada output per tugas yang diselesaikan, berdasarkan jumlah token yang dilaporkan vendor. Perlakukan kelipatan pastinya dengan hati-hati (satu benchmark, satu pengukuran vendor, dan mode upaya “maks” meningkatkan jumlah token Opus), tetapi arahnya sulit diperdebatkan: model ringkas seharga $6 mengalahkan model bertele-tele seharga $25 lebih dari yang disarankan lembar harga. Kami menjalankan skenario yang lebih lengkap dalam penjelasan harga Grok 4.5.
Peringatan ini berlaku juga sebaliknya: Opus kehilangan lebih banyak token per tugas sebagian karena mode “maks” membutuhkan alasan yang panjang, dan alasan tersebut adalah bagian mengapa ia memenangkan SWE Bench Pro sebesar 4,5 poin. Anda membayar untuk berpikir. Terkadang, pemikiran itu adalah produknya.
Kecepatan: 80 TPS dan jawaban lebih pendek saling melengkapi
Grok 4.5 beroperasi sekitar 80 token per detik, yang disebut xAI sebagai “kecepatan model cepat.” Dikombinasikan dengan output yang seperempat lebih pendek, waktu nyata per tugas berkurang dua kali lipat: token lebih sedikit, dikirim lebih cepat. Untuk loop agen yang merangkai puluhan panggilan model, latensi per langkah terakumulasi menjadi menit yang dihemat per sesi.
Anthropic tidak mempublikasikan angka TPS yang setara untuk Opus 4.8, dan kecepatan dunia nyata bervariasi berdasarkan beban dan tingkatan, jadi ukur benchmark ini pada lalu lintas Anda sendiri daripada mempercayai halaman pemasaran mana pun.
Di mana Opus 4.8 mempertahankan keunggulannya
Harga bukanlah segalanya, dan kartu skor menyebutkan tempat-tempat yang tidak demikian:
- Pengkodean agen paling sulit. SWE Bench Pro, yang paling mendekati pekerjaan repo nyata yang rumit dari keempatnya, dimenangkan oleh Opus dengan 4,5 poin. DeepSWE 1.1, revisi yang lebih baru, dimenangkan oleh Opus dengan 6 poin.
- Kematangan ekosistem. Opus 4.8 terintegrasi ke dalam Claude Code, pola penggunaan alat yang telah mapan, dan satu tahun pengerasan produksi. Grok 4.5 baru diluncurkan kemarin; antarmuka integrasinya adalah Grok Build, Cursor, dan API baru. Biaya migrasi adalah nyata meskipun biaya per token lebih rendah.
- Prediktabilitas. Perilaku Opus dalam konteks panjang, pola penolakannya, dan mode kegagalannya telah didokumentasikan dengan baik, termasuk oleh kami. Grok 4.5 baru berumur seminggu.
Mana yang harus Anda gunakan?
Pilih Grok 4.5 jika beban kerja Anda adalah pengkodean agen bervolume tinggi atau pekerjaan pengetahuan, tagihan API Anda adalah item yang Anda perhatikan, dan pembagian benchmark 2 dari 4 dengan seperempat harga output terdengar seperti arbitrase. Harga peluncuran ditambah periode gratis saat ini membuat mencobanya hampir tanpa biaya bulan ini.
Tetap gunakan Opus 4.8 jika Anda sudah mendalami ekosistem Anthropic, Anda membutuhkan skor yang dipublikasikan paling kuat pada benchmark tingkat repo yang sulit dalam kelas harga ini, atau Anda tidak dapat menerima risiko model minggu pertama dalam produksi.
Bagaimanapun, ukur sendiri. Kedua API berbicara bentuk yang kompatibel dengan OpenAI, jadi alat bantu A/B mudah dibuat. Di Apidog, simpan satu permintaan per model, arahkan ke lima prompt nyata tersulit Anda, dan bandingkan kualitas output, latensi, dan objek penggunaan secara berdampingan. Tegaskan secara khusus pada output_tokens: jika jawaban Grok pada prompt Anda tidak lebih pendek, ekonomi di atas tidak berlaku untuk Anda. Unduh Apidog gratis dan jalankan perbandingan pada lalu lintas Anda sendiri sebelum memindahkan beban kerja.
Panduan pengaturan untuk kedua sisi: cara menggunakan API Grok 4.5 dan cara menggunakan API Claude Opus 4.8.
FAQ
Apakah Grok 4.5 lebih baik dari Claude Opus 4.8? Mereka membagi benchmark yang diterbitkan xAI 2-2. Grok 4.5 lebih murah dan lebih efisien dalam penggunaan token; Opus 4.8 memenangkan dua evaluasi tingkat repo yang lebih sulit. "Lebih baik" tergantung pada apakah kendala Anda adalah anggaran atau kemampuan puncak.
Seberapa jauh Grok 4.5 lebih murah dari Opus 4.8? $2 vs $5 per juta token input dan $6 vs $25 per juta output. Per tugas pengkodean yang diselesaikan, jumlah token yang dilaporkan vendor menunjukkan kesenjangan efektif yang jauh lebih besar.
Apakah ada benchmark independen untuk Grok 4.5? Belum ada. Angka yang dipublikasikan mencampur hasil uji xAI, evaluasi Datacurve, dan kartu sistem vendor lain. Angka independen seharusnya akan tersedia dalam beberapa minggu setelah peluncuran.
Bisakah saya menguji kedua model dengan kode yang sama? Sebagian besar, ya. Keduanya mengekspos penyelesaian obrolan yang kompatibel dengan OpenAI, jadi menukar base_url, kunci, dan ID model mencakup dasar-dasarnya. Detail pemanggilan alat dan output terstruktur berbeda; uji jalur tersebut secara eksplisit sebelum beralih.