
GLM-5.2 est l'un des modèles à poids ouverts les plus performants que vous puissiez exécuter actuellement, et la licence MIT ouverte signifie que la "gratuité" est réellement à portée de main. Le hic, c'est que "gratuit" et "facile" ne sont pas la même chose pour un modèle de mélange d'experts (MoE) d'environ 753 milliards de paramètres. Ce guide vous présente les véritables chemins, de l'auto-hébergement véritablement gratuit aux crédits d'essai quasi gratuits et au prix plancher payant le moins cher, avec des notes honnêtes sur le matériel et les limites.
Si vous voulez la version courte : si vous avez le matériel (ou un GPU loué à bas prix), auto-hébergez les poids ouverts. Si ce n'est pas le cas, appuyez-vous sur les crédits d'essai de z.ai ou sur le niveau le moins cher du Plan de Codage GLM. Il n'y a pas de voie OpenRouter gratuite pour glm-5.2, ne cherchez donc pas.
L'arbre de décision rapide
Choisissez votre ligne et passez à cette section.
| Votre situation | Meilleure voie | Coût réel |
|---|---|---|
| Vous possédez un puissant boîtier GPU (ou pouvez en louer un) | Auto-héberger les poids ouverts (Ollama / vLLM) | 0 $ pour les poids ; électricité ou location de GPU |
| Vous voulez zéro configuration et zéro carte | Crédits d'essai gratuits z.ai / niveau à débit limité | Gratuit jusqu'à épuisement des crédits (vérifier l'offre actuelle) |
| Vous voulez la voie payante fiable la moins chère | Plan de Codage GLM Lite, ou tarification API à entrée en cache | ~3-6 $/mois (vérifier) ou quelques centimes par appel |
| Vous voulez un paiement à l'usage sans engagement | API OpenRouter | 1,40 $ / 1M d'entrée, 4,40 $ / 1M de sortie |
La règle générale : vraiment gratuit signifie auto-héberger. Quasi gratuit signifie crédits d'essai ou le plan Lite.
Voie 1 : auto-héberger les poids MIT ouverts (véritablement gratuit)
GLM-5.2 est livré sous licence MIT sans restrictions régionales, vous pouvez donc télécharger les poids et les exécuter sur votre propre matériel sans payer personne. Les poids se trouvent sur Hugging Face à l'adresse zai-org/GLM-5.2.
La partie honnête : il s'agit d'un modèle MoE d'environ 753 milliards de paramètres en BF16. Même si seule une fraction de ces paramètres s'active par token, l'ensemble complet des poids doit toujours résider en mémoire. En BF16, cela représente bien plus d'un téraoctet de poids bruts. Vous ne l'exécuterez pas sur un ordinateur portable. La plupart des personnes qui auto-hébergent font l'une des deux choses suivantes :
- Exécuter une version quantifiée (4 bits ou similaire) pour réduire l'empreinte mémoire, acceptant un léger compromis sur la qualité.
- Louer une instance multi-GPU à l'heure auprès d'un fournisseur de cloud et l'arrêter une fois le travail terminé.
Donc "gratuit" signifie ici sans coût de licence. Vous payez toujours pour le matériel, l'électricité ou la location de GPU. Pour la plupart des individus, une version quantifiée sur une station de travail à haute VRAM ou une courte session louée est la voie réaliste.
Exécuter GLM-5.2 avec Ollama
Ollama est l'exécuteur local le plus convivial. GLM-5.2 est disponible dans la bibliothèque Ollama, le processus se fait en deux commandes :
# Pull the model (expect a very large download)
ollama pull glm-5.2:cloud
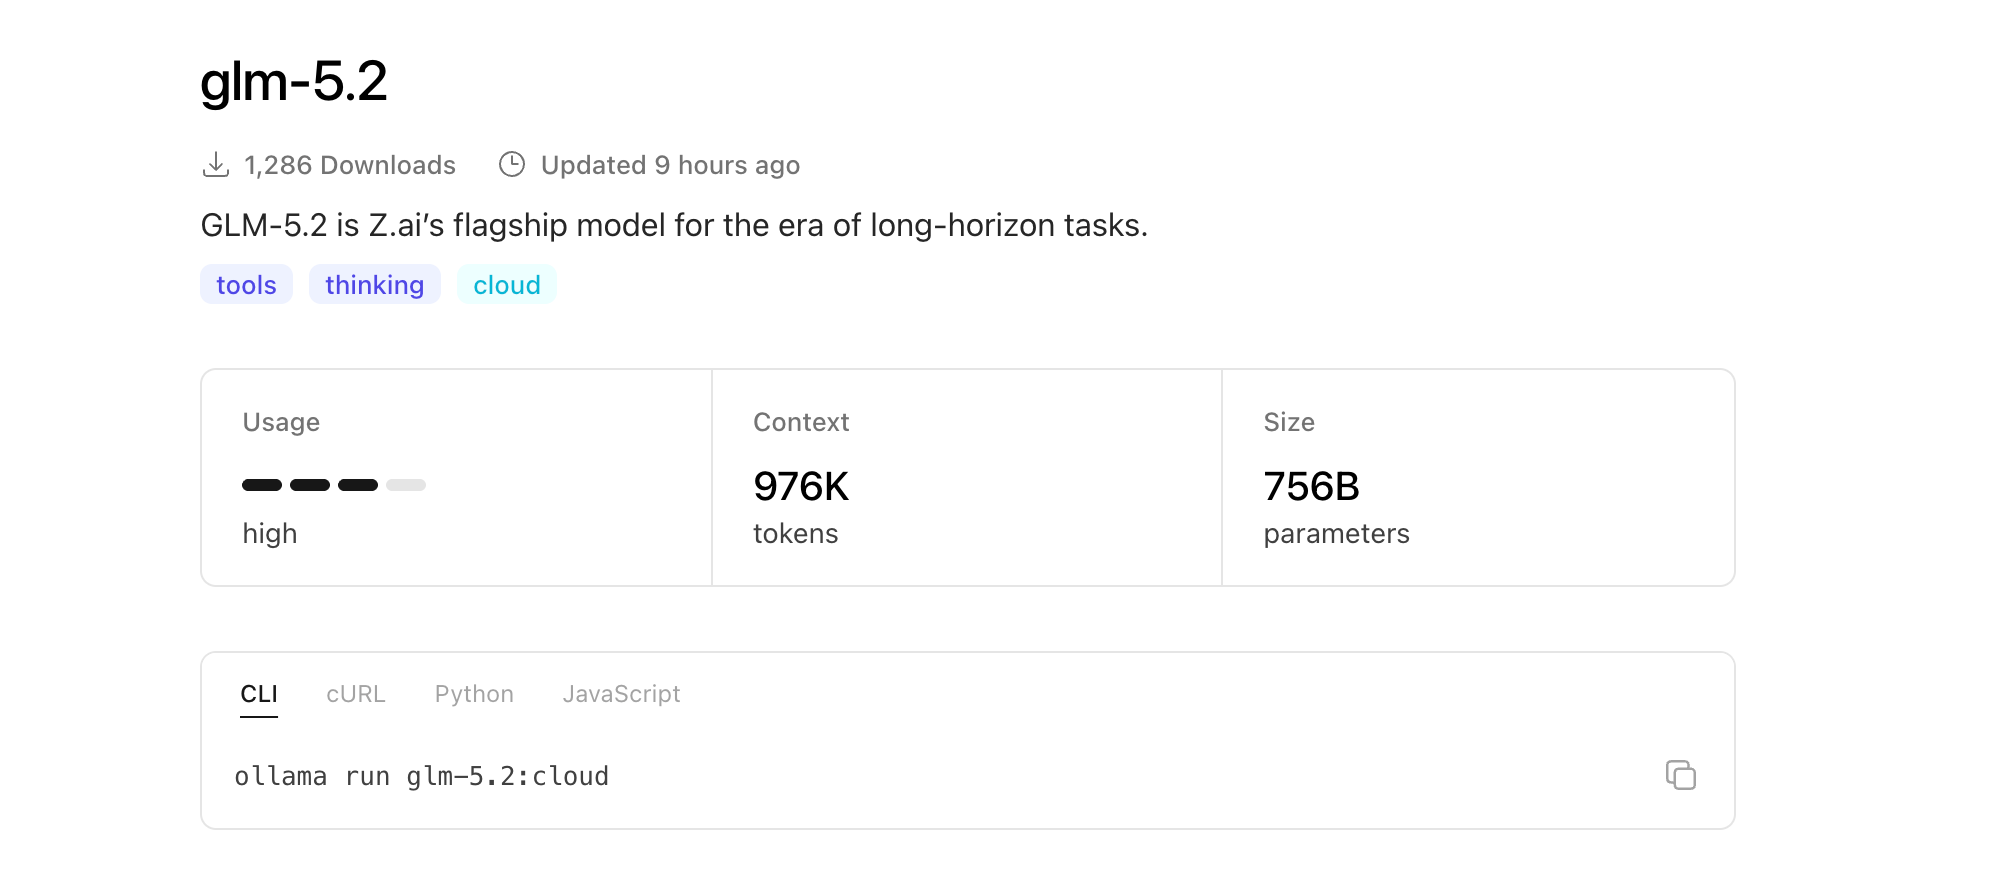
Ollama utilise par défaut une variante quantifiée, ce qui rend un modèle de cette taille même envisageable sur du matériel grand public. Vous pouvez également l'atteindre via le point de terminaison local compatible OpenAI d'Ollama :
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.2",
    "messages": [{"role": "user", "content": "Write a Python function to parse an RFC 3339 timestamp."}]
  }'
Surveillez votre RAM et votre VRAM. Si le modèle se déverse sur le disque, la génération ralentit considérablement. Une version quantifiée et suffisamment de mémoire unifiée ou une division multi-GPU fait la différence entre utilisable et inutilisable.
Si vous souhaitez le guide local étape par étape, les modèles se reportent presque exactement de la génération précédente. Voir exécuter GLM-5 localement gratuitement et GLM-5 gratuitement avec Ollama pour la configuration complète, les choix de quantification et le dépannage. Remplacez la balise de modèle par glm-5.2 et le flux de travail est le même.
Exécuter GLM-5.2 avec vLLM
Pour le débit et le service de plusieurs requêtes, vLLM est l'option de qualité production. Il gère le parallélisme tensoriel sur les GPU, ce qui est la façon dont vous intégrez réellement un MoE de 753B.
pip install vllm

python -m vllm.entrypoints.openai.api_server \
  --model zai-org/GLM-5.2 \
  --tensor-parallel-size 8 \
  --max-model-len 131072
Ce --tensor-parallel-size 8 suppose huit GPU. Le nombre exact dépend de vos cartes et si vous chargez un checkpoint quantifié. vLLM expose un serveur compatible OpenAI, donc tout client qui utilise le format de complétion de chat fonctionne sans modifications. Le contexte de 1M de tokens (1 048 576 tokens) est la capacité phare, mais maintenir un cache KV d'un million de tokens coûte beaucoup de mémoire, alors définissez --max-model-len à ce dont vous avez réellement besoin.
Voie 2 : crédits d'essai gratuits z.ai et le niveau à débit limité
Si l'auto-hébergement est hors de portée, le chemin le moins cher est la propre plateforme de z.ai. Les nouveaux comptes reçoivent généralement des crédits d'essai gratuits et il existe généralement un niveau gratuit à débit limité pour des expérimentations légères (à partir de juin 2026, vérifiez l'offre actuelle sur z.ai car les conditions d'essai changent souvent).
C'est le moyen le plus rapide d'essayer le vrai modèle sans aucune configuration. Vous créez un compte, obtenez une clé API et appelez le point de terminaison compatible OpenAI :
curl https://api.z.ai/api/paas/v4/chat/completions \
  -H "Authorization: Bearer $ZAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.2",
    "messages": [{"role": "user", "content": "Explain IndexShare sparse attention in two sentences."}],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "max"
  }'
Quelques spécificités de GLM-5.2 à connaître pendant que vous utilisez ces crédits :
thinkingactive ou désactive le raisonnement. Pour le codage, z.ai recommande le niveau d'effort de raisonnement Max viareasoning_effort: "max". Il existe deux niveaux d'effort, High et Max.- La longueur de sortie est documentée jusqu'à 128K selon la documentation de z.ai, mais traitez cela comme un nombre à vérifier en direct plutôt qu'une garantie ferme, car les sources secondaires ne le listent pas toujours.
Les crédits d'essai s'épuisent. Lorsque cela se produit, vous passez à un plan payant ou vous revenez à l'auto-hébergement. Les détails complets des paramètres se trouvent dans le guide GLM-5.2 de z.ai.
Voie 3 : les plans payants les moins chers (quasi gratuits)
Lorsque les crédits gratuits sont épuisés, deux voies permettent de maintenir vos coûts proches de zéro.
Plan de codage GLM Lite
Si votre utilisation principale est le codage, le plan de codage GLM est l'option économique. Le niveau d'entrée Lite coûte environ 12 $/mois (à partir de juin 2026, vérifiez les prix actuels sur z.ai car les niveaux publiés sont en conflit entre les sources). Pour cela, vous obtenez un accès au codage à un tarif mensuel fixe au lieu de tokens mesurés, ce qui rend l'utilisation quotidienne intensive prévisible.
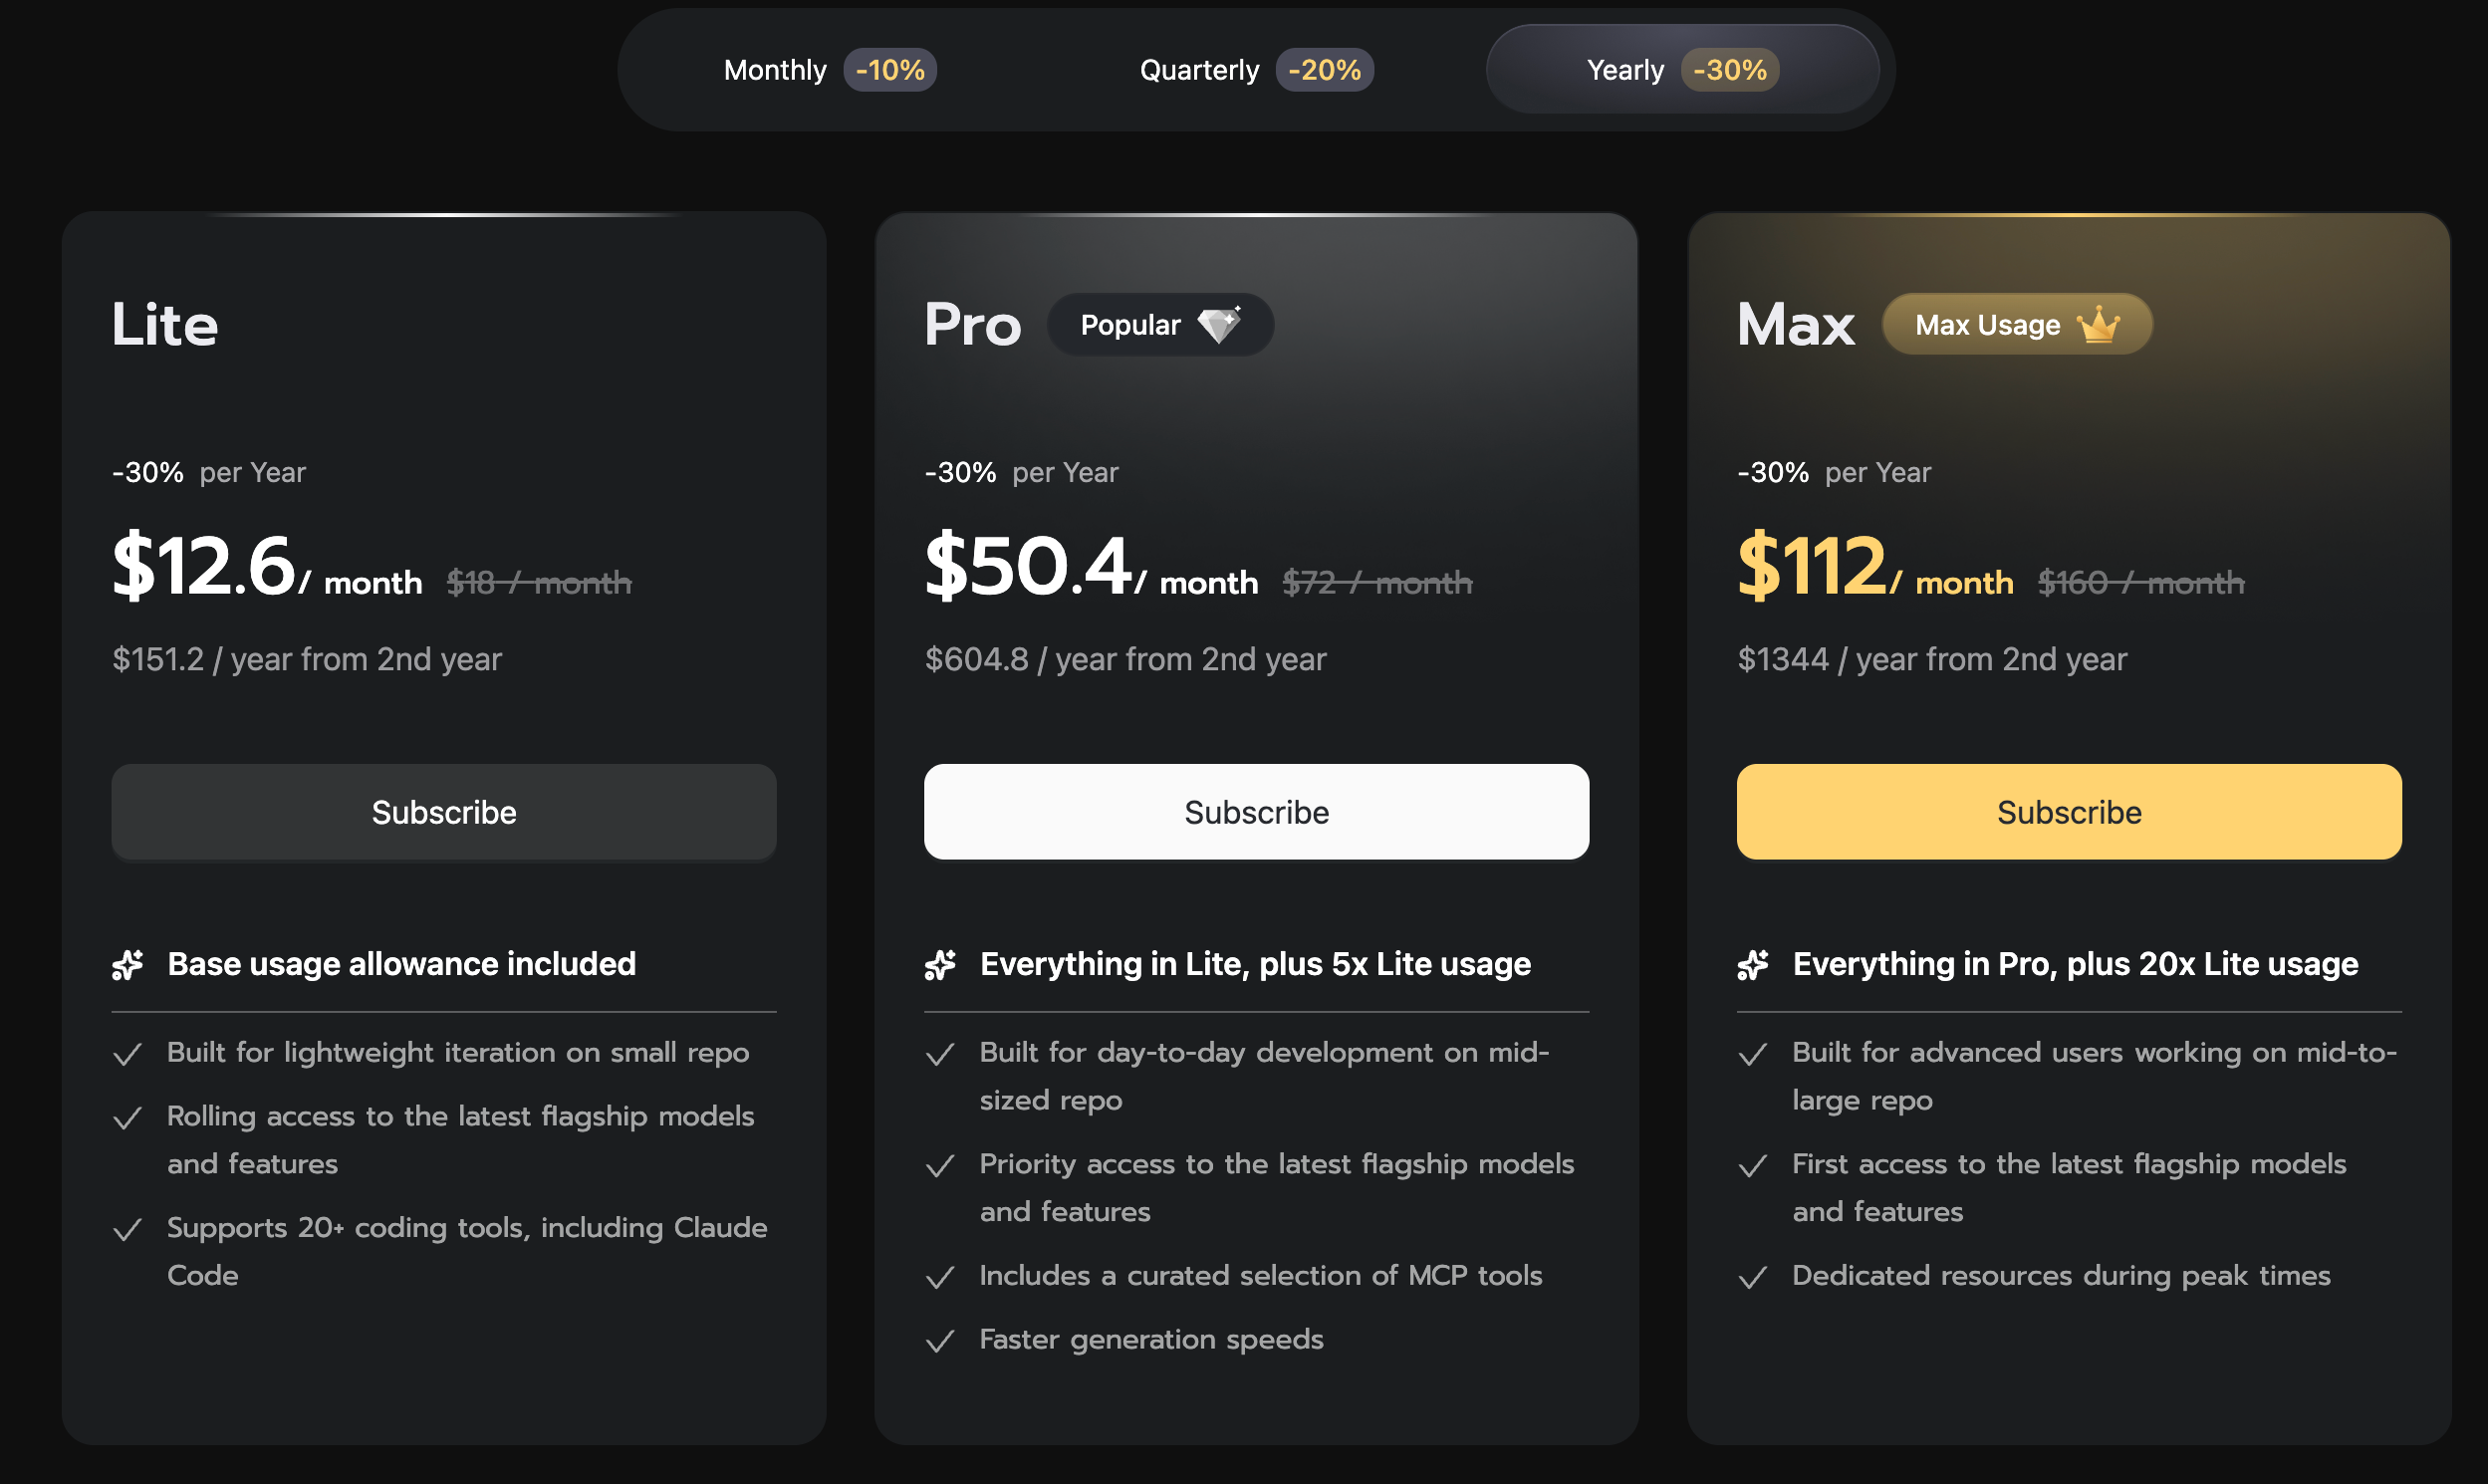
Le plan de codage débloque également le chemin compatible Anthropic, vous permettant ainsi de pointer Claude Code, Cline ou Cursor vers GLM-5.2. L'URL de base de codage est https://api.z.ai/api/coding/paas/v4 (certaines sources indiquent open.z.ai/api/paas/v4, vérifiez en direct). Un environnement Claude Code fonctionnel ressemble à ceci :
export ANTHROPIC_BASE_URL="https://api.z.ai/api/coding/paas/v4"
export ANTHROPIC_API_KEY="your-glm-coding-plan-key"
export ANTHROPIC_DEFAULT_SONNET_MODEL="glm-5.2[1m]"
export ANTHROPIC_DEFAULT_OPUS_MODEL="glm-5.2[1m]"
export CLAUDE_CODE_AUTO_COMPACT_WINDOW=1000000
export API_TIMEOUT_MS=3000000
Le suffixe [1m] sélectionne la variante de contexte 1M. Réglez API_TIMEOUT_MS haut, sinon Claude Code mettra fin aux longs appels à contexte large avant qu'ils ne soient terminés. Pour la présentation plus approfondie des outils d'agent, consultez GLM-5.2 avec Claude Code, Cline et Cursor et le guide de génération précédente GLM-5.1 avec Claude Code.
Tarification de l'entrée en cache et paiement à l'utilisation
Pour l'accès API sans abonnement, l'API générale standard coûte 1,40 $ par million de tokens d'entrée et 4,40 $ par million de tokens de sortie, confirmé par OpenRouter. La même tarification s'applique que vous appeliez z.ai directement ou que vous passiez par OpenRouter en mode paiement à l'usage.
L'astuce quasi gratuite ici est l'entrée en cache. Estimé à environ 0,26 $ par million de tokens (selon VentureBeat, attribuer en conséquence), l'entrée en cache réduit considérablement le coût du contexte répété, comme une longue invite système ou une base de code fixe que vous interrogez encore et encore. Si votre charge de travail réutilise le même préfixe, vous payez le prix fort une fois et une fraction par la suite. Pour le codage à long terme, VentureBeat note que GLM-5.2 "surpasse GPT-5.5 sur le codage à long terme à environ un sixième du coût", ce qui est l'argument économique en une phrase.
Encore une fois, clairement : il n'y a pas de niveau OpenRouter gratuit pour glm-5.2. OpenRouter est bon marché, pas gratuit. Si un guide prétend le contraire, il se trompe.
Gratuit vs quasi gratuit : la comparaison honnête
| Voie | Coût initial | Coût continu | Effort de configuration | Idéal pour |
|---|---|---|---|---|
| Auto-hébergement (Ollama/vLLM) | Matériel ou location | Électricité / heures GPU | Élevé | Confidentialité, pas de facturation au compteur, contrôle total |
| Crédits d'essai z.ai | Aucun | Gratuit jusqu'à la fin des crédits | Faible | Première approche, tests rapides |
| Plan de codage GLM Lite | ~3-6 $/mois (vérifier) | Forfait mensuel | Faible | Codage quotidien dans Claude Code/Cline/Cursor |
| API + entrée en cache | Aucun | 1,40 $/4,40 $ par 1M ; ~0,26 $ en cache | Faible | Applications, charges de travail à contexte répété |
Une règle utile : validez votre idée avec des crédits d'essai, puis décidez. Si vous l'utilisez quotidiennement et qu'il s'agit de codage, prenez le plan Lite. Si vous avez besoin de confidentialité ou souhaitez échapper entièrement à la facturation par token, investissez dans l'auto-hébergement. Si vous construisez un produit avec un contexte réutilisable, l'API avec mise en cache est le plancher fiable le moins cher.
Testez votre point de terminaison GLM-5.2 gratuit avec Apidog
Quelle que soit la manière dont vous faites fonctionner GLM-5.2, gratuite ou payante, vous voudrez confirmer que le point de terminaison fonctionne réellement avant de l'intégrer à votre application. Qu'il s'agisse d'un serveur Ollama local, d'une instance vLLM ou de l'API cloud de z.ai, la réponse est une charge utile de complétions de chat en streaming que vous devez inspecter.
Apidog est une plateforme API tout-en-un exactement pour cela. Vous pouvez envoyer une requête à votre point de terminaison GLM-5.2, regarder les événements envoyés par le serveur en temps réel, enregistrer la requête comme un cas réutilisable et simuler la réponse afin que votre frontend puisse s'appuyer dessus avant même que le modèle ne soit en ligne. Dirigez-le vers http://localhost:11434 pour Ollama ou vers l'URL de base de z.ai pour le cloud, définissez votre en-tête Authorization, et vous avez un harnais de test répétable en une minute. Téléchargez Apidog et gardez-le à côté de la voie gratuite que vous choisissez.
FAQ
GLM-5.2 est-il réellement gratuit à utiliser ? Les poids sont gratuits sous licence MIT, donc l'auto-hébergement ne coûte rien en termes de licence. Vous payez toujours pour le matériel ou la location de GPU. L'API hébergée est payante, bien que z.ai propose généralement des crédits d'essai et un niveau à débit limité pour commencer (vérifiez l'offre actuelle).
Puis-je exécuter GLM-5.2 gratuitement avec Ollama sur un ordinateur portable normal ? Réaliste, non. C'est un modèle MoE d'environ 753 milliards de paramètres, et même une version quantifiée nécessite une mémoire sérieuse. Ollama facilite les commandes, mais la barre matérielle est élevée. Une station de travail à haute VRAM, un Mac avec une grande mémoire unifiée ou un GPU loué est ce dont vous avez besoin. Voir la revue locale détaillée pour le dimensionnement.
Existe-t-il un niveau OpenRouter gratuit pour GLM-5.2 ? Non. OpenRouter propose GLM-5.2 en paiement à l'usage à 1,40 $ d'entrée et 4,40 $ de sortie par million de tokens. C'est bon marché, pas gratuit. Ne faites confiance à aucune source prétendant une voie OpenRouter gratuite.
Quel est le moyen payant le moins cher d'utiliser GLM-5.2 pour le codage ? Le niveau Lite du plan de codage GLM, environ 3-6 $/mois à partir de juin 2026 (vérifiez sur z.ai). Il donne un accès au codage à un tarif forfaitaire et débloque le point de terminaison compatible Anthropic pour Claude Code, Cline et Cursor.
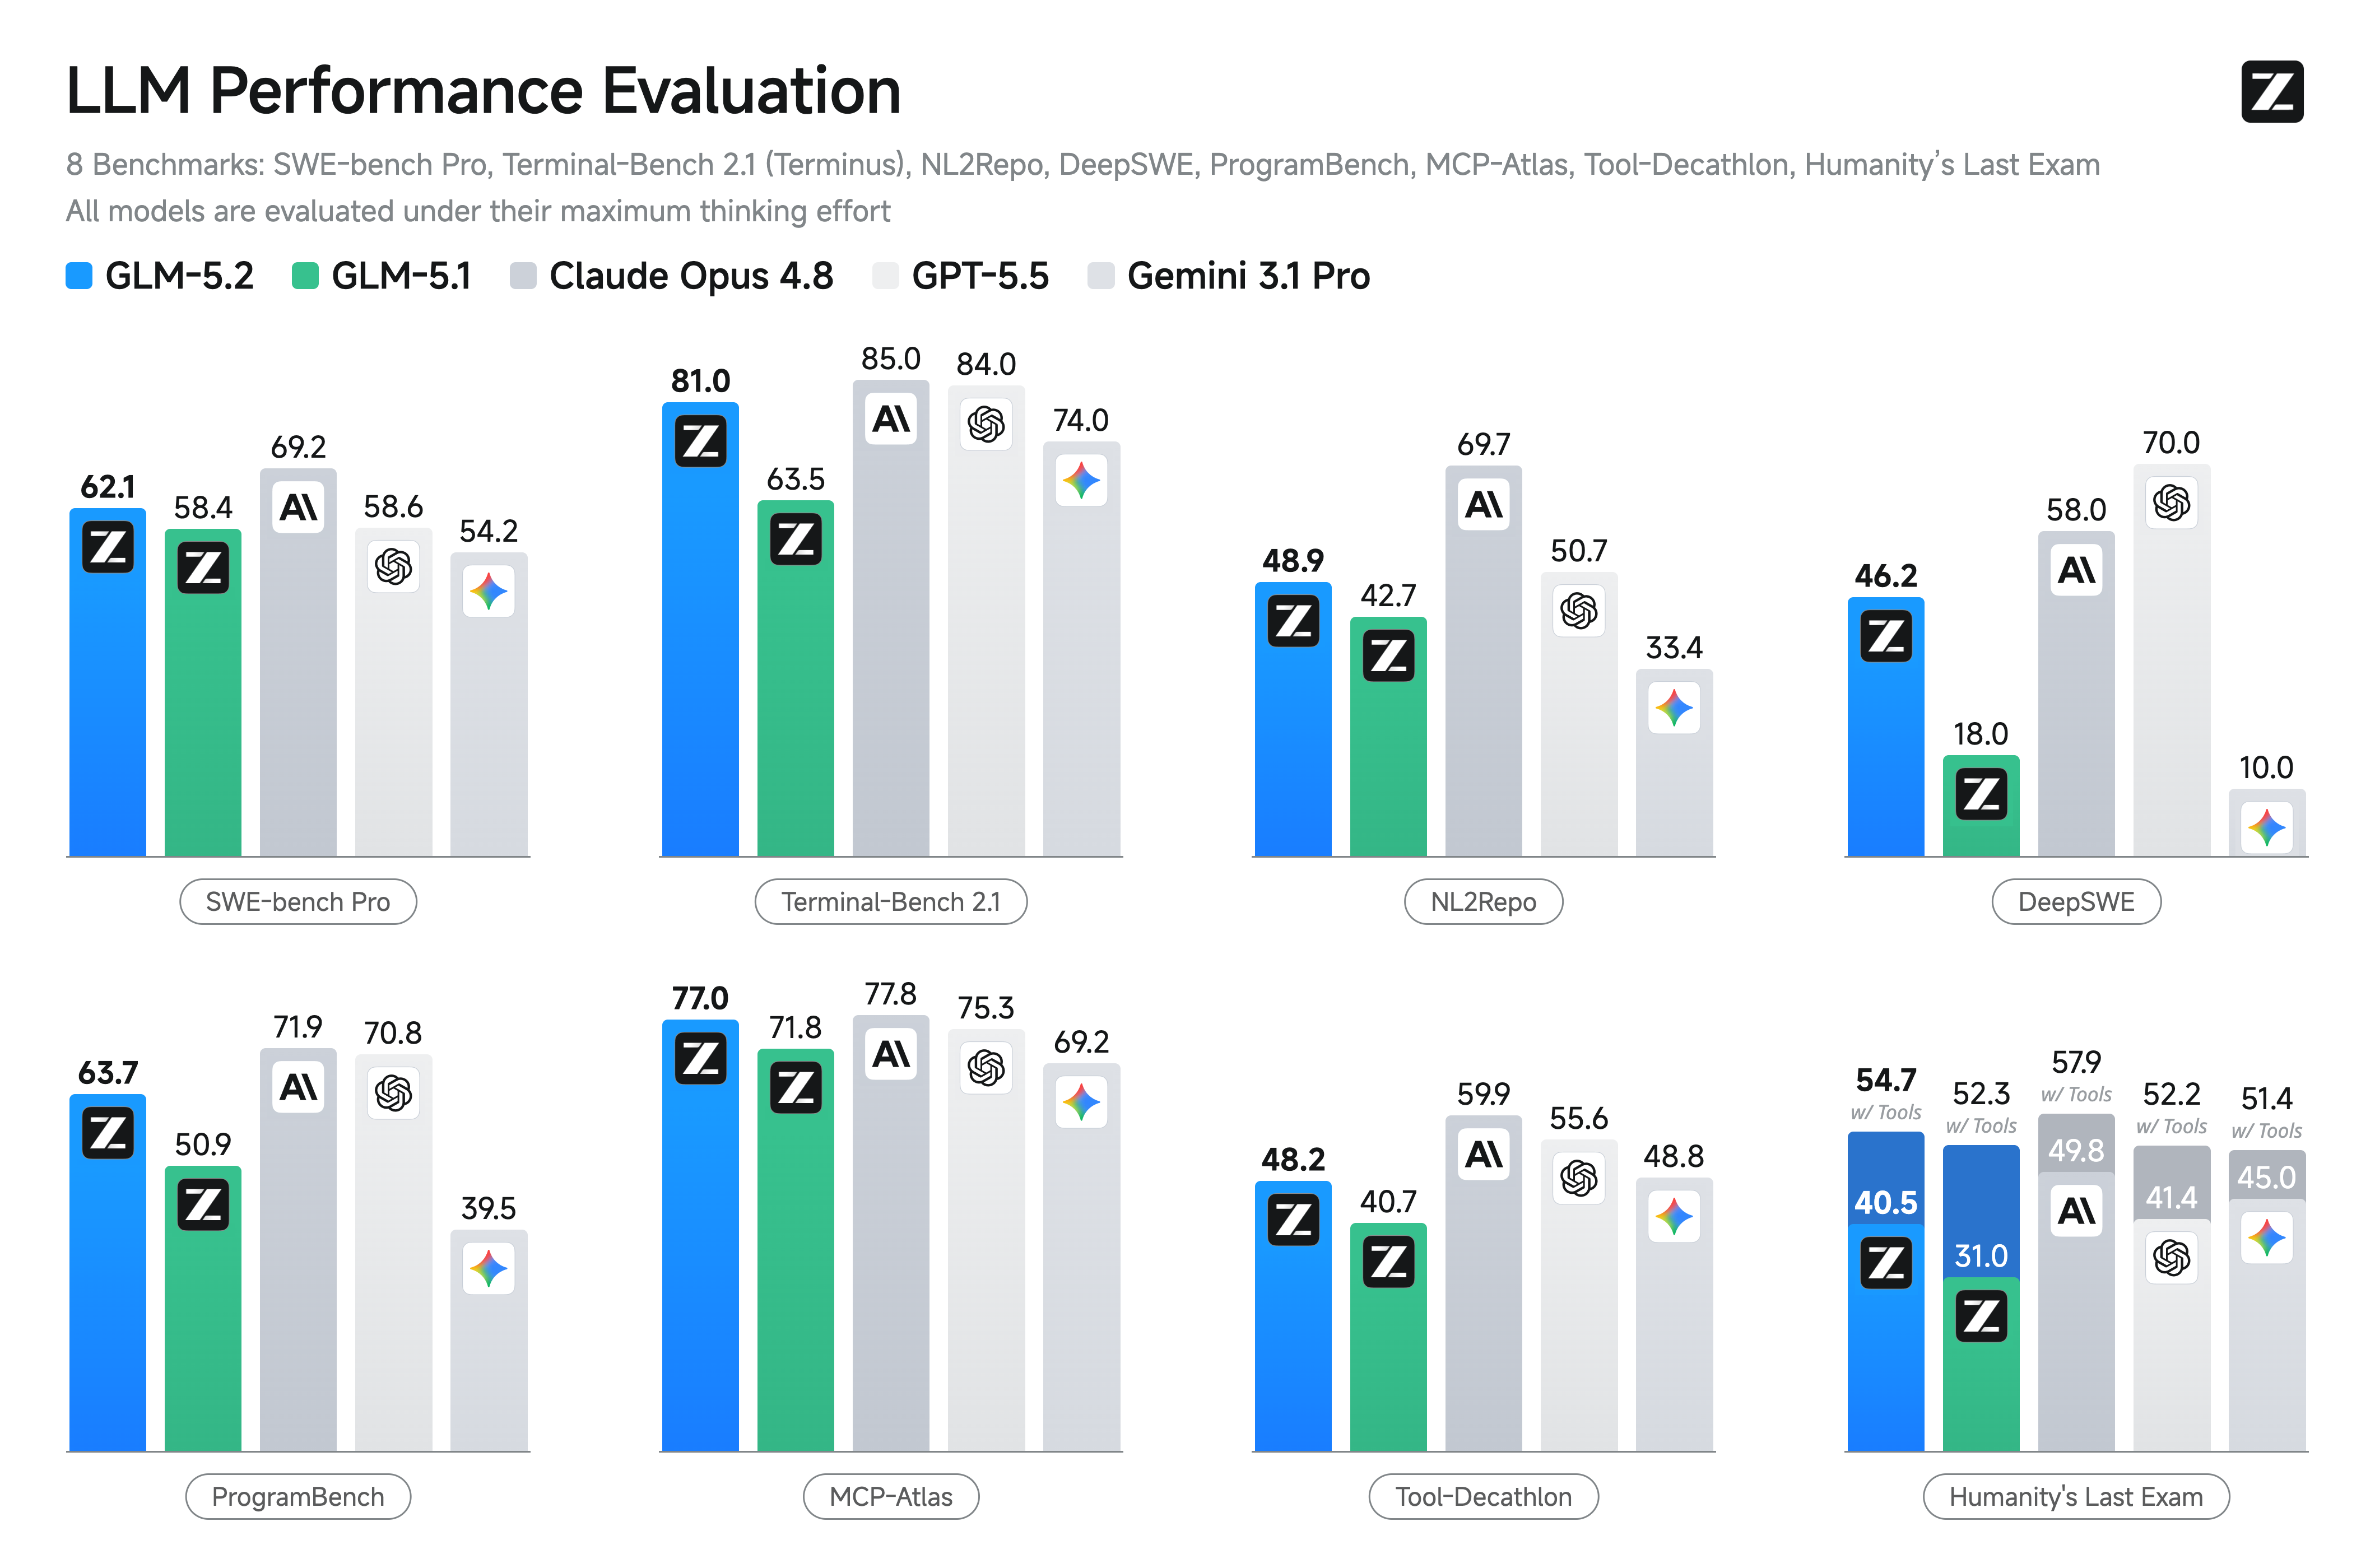
Comment GLM-5.2 se compare-t-il à GPT-5.5 en termes de coût ? Selon VentureBeat, GLM-5.2 surpasse GPT-5.5 sur plusieurs benchmarks de codage à long terme à environ un sixième du coût. Pour les chiffres complets, consultez la répartition des benchmarks GLM-5.2 et la comparaison directe.
Où aller ensuite
La voie la moins chère dépend entièrement de votre matériel et de la fréquence d'utilisation. L'auto-hébergement l'emporte en matière de confidentialité et d'absence de facturation au compteur si vous pouvez franchir la barre de la mémoire. Les crédits d'essai et le plan Lite l'emportent en termes de commodité. L'API avec entrée en cache l'emporte pour les applications qui réutilisent le contexte.
Si vous hésitez encore à savoir si GLM-5.2 est le bon modèle, commencez par ce qu'est GLM-5.2 et comment il se compare à GLM-5.1. Lorsque vous serez prêt à développer avec lui, le guide de l'API GLM-5.2 et la ventilation des prix couvrent le reste, et Apidog gère les tests entre les deux.