
Para probar la API de Sakana Fugu en Apidog, crea una nueva solicitud HTTP apuntando a la ruta compatible con OpenAI de Fugu /chat/completions, añade un encabezado Authorization: Bearer con tu clave, y envía una carga útil que nombre al modelo fugu o fugu-ultra. Dado que Fugu ofrece un endpoint compatible con OpenAI, cualquier herramienta que hable el formato de chat de OpenAI funciona sin necesidad de cambiar el SDK, y Apidog te proporciona inspección de streaming, variantes de solicitud guardadas y comparación de respuestas en una sola ventana. Esta guía recorre el ciclo completo: construir la solicitud, observar los deltas SSE, leer el objeto usage y comparar la latencia entre el nivel equilibrado y el nivel Ultra más lento para que puedas ver el costo del salto de orquestación en respuestas reales.
Si prefieres la ruta de integración "código primero" en lugar de la ruta de "probar y observar", la guía complementaria sobre cómo usar la API de Sakana Fugu cubre el cableado del SDK. Este artículo se mantiene dentro de Apidog.
Lo que realmente estás probando con Fugu
Fugu no es un modelo de chat simple. Según Sakana, es un sistema de orquestación multi-agente presentado como un único modelo fundacional detrás de una API. Un modelo de lenguaje entrenado se especializa en delegación, comunicación entre agentes y síntesis de trabajo, y luego coordina dinámicamente múltiples LLM, incluyendo instancias recursivas de sí mismo. El titular de lanzamiento es "Un modelo para gobernarlos a todos". Para conocer la historia de la orquestación, consulta el explicación sobre qué es Sakana Fugu.
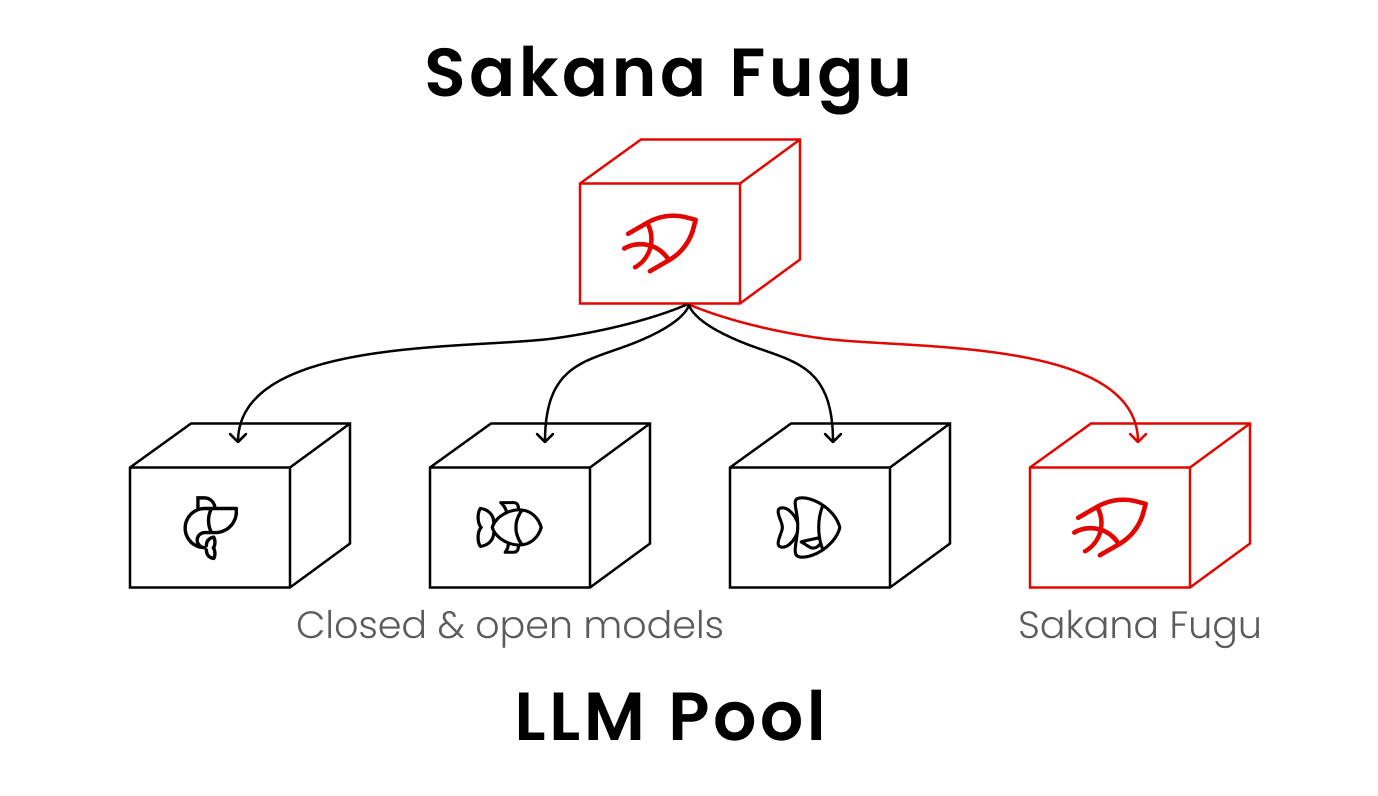
Ese diseño es importante para las pruebas. Cuando envías una solicitud, Fugu decide si responder directamente o si ensambla un equipo tras bambalinas. Ves una respuesta, pero el trabajo subyacente puede haber cruzado varios modelos. Así que las cosas que vale la pena medir en Apidog son diferentes a las de una prueba de modelo normal: observas la latencia como un indicador de si Fugu realizó una sola pasada o un salto de orquestación, y lees el objeto usage para ver el costo de los tokens en la llamada principal.
Dos variantes comparten ese único endpoint:
- Fugu (la variante equilibrada y de baja latencia) está diseñada para el trabajo diario: codificación, revisión de código, chatbots y servicios interactivos.
- Fugu Ultra está diseñada para la máxima calidad de respuesta: investigación de IA, reproducción de artículos, análisis de ciberseguridad e investigación de literatura o patentes.
La beta y gran parte de la prensa temprana llamaron a la variante pequeña "Fugu Mini". La página de lanzamiento presenta "Fugu" y "Fugu Ultra", así que usa esos nombres; "Mini" es la antigua etiqueta beta.
Obtén la URL base y la clave antes de empezar
Fugu se encuentra detrás de un muro de inicio de sesión. Inicias sesión en console.sakana.ai con Google o correo electrónico, y la consola es donde copias tu clave de API y la URL base.
Una nota importante para el 22/06/2026: la URL base no está publicada en ninguna página pública de Sakana. No la adivines. Copia el host real de la consola y guárdalo como una variable. En todas partes de esta guía donde veas <YOUR_FUGU_BASE_URL_FROM_CONSOLE>, reemplázalo con el valor que te muestra la consola. El acceso también pasó de una beta de aproximadamente 500 usuarios a la disponibilidad general; si el registro de auto-servicio está completamente abierto y si existe una restricción de la UE/EEE, vale la pena verificarlo en vivo en la consola.
Configura la solicitud Fugu en Apidog
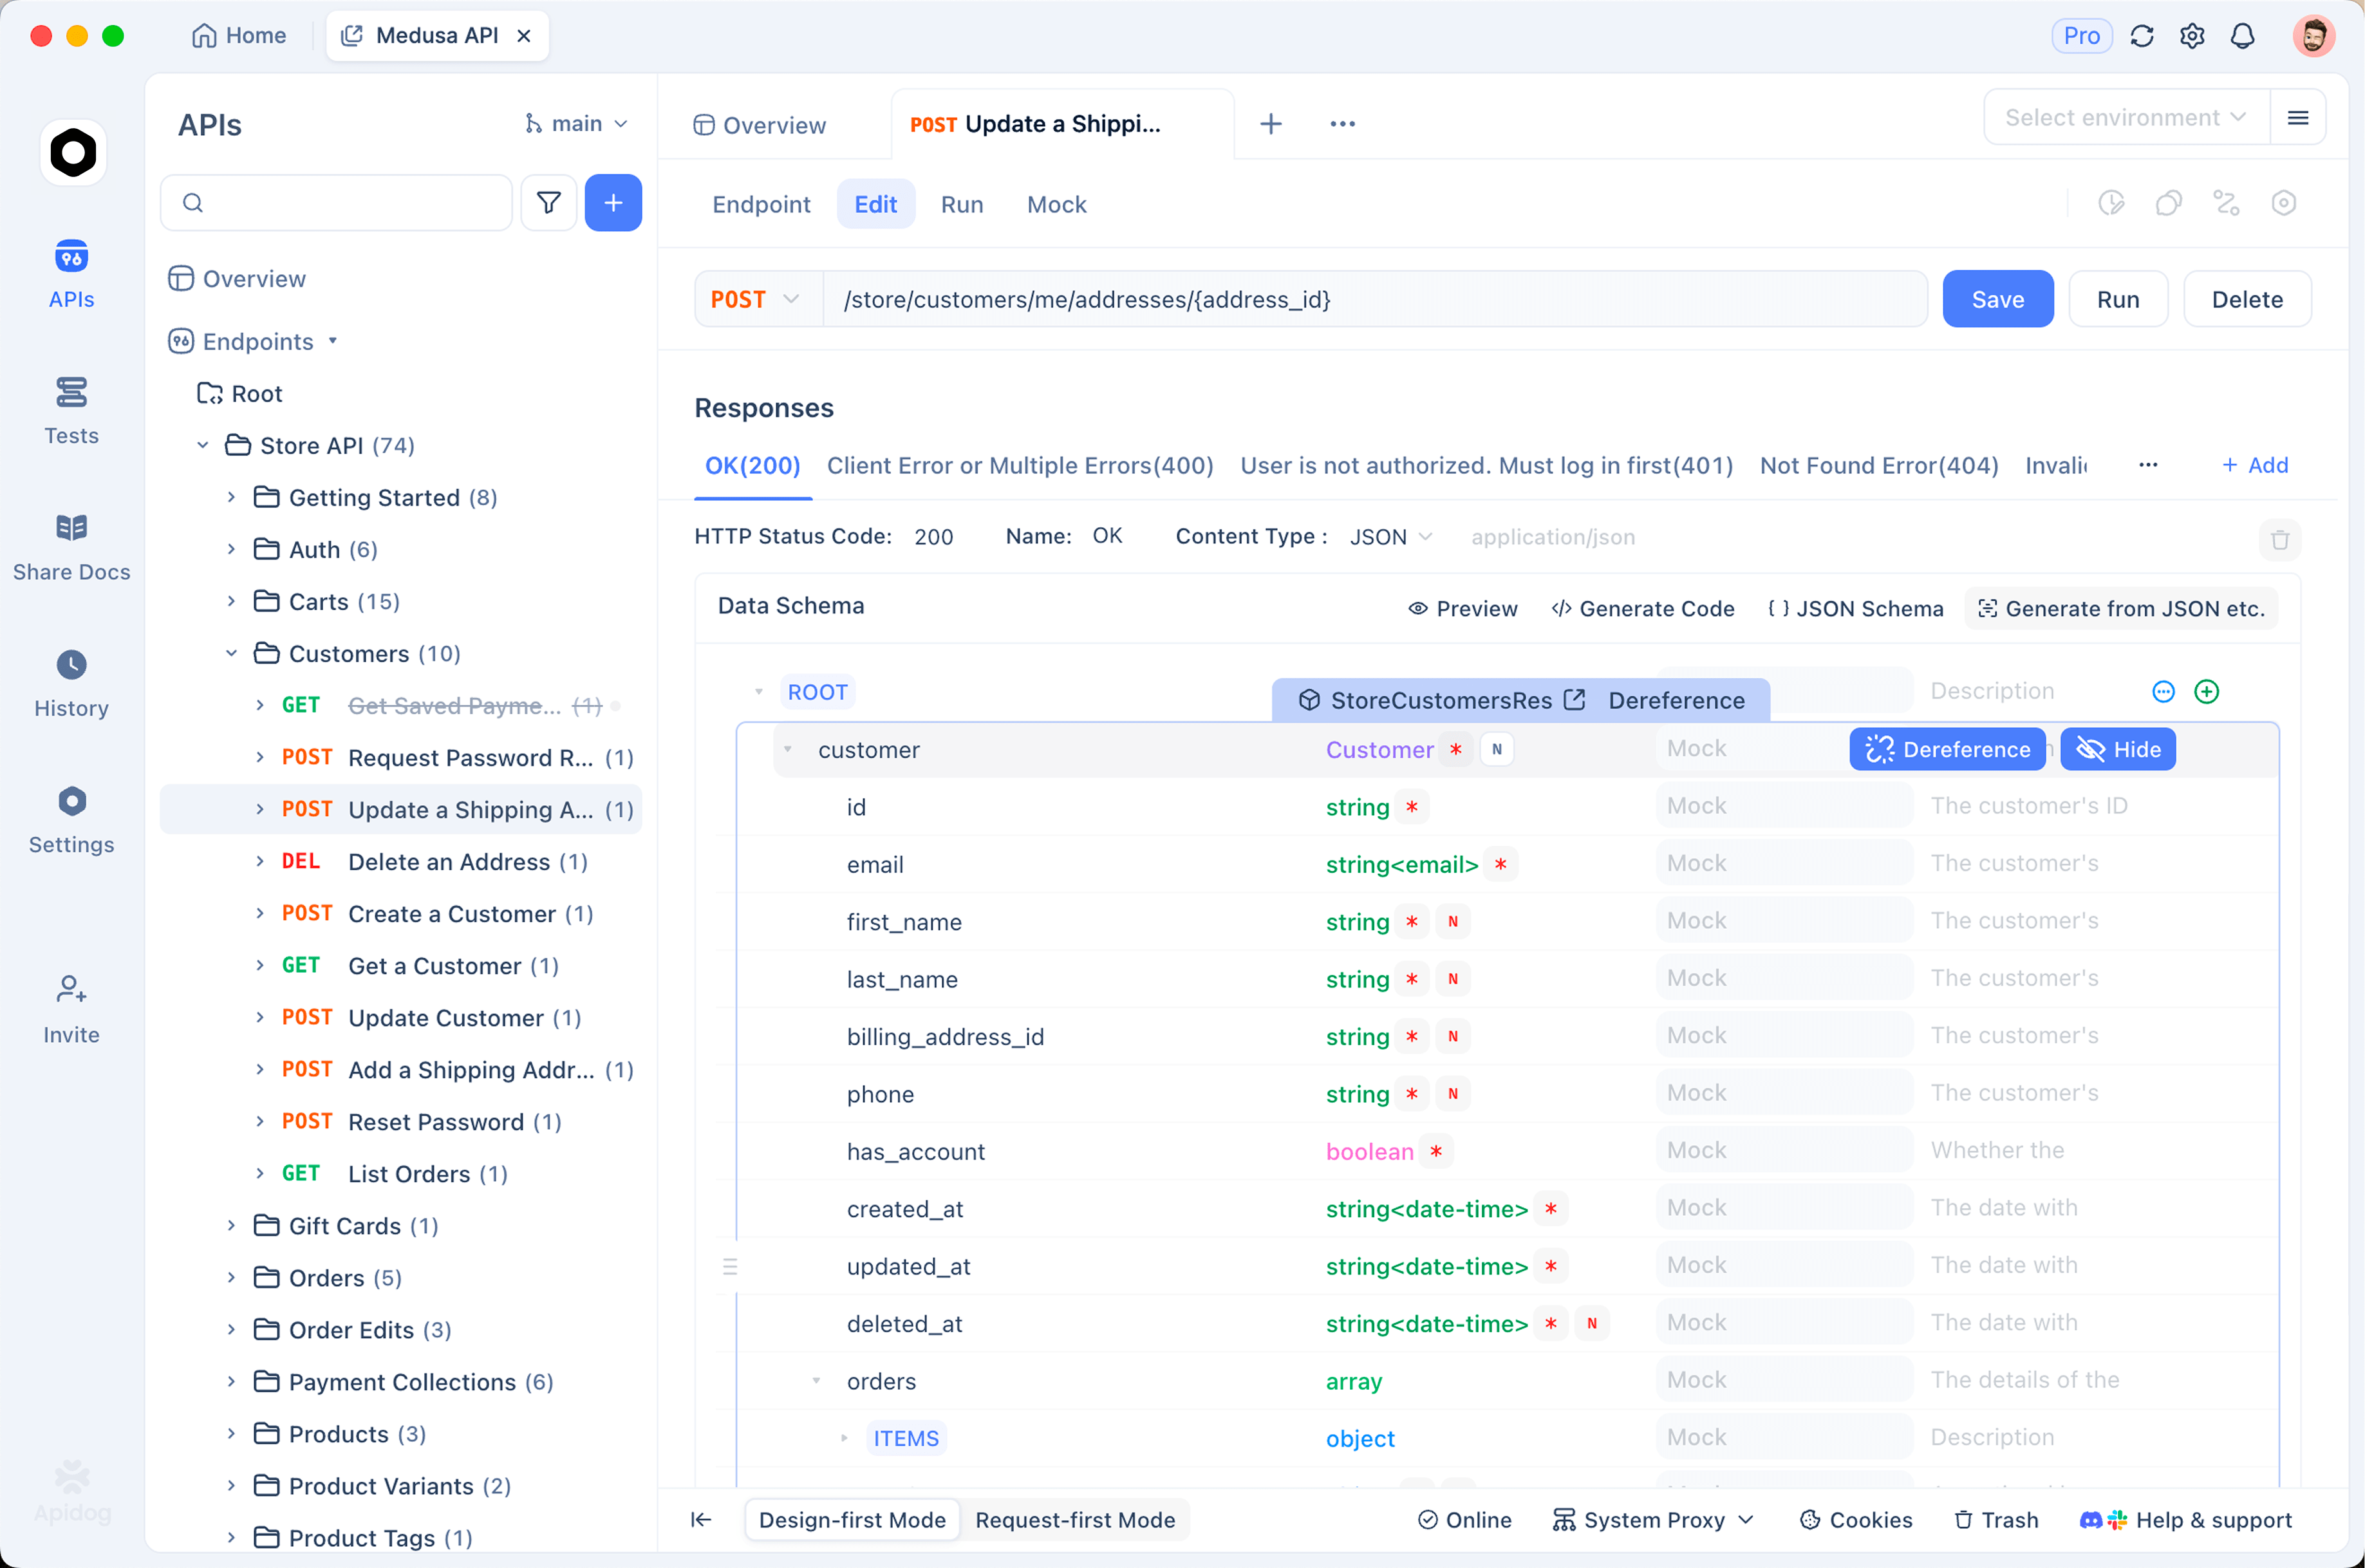
Descarga Apidog si no lo tienes, luego crea un nuevo proyecto y una nueva solicitud HTTP.
Usa variables de entorno para la clave y el host
No pegues secretos en la barra de URL. Los entornos de Apidog te permiten almacenar la URL base y la clave una vez y referenciarlas en cada solicitud. Crea un entorno (llámalo Fugu Prod) y añade dos variables:
fugu_base_urlconfigurado con tu valor<YOUR_FUGU_BASE_URL_FROM_CONSOLE>.fugu_keyconfigurado con tu clave API de la consola.
Ahora tu URL de solicitud se convierte en {{fugu_base_url}}/chat/completions y el valor de tu encabezado se convierte en Bearer {{fugu_key}}. Cambiar entre una clave de entorno de prueba y una clave de producción es un cambio de un solo desplegable, no un buscar y reemplazar en todas las solicitudes. Si has conectado otros proveedores compatibles con OpenAI a través de una pasarela antes, esto refleja el patrón del tutorial de Claude Code con OpenRouter, donde una URL base y un token de portador redirigen un cliente de OpenAI a un nuevo backend.
Construye el cuerpo de la solicitud
Establece el método en POST, la URL en {{fugu_base_url}}/chat/completions, y añade estos encabezados:
Authorization: Bearer {{fugu_key}}
Content-Type: application/json
Luego, inserta una carga útil estándar de chat de OpenAI en el cuerpo JSON:
{
  "model": "fugu",
  "messages": [
    { "role": "system", "content": "Eres un asistente conciso para pruebas de API." },
    { "role": "user", "content": "Resume qué es un delta SSE en dos oraciones." }
  ],
  "stream": false
}
La estructura coincide exactamente con la referencia de finalizaciones de chat de OpenAI, que es el objetivo de un endpoint compatible con OpenAI. Los strings de identificación del modelo reportados en el lanzamiento son fugu y fugu-ultra (y posiblemente una forma anticuada como fugu-ultra-20260615). Confirma la identificación exacta en la consola en lugar de codificar un string anticuado, ya que los IDs anticuados rotan.
Envíala. Deberías recibir un objeto de finalización de chat normal, con un array choices y un bloque usage. Guarda esta solicitud en Apidog como "Fugu equilibrado".
Envía a la variante Ultra y guarda ambas
Duplica la solicitud guardada, cambia un campo, y ya tienes tu segundo caso de prueba:
{
  "model": "fugu-ultra",
  "messages": [
    { "role": "user", "content": "Reproduce el resultado central del artículo del coordinador Trinity en lenguaje sencillo y señala una limitación." }
  ],
  "stream": false
}
Guarda esto como "Fugu Ultra". Ahora tienes dos solicitudes guardadas que acceden al mismo endpoint, separadas solo por el campo model. Esta es la configuración que hace que el resto de la prueba sea significativa. Envías el mismo prompt a ambas, luego comparas las respuestas y los tiempos. Apidog mantiene un historial de respuestas por solicitud, así que puedes ejecutar cada una varias veces y observar cómo varían las respuestas y la latencia. Para un patrón más amplio sobre la encadenación y comparación de llamadas a la API, la guía de orquestación de pruebas de API cubre cómo secuenciar y afirmar a través de múltiples solicitudes.
Inspeccionar deltas de streaming SSE
El streaming es donde el comportamiento de Fugu se vuelve interesante, porque un salto de orquestación largo aún transmite tokens a medida que se finalizan. Cambia stream a true:
{
  "model": "fugu-ultra",
  "messages": [
    { "role": "user", "content": "Analiza una apertura de ajedrez de un solo tiro, paso a paso." }
  ],
  "stream": true
}
Con el streaming activado, la respuesta es text/event-stream y llega como una serie de fragmentos data:. Apidog renderiza el stream SSE en vivo, así que observas los deltas llegar en lugar de mirar un spinner. Cada fragmento se ve así:
data: {"id":"chatcmpl-xxx","object":"chat.completion.chunk","choices":[{"index":0,"delta":{"content":"El"},"finish_reason":null}]}

data: {"id":"chatcmpl-xxx","object":"chat.completion.chunk","choices":[{"index":0,"delta":{"content":" Siciliana"},"finish_reason":null}]}

data: [DONE]
El objeto delta contiene el contenido incremental del token. El primer fragmento generalmente lleva el role, luego los fragmentos subsiguientes llevan fragmentos de content, y el flujo termina con finish_reason establecido y una línea final data: [DONE]. Observa la brecha antes del primer delta en Ultra. Una larga pausa antes de que los tokens comiencen, y luego un flujo constante, es una señal útil de que Fugu ensambló un equipo antes de responder. La variante equilibrada tiende a comenzar a transmitir antes porque a menudo responde directamente.
Lee el objeto de uso y compara el costo
Una vez que una llamada no-streaming retorna, abre el bloque usage en la respuesta:
{
  "usage": {
    "prompt_tokens": 38,
    "completion_tokens": 412,
    "total_tokens": 450
  }
}
Los recuentos de tokens en la llamada principal son lo que Apidog te muestra directamente. Ten en cuenta un punto de honestidad: Fugu es un orquestador que llama a modelos de vanguardia de otros proveedores, incluyéndose a sí mismo recursivamente. El usage que lees es la contabilidad de tu solicitud a Fugu, no una ventana a cada modelo descendente al que pudo haber llamado. La estructura de precios, según Sakana, son niveles de suscripción para uso diario más un plan de pago por uso para cargas de trabajo más pesadas y empresariales.
Como ancla de comparación fundamentada, las tarifas publicadas de Anthropic (09/06/2026) sitúan a Fable 5 y Mythos 5 en $10 por 1M de entrada y $50 por 1M de salida. La guía de la API de Claude Fable 5 cubre ese endpoint si deseas una línea base de un solo modelo para probar junto con Fugu en el mismo proyecto de Apidog.
Mide el costo del salto de orquestación en latencia
Esta es la prueba que justifica ejecutar ambas variantes. Envía el mismo prompt a "Fugu equilibrado" y a "Fugu Ultra", luego lee el tiempo de respuesta que Apidog informa en la parte inferior de cada resultado.
Normalmente verás que la variante equilibrada responde más rápido. Según Sakana, el "Fugu" equilibrado busca baja latencia y servicios interactivos, mientras que Ultra busca la máxima calidad para trabajos de investigación. El delta de latencia es tu lectura visible sobre el salto de orquestación: cuando Ultra tarda más, ese tiempo extra es Fugu coordinando un equipo en lugar de responder en una sola pasada. La medición de tiempo por solicitud y el historial guardado de Apidog te permiten ejecutar cada variante varias veces y observar si la diferencia es estable o depende del prompt.
Para enfatizar la diferencia, elige una tarea de la propia lista de aplicaciones de Sakana donde afirma resultados sólidos: AutoInvestigación, diseño mecánico, predicción financiera de series temporales, o ajedrez de un solo tiro. Según Sakana, Fugu supera consistentemente a Gemini 3.1 Pro, Opus 4.8 y GPT 5.5 en esas aplicaciones específicas. Lee esa afirmación cuidadosamente. Fugu puede alcanzar esos resultados llamando a esos mismos modelos y sintetizando su salida, por lo que un resultado de "supera a Opus 4.8" puede ser un resultado de modelo de modelos, no una victoria de un solo modelo. Sakana también posiciona a Fugu Ultra a la par de Fable 5 y el antiguo Mythos Preview en los benchmarks de ingeniería y razonamiento, lo que es una afirmación de paridad, no una afirmación de "supera". Pruébalo tú mismo y juzga con tus propios prompts.
Enrutamiento y gobernanza de agentes que puedes sondear
La página de lanzamiento de Fugu describe mecanismos que vale la pena probar directamente. Los agentes en el pool son intercambiables. Los equipos pueden excluir agentes específicos por razones de datos o cumplimiento. Fugu también enruta dinámicamente alrededor de las restricciones del proveedor. Si tu consola expone controles de pool de agentes, puedes cambiar qué modelos son elegibles y volver a ejecutar tus solicitudes guardadas de Apidog para ver cómo cambian el enrutamiento y las respuestas.
El linaje de investigación es real y citable. Dos artículos de ICLR 2026 sustentan este enfoque: Trinity, "Un Coordinador LLM Evolucionado", un coordinador de menos de 20K parámetros optimizado por evolución sin derivadas con roles de Pensador, Trabajador y Verificador, y Conductor, "Aprendiendo a Orquestar Agentes en Lenguaje Natural", un modelo de 7B entrenado con aprendizaje por refuerzo que aprende su propia estructura de comunicación y afirma superar a Mixture-of-Agents con un costo menor. Utilizan diferentes métodos y tamaños, así que no los confundas, y ten en cuenta que mapear cualquier conteo de parámetros específico al producto enviado es una inferencia de terceros, no una cifra oficial.
Cómo esto encaja en tu flujo de trabajo de Apidog
El objetivo de probar Fugu en Apidog en lugar de un `curl` puntual es la repetibilidad. Guardas ambas solicitudes de variantes, mantienes tu clave y host en un entorno, las reproduces con nuevos prompts, comparas las respuestas lado a lado y lees la latencia y el usage sin salir de la herramienta. Cuando Fugu rota un ID de modelo o cambias de una clave de etapa a producción, cambias una variable de entorno y todas las solicitudes guardadas se actualizan. Ese es el ciclo de prueba y observación: construye una vez, luego observa cómo se comporta un sistema de orquestación a medida que le envías diferentes prompts.
Sakana toma su nombre de la palabra japonesa para pez, y la marca "banco de peces" encaja con un orquestador que coordina muchos modelos en una sola respuesta. Fugu, el pez globo, es un manjar que solo es seguro cuando un chef experimentado lo prepara. La metáfora de la preparación cuidadosa es una buena manera de pensar en el enrutamiento del trabajo entre agentes, siempre y cuando recuerdes que es color, no un punto de referencia.
Dirige tus solicitudes compatibles con OpenAI a Fugu, guarda tus variantes y deja que Apidog te muestre lo que hace el orquestador bajo carga. Descarga Apidog para configurar tu primer entorno Fugu, y comienza enviando el mismo prompt a ambas variantes para ver el salto de orquestación por ti mismo.
Preguntas Frecuentes
¿Qué URL base utilizo para probar Fugu en Apidog?
Copia la URL base de console.sakana.ai después de iniciar sesión. Sakana no ha publicado el host en ninguna página pública hasta el 22/06/2026, así que no lo adivines. Almacénala como una variable de entorno de Apidog y referénciala como {{fugu_base_url}}/chat/completions.
¿Necesito un SDK especial para llamar a Fugu?
No. Fugu ofrece un único endpoint compatible con OpenAI, por lo que cualquier cliente de OpenAI o cualquier herramienta que hable el formato de chat de OpenAI funciona con solo un cambio de URL base y clave. El mismo patrón de redirección aparece en la guía de Claude Code con OpenRouter.
¿Cómo pruebo las respuestas de streaming de Fugu?
Establece "stream": true en el cuerpo de la solicitud. La respuesta llega como text/event-stream con fragmentos data: que contienen el contenido delta incremental, terminando en data: [DONE]. Apidog renderiza el flujo SSE en vivo para que puedas ver los deltas llegar en tiempo real.
¿Cuál es la diferencia entre Fugu y Fugu Ultra?
Fugu es la variante equilibrada y de baja latencia para la codificación, revisión y chatbots cotidianos. Fugu Ultra apunta a la máxima calidad de respuesta para investigación, reproducción de documentos y análisis de seguridad. Ambas se ejecutan a través del mismo endpoint, separadas solo por el campo model, lo que las hace fáciles de guardar y comparar en Apidog.
¿Por qué Fugu Ultra es más lento que la variante equilibrada?
La latencia adicional es el salto de orquestación. Según Sakana, Fugu puede responder directamente o reunir un equipo de modelos, y Ultra se inclina hacia una coordinación más profunda para la calidad. El tiempo de respuesta más lento que lees en Apidog es tu señal visible de que Fugu coordinó múltiples modelos en lugar de responder en una sola pasada.
¿Las victorias de Fugu en los benchmarks son resultados de un solo modelo?
No. Fugu es un orquestador que llama a modelos de vanguardia de otros proveedores, incluyéndose a sí mismo recursivamente. Así que un resultado que "supera a Opus 4.8", según Sakana, puede provenir de llamar a Opus y sintetizar su salida. Trata los números de Fugu como resultados de un modelo de modelos, no como victorias de un solo modelo, y verifica con tus propios prompts.