
GLM-5.2 es uno de los modelos de pesos abiertos más capaces que puedes ejecutar ahora mismo, y la licencia MIT abierta significa que "gratis" está genuinamente sobre la mesa. El inconveniente es que "gratis" y "fácil" no son lo mismo para un modelo mezcla de expertos (MoE) de ~753B. Esta guía recorre las rutas reales, desde el autoalojamiento verdaderamente gratuito hasta los créditos de prueba casi gratuitos y el piso de pago más económico, con notas honestas sobre el hardware y los límites.
Si quieres la versión corta: si tienes el hardware (o una GPU alquilada barata), autoaloja los pesos abiertos. Si no, apóyate en los créditos de prueba de z.ai o en el nivel más económico del Plan de Codificación GLM. No hay una vía gratuita de OpenRouter para glm-5.2, así que no la busques.
El árbol de decisión rápido
Elige tu fila y salta a esa sección.
| Tu situación | Mejor ruta | Costo real |
|---|---|---|
| Posees una potente caja con GPU (o puedes alquilar una) | Autoalojar pesos abiertos (Ollama / vLLM) | $0 por los pesos; electricidad o alquiler de GPU |
| Quieres cero configuración y cero tarjeta | Créditos de prueba gratuitos de z.ai / nivel de tarifa limitada | Gratis hasta que se agoten los créditos (verifica la oferta actual) |
| Quieres la ruta de pago fiable más barata | Plan de Codificación GLM Lite, o precios de API con entrada en caché | ~$3-6/mes (verificar) o centavos por llamada |
| Quieres pagar por uso sin compromiso | API de OpenRouter | $1.40 / 1M de entrada, $4.40 / 1M de salida |
La regla general: verdaderamente gratis significa autoalojar. Casi gratis significa créditos de prueba o el plan Lite.
Ruta 1: autoalojar los pesos abiertos MIT (verdaderamente gratis)
GLM-5.2 se distribuye bajo la licencia MIT sin restricciones regionales, por lo que puedes descargar los pesos y ejecutarlos en tu propio hardware sin pagar a nadie. Los pesos se encuentran en Hugging Face en zai-org/GLM-5.2.
La parte honesta: este es un modelo MoE de ~753 mil millones de parámetros en BF16. Aunque solo una fracción de esos parámetros se activa por token, el conjunto completo de pesos debe residir en la memoria. En BF16, eso es más de un terabyte de pesos brutos. No vas a ejecutar esto en una computadora portátil. La mayoría de las personas que se autoalojan hacen una de estas dos cosas:
- Ejecutar una **compilación cuantificada** (4 bits o similar) para reducir la huella de memoria, aceptando una pequeña compensación de calidad.
- **Alquilar una instancia multi-GPU** por horas a un proveedor de la nube y apagarla cuando se termine.
Así que "gratis" aquí significa libre de costos de licencia. Todavía pagas por el hardware, la electricidad o el alquiler de la GPU. Para la mayoría de las personas, una compilación cuantificada en una estación de trabajo con gran VRAM o una sesión alquilada corta es el camino realista.
Ejecutar GLM-5.2 con Ollama
Ollama es el ejecutor local más amigable. GLM-5.2 está disponible en la biblioteca de Ollama, el flujo son dos comandos:
# Descargar el modelo (espera una descarga muy grande)
ollama pull glm-5.2:cloud
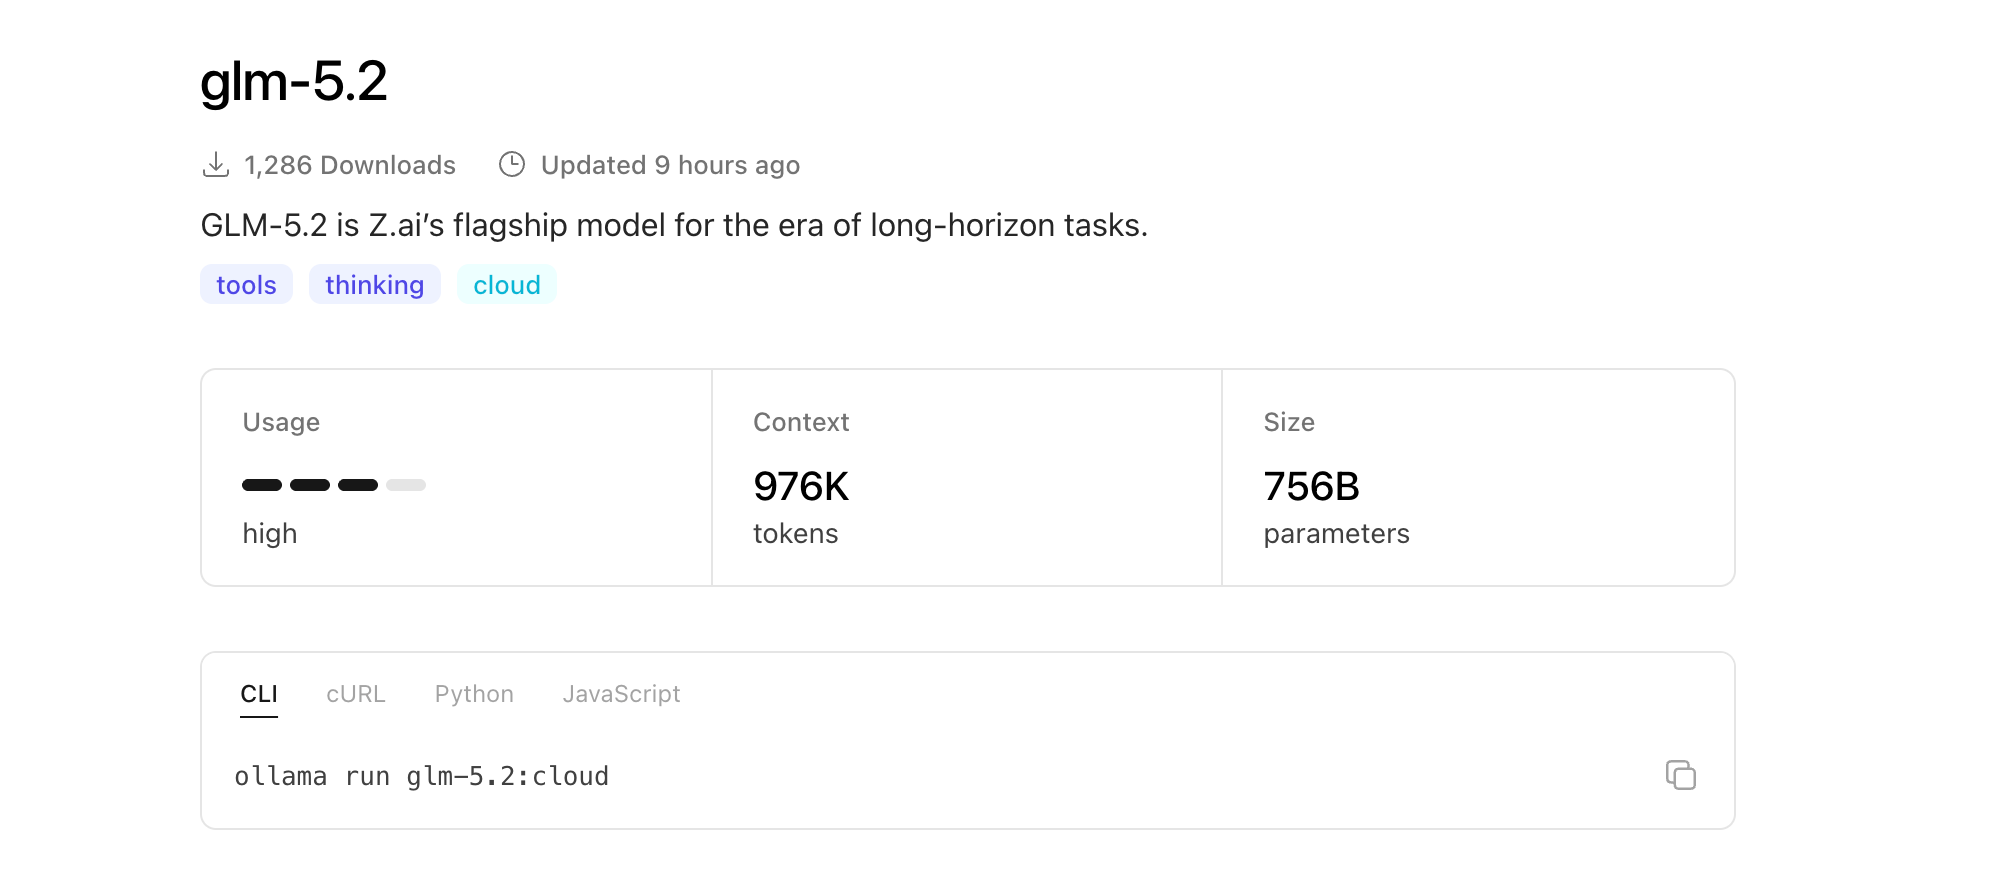
Ollama por defecto usa una variante cuantificada, que es lo que hace que un modelo de este tamaño sea siquiera concebible en hardware de consumo. También puedes acceder a él a través del punto final local compatible con OpenAI de Ollama:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.2",
    "messages": [{"role": "user", "content": "Write a Python function to parse an RFC 3339 timestamp."}]
  }'
Vigila tu RAM y VRAM. Si el modelo se desborda al disco, la generación se ralentiza drásticamente. Una compilación cuantificada más suficiente memoria unificada o una división multi-GPU es la diferencia entre utilizable e inutilizable.
Si quieres el tutorial local paso a paso, los patrones se transfieren casi exactamente de la generación anterior. Consulta ejecutar GLM-5 localmente gratis y GLM-5 gratis con Ollama para la configuración completa, las opciones de cuantificación y la resolución de problemas. Cambia la etiqueta del modelo a glm-5.2 y el flujo de trabajo es el mismo.
Ejecutar GLM-5.2 con vLLM
Para el rendimiento y para atender múltiples solicitudes, vLLM es la opción de grado de producción. Maneja el paralelismo de tensores a través de las GPU, que es la forma de realmente encajar un MoE de 753B.
pip install vllm

python -m vllm.entrypoints.openai.api_server \
  --model zai-org/GLM-5.2 \
  --tensor-parallel-size 8 \
  --max-model-len 131072
Ese --tensor-parallel-size 8 asume ocho GPU. El recuento exacto depende de tus tarjetas y de si cargas un punto de control cuantificado. vLLM expone un servidor compatible con OpenAI, por lo que cualquier cliente que hable el formato de chat-completions funciona sin cambios. El contexto de 1M de tokens (1.048.576 tokens) es la capacidad destacada, pero mantener una caché KV de un millón de tokens cuesta mucha memoria, así que establece --max-model-len a lo que realmente necesites.
Ruta 2: créditos de prueba gratuitos de z.ai y el nivel de tarifa limitada
Si el autoalojamiento está fuera de tu alcance, el camino siguiente más económico es la propia plataforma de z.ai. Las cuentas nuevas suelen obtener **créditos de prueba gratuitos** y normalmente hay un **nivel gratuito con tarifa limitada** para experimentos ligeros (a junio de 2026, verifica la oferta actual en z.ai ya que los términos de prueba cambian a menudo).
Esta es la forma más rápida de probar el modelo real con cero configuración. Creas una cuenta, obtienes una clave API y llamas al punto final compatible con OpenAI:
curl https://api.z.ai/api/paas/v4/chat/completions \
  -H "Authorization: Bearer $ZAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.2",
    "messages": [{"role": "user", "content": "Explain IndexShare sparse attention in two sentences."}],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "max"
  }'
Algunos detalles específicos de GLM-5.2 que vale la pena conocer mientras gastas esos créditos:
thinkingactiva o desactiva el razonamiento. Para codificación, z.ai recomienda el nivel de esfuerzo de pensamiento **Máximo** a través dereasoning_effort: "max". Hay dos niveles de esfuerzo, Alto y Máximo.- La longitud de salida está documentada como de hasta 128K según la documentación de z.ai, pero considérala un número para verificar en vivo en lugar de una garantía estricta, ya que las fuentes secundarias no siempre la mencionan.
Los créditos de prueba se agotan. Cuando lo hacen, pasas a un plan de pago o vuelves al autoalojamiento. Los detalles completos de los parámetros están en la guía de GLM-5.2 de z.ai.
Ruta 3: los pisos de pago más baratos (casi gratis)
Cuando los créditos gratuitos se agotan, dos caminos mantienen tus costos cerca de cero.
Plan de Codificación GLM Lite
Si tu uso principal es la codificación, el Plan de Codificación GLM es la opción de valor. El nivel de entrada **Lite cuesta aproximadamente $12/mes** (a junio de 2026, verifica los precios actuales en z.ai ya que los niveles publicados entran en conflicto entre fuentes). Por eso, obtienes acceso a la codificación con una tarifa mensual fija en lugar de tokens medidos, lo que hace que el uso diario intensivo sea predecible.
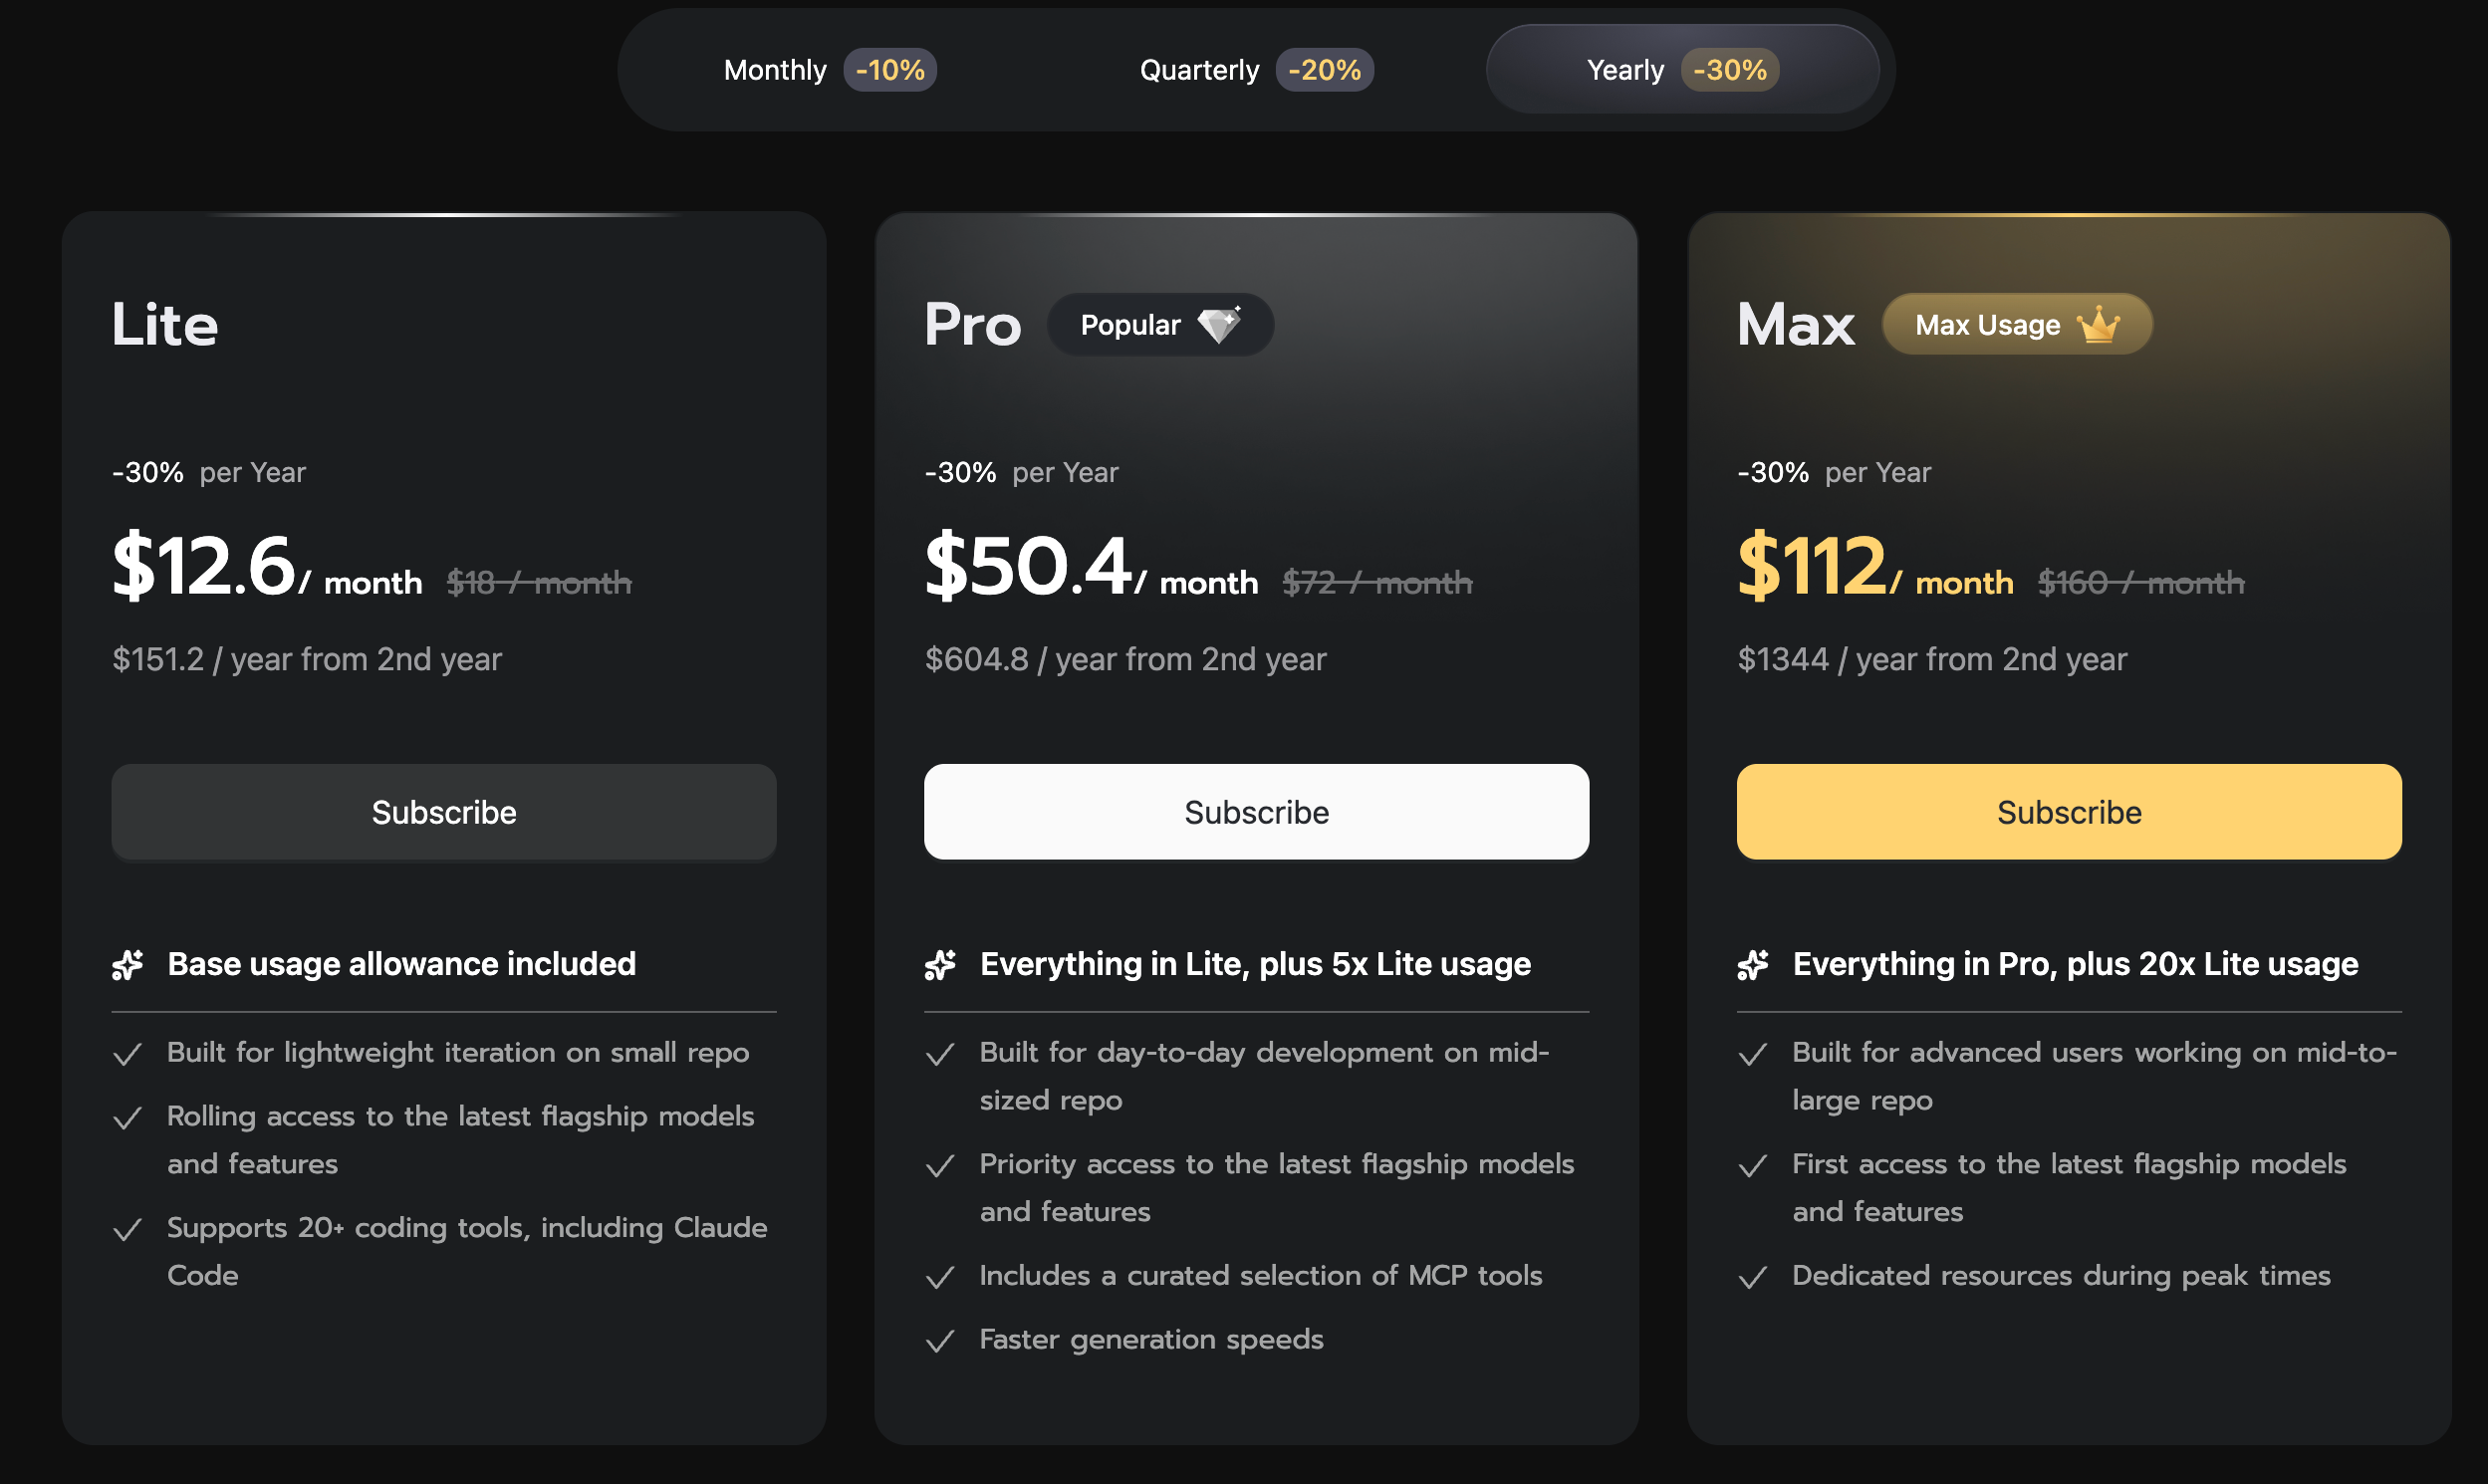
El Plan de Codificación también desbloquea la ruta compatible con Anthropic, para que puedas dirigir Claude Code, Cline o Cursor a GLM-5.2. La URL base de codificación es https://api.z.ai/api/coding/paas/v4 (algunas fuentes muestran open.z.ai/api/paas/v4, así que verifica en vivo). Un entorno de Claude Code en funcionamiento se ve así:
export ANTHROPIC_BASE_URL="https://api.z.ai/api/coding/paas/v4"
export ANTHROPIC_API_KEY="your-glm-coding-plan-key"
export ANTHROPIC_DEFAULT_SONNET_MODEL="glm-5.2[1m]"
export ANTHROPIC_DEFAULT_OPUS_MODEL="glm-5.2[1m]"
export CLAUDE_CODE_AUTO_COMPACT_WINDOW=1000000
export API_TIMEOUT_MS=3000000
El sufijo [1m] selecciona la variante de contexto de 1M. Establece API_TIMEOUT_MS alto, o Claude Code terminará las llamadas largas de contexto grande antes de que finalicen. Para el tutorial más profundo de herramientas de agente, consulta GLM-5.2 con Claude Code, Cline y Cursor y la guía de la generación anterior GLM-5.1 con Claude Code.
Precios de entrada en caché y pago por uso
Para el acceso a la API sin suscripción, la API general estándar cuesta **$1.40 por cada 1M de tokens de entrada y $4.40 por cada 1M de tokens de salida**, confirmado por OpenRouter. El mismo precio se aplica si llamas a z.ai directamente o si utilizas OpenRouter como pago por uso.
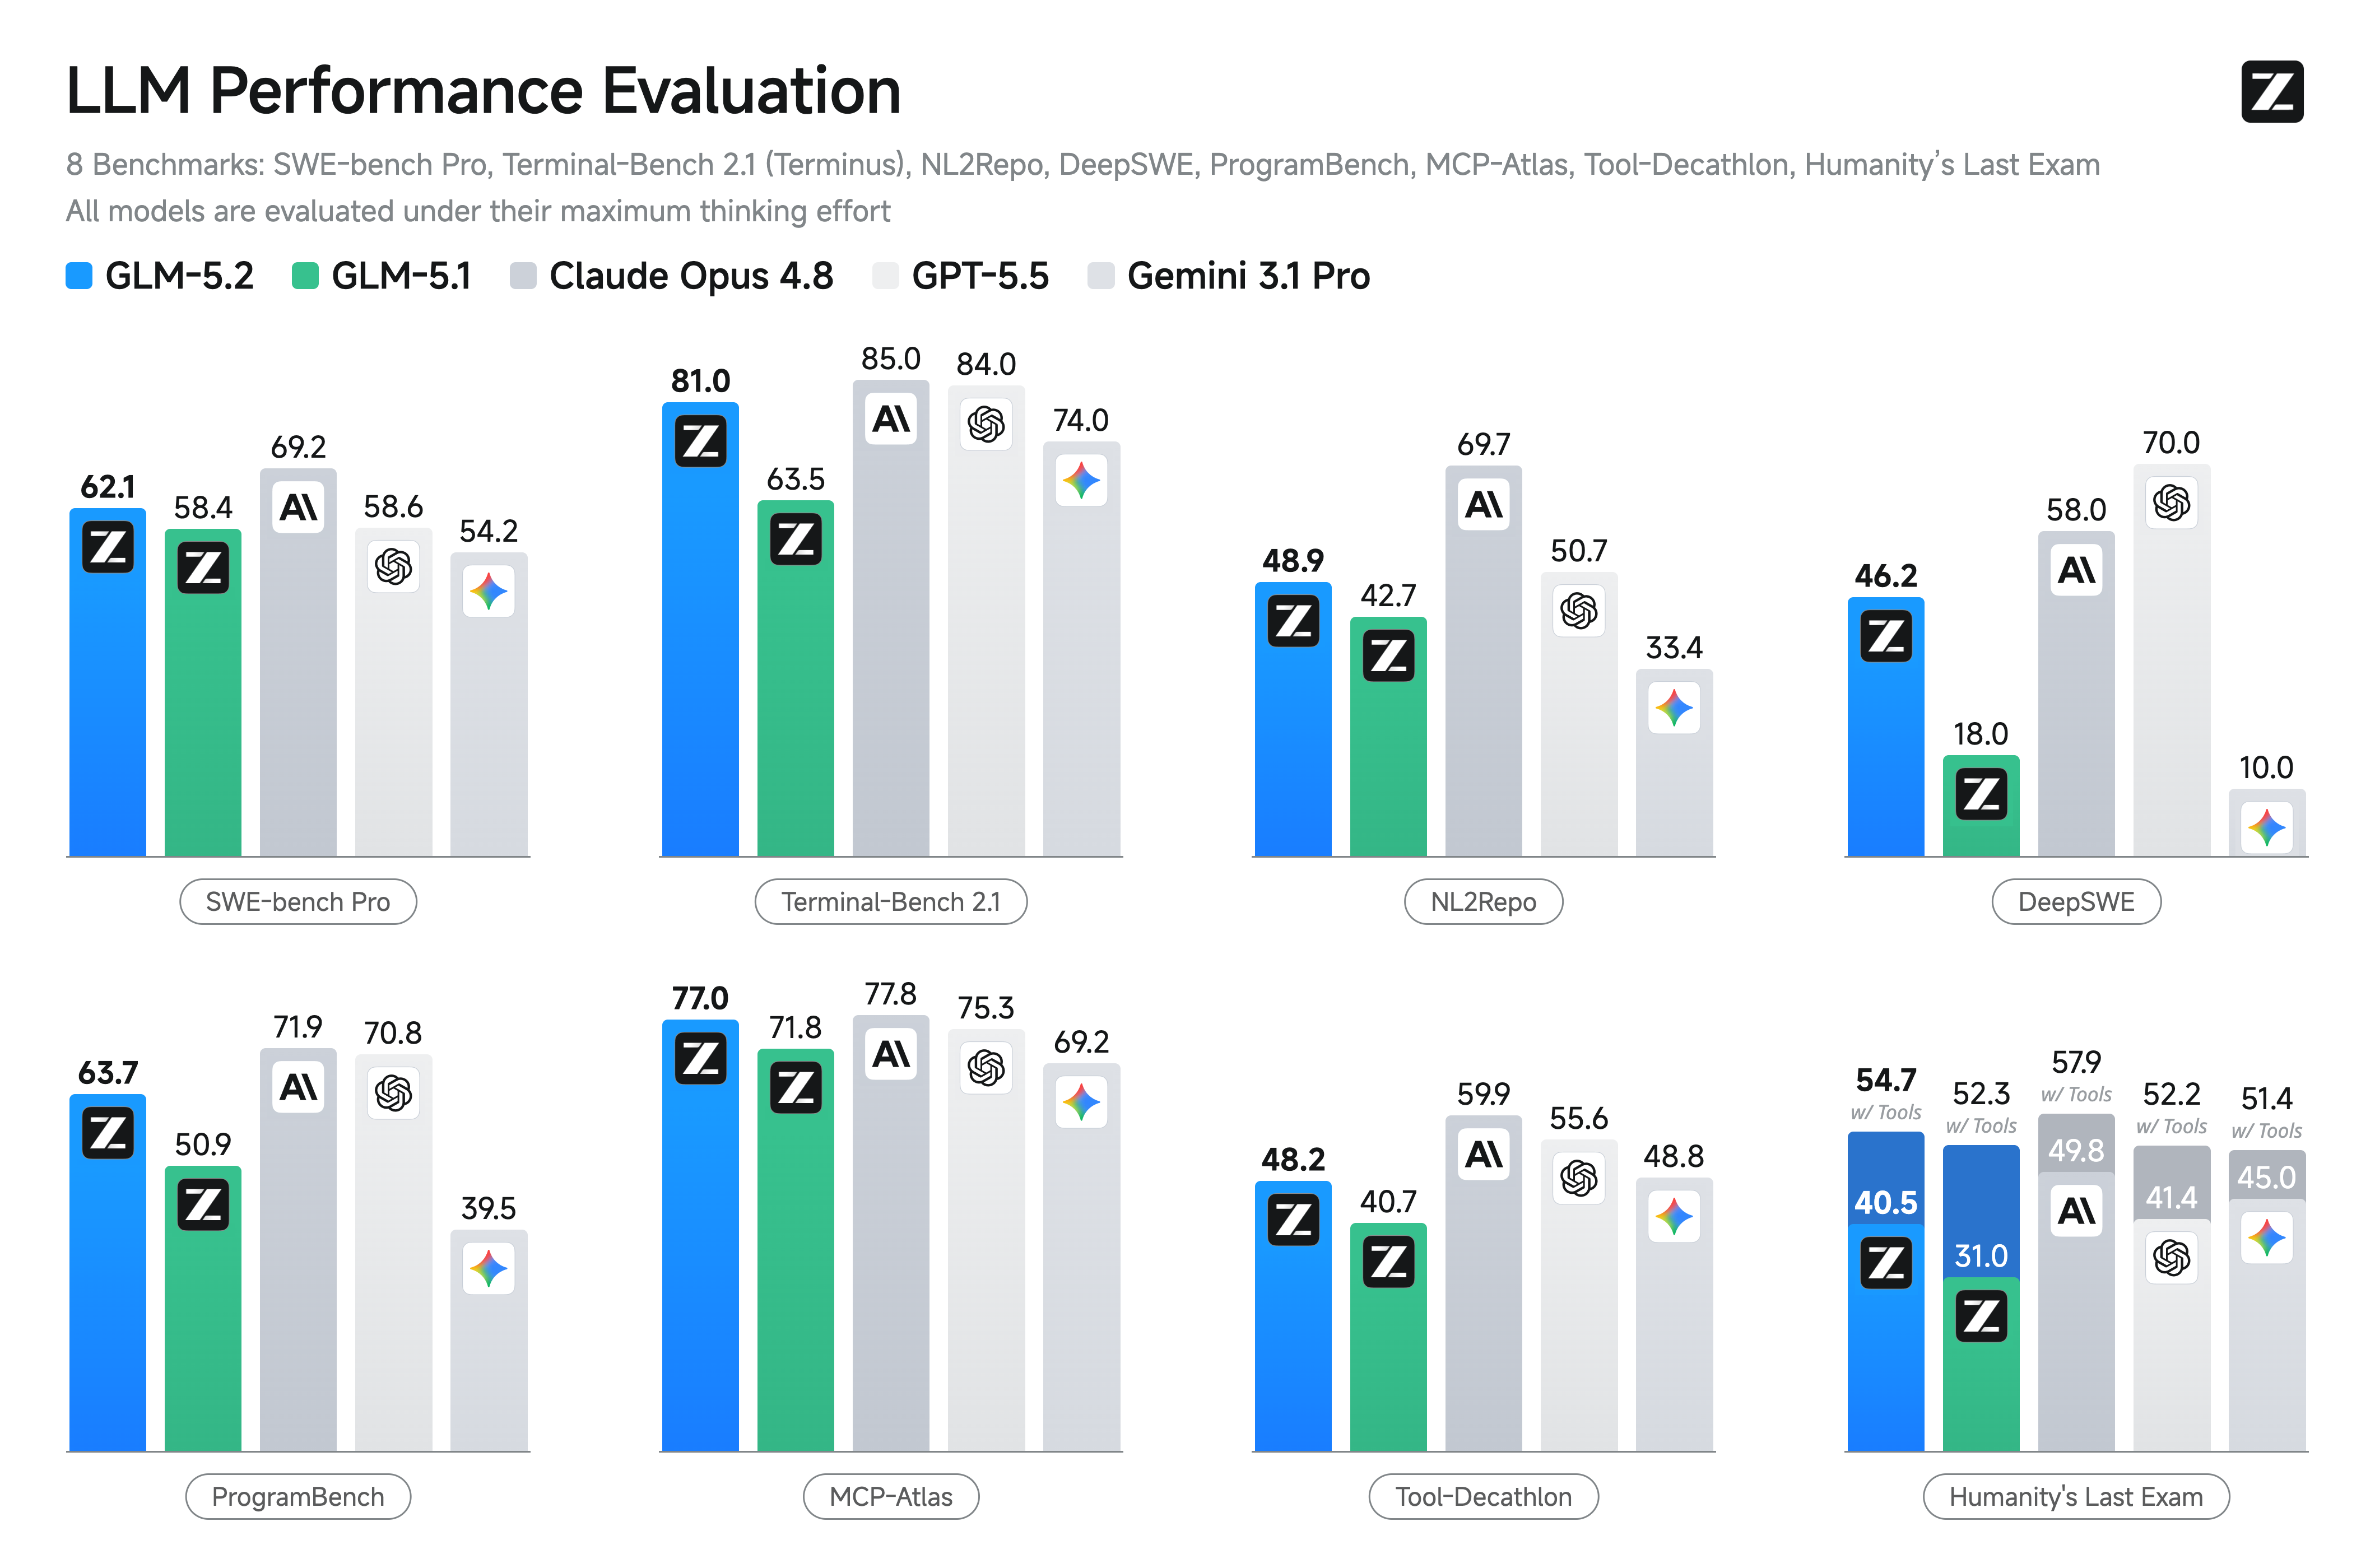
El truco casi gratuito aquí es la **entrada en caché**. Reportado en alrededor de $0.26 por cada 1M de tokens (según VentureBeat, atribuir en consecuencia), la entrada en caché reduce drásticamente el costo del contexto repetido, como un prompt de sistema largo o una base de código fija que consultas una y otra vez. Si tu carga de trabajo reutiliza el mismo prefijo, pagas el precio completo una vez y una fracción después. Para la codificación a largo plazo, VentureBeat señala que GLM-5.2 "supera a GPT-5.5 en la codificación a largo plazo con aproximadamente una sexta parte del costo", que es el argumento económico en una frase.
Una vez más, claramente: **no hay un nivel gratuito de OpenRouter para glm-5.2**. OpenRouter es barato, no gratuito. Si una guía afirma lo contrario, está equivocada.
Gratis vs. casi gratis: la comparación honesta
| Ruta | Costo inicial | Costo continuo | Esfuerzo de configuración | Mejor para |
|---|---|---|---|---|
| Autoalojar (Ollama/vLLM) | Hardware o alquiler | Electricidad / Horas de GPU | Alto | Privacidad, sin medición, control total |
| Créditos de prueba de z.ai | Ninguno | Gratis hasta que se agoten los créditos | Bajo | Primera toma de contacto, pruebas rápidas |
| Plan de Codificación GLM Lite | ~$3-6/mes (verificar) | Tarifa plana mensual | Bajo | Codificación diaria en Claude Code/Cline/Cursor |
| API + entrada en caché | Ninguno | $1.40/$4.40 por 1M; ~$0.26 en caché | Bajo | Aplicaciones, cargas de trabajo de contexto repetido |
Un patrón útil: valida tu idea con créditos de prueba y luego decide. Si lo vas a ejecutar a diario y es para codificación, adquiere el plan Lite. Si necesitas privacidad o quieres escapar por completo de la facturación por token, invierte en autoalojamiento. Si estás construyendo un producto con contexto reutilizable, la API con caché es el piso fiable más barato.
Prueba tu punto final GLM-5.2 gratuito con Apidog
Independientemente de cómo hagas funcionar GLM-5.2, ya sea gratis o de pago, querrás confirmar que el punto final funciona realmente antes de conectarlo a tu aplicación. Ya sea un servidor Ollama local, una instancia vLLM o la API en la nube de z.ai, la respuesta es una carga útil de completaciones de chat en streaming que necesitas inspeccionar.
Apidog es una plataforma API todo en uno para esto exactamente. Puedes enviar una solicitud a tu punto final GLM-5.2, ver cómo los eventos enviados por el servidor (Server-Sent Events) se renderizan en tiempo real, guardar la solicitud como un caso reutilizable y simular la respuesta para que tu frontend pueda construir sobre ella incluso antes de que el modelo esté en vivo. Dirígelo a http://localhost:11434 para Ollama o a la URL base de z.ai para la nube, establece tu encabezado Authorization, y tendrás un arnés de prueba repetible en un minuto. Descarga Apidog y tenlo junto a la ruta gratuita que elijas.
Preguntas Frecuentes
¿Es GLM-5.2 realmente gratuito? Los pesos son gratuitos bajo la licencia MIT, por lo que el autoalojamiento no cuesta nada en licencias. Aún pagas por el hardware o el alquiler de la GPU. La API alojada es de pago, aunque z.ai generalmente ofrece créditos de prueba y un nivel con tarifa limitada para empezar (verifica la oferta actual).
¿Puedo ejecutar GLM-5.2 gratis con Ollama en una computadora portátil normal? Realistamente, no. Es un modelo MoE de ~753B, e incluso una compilación cuantificada necesita mucha memoria. Ollama facilita los comandos, pero la barrera del hardware es alta. Necesitas una estación de trabajo con mucha VRAM, una Mac con gran memoria unificada o una GPU alquilada. Consulta el análisis local profundo para el tamaño.
¿Existe un nivel gratuito de OpenRouter para GLM-5.2? No. OpenRouter ofrece GLM-5.2 como pago por uso a $1.40 de entrada y $4.40 de salida por cada 1M de tokens. Es barato, no gratuito. No confíes en ninguna fuente que afirme una vía gratuita de OpenRouter.
¿Cuál es la forma de pago más barata de usar GLM-5.2 para codificación? El nivel Lite del Plan de Codificación GLM, aproximadamente $3-6/mes a junio de 2026 (verificar en z.ai). Ofrece acceso a la codificación con tarifa plana y desbloquea el punto final compatible con Anthropic para Claude Code, Cline y Cursor.
¿Cómo se compara GLM-5.2 con GPT-5.5 en cuanto a costo? Según VentureBeat, GLM-5.2 supera a GPT-5.5 en varios benchmarks de codificación a largo plazo con aproximadamente una sexta parte del costo. Para los números completos, consulta el desglose de benchmarks de GLM-5.2 y la comparación directa.
A dónde ir después
La ruta más barata depende completamente de tu hardware y de la frecuencia con la que lo ejecutarás. El autoalojamiento gana en privacidad y ausencia de medición si puedes superar la barrera de la memoria. Los créditos de prueba y el plan Lite ganan en comodidad. La API con entrada en caché gana para las aplicaciones que reutilizan el contexto.
Si todavía estás decidiendo si GLM-5.2 es el modelo adecuado, empieza por qué es GLM-5.2 y cómo se compara con GLM-5.1. Cuando estés listo para construir sobre él, la guía de la API de GLM-5.2 y el desglose de precios cubren el resto, y Apidog se encarga de las pruebas intermedias.