
GLM-5.2 ist eines der leistungsfähigsten Open-Weights-Modelle, das Sie derzeit ausführen können, und die offene MIT-Lizenz bedeutet, dass „kostenlos“ tatsächlich zur Debatte steht. Der Haken ist, dass „kostenlos“ und „einfach“ für ein ~753B Mixture-of-Experts-Modell nicht dasselbe sind. Dieser Leitfaden zeigt die echten Wege auf, vom wirklich kostenlosen Selbst-Hosting bis hin zu nahezu kostenlosen Testguthaben und dem günstigsten bezahlten Mindestpreis, mit ehrlichen Anmerkungen zu Hardware und Grenzen.
Wenn Sie die Kurzversion wünschen: Wenn Sie die Hardware haben (oder eine günstige gemietete GPU), hosten Sie die offenen Gewichte selbst. Wenn nicht, nutzen Sie z.ai-Testguthaben oder die günstigste Stufe des GLM Coding Plan. Es gibt keine kostenlose OpenRouter-Spur für glm-5.2, suchen Sie also nicht danach.
Der schnelle Entscheidungsbaum
Wählen Sie Ihre Zeile und springen Sie zu diesem Abschnitt.
| Ihre Situation | Beste Route | Echte Kosten |
|---|---|---|
| Sie besitzen einen leistungsstarken GPU-Rechner (oder können einen mieten) | Selbst-Hosten offener Gewichte (Ollama / vLLM) | 0 $ für Gewichte; Strom oder GPU-Miete |
| Sie möchten keine Einrichtung und keine Karte | z.ai kostenlose Testguthaben / ratenbegrenzte Stufe | Kostenlos, bis die Guthaben aufgebraucht sind (aktuelles Angebot prüfen) |
| Sie möchten den günstigsten zuverlässigen kostenpflichtigen Weg | GLM Coding Plan Lite oder Preise für zwischengespeicherte Eingaben (API) | ~3-6 $/Monat (prüfen) oder wenige Cents pro Aufruf |
| Sie möchten Pay-as-you-go ohne Verpflichtung | OpenRouter API | 1,40 $ / 1 Mio. Eingaben, 4,40 $ / 1 Mio. Ausgaben |
Die Faustregel: Wirklich kostenlos bedeutet selbst hosten. Nahezu kostenlos bedeutet Testguthaben oder der Lite-Plan.
Route 1: Die offenen MIT-Gewichte selbst hosten (wirklich kostenlos)
GLM-5.2 wird unter der MIT-Lizenz ohne regionale Beschränkungen ausgeliefert, sodass Sie die Gewichte herunterladen und auf Ihrer eigenen Hardware ausführen können, ohne jemanden zu bezahlen. Die Gewichte befinden sich auf Hugging Face unter zai-org/GLM-5.2.
Der ehrliche Teil: Dies ist ein ~753B-Parameter-MoE-Modell in BF16. Auch wenn pro Token nur ein Bruchteil dieser Parameter aktiviert wird, muss der vollständige Gewichtsdatensatz immer noch im Speicher liegen. In BF16 ist das weit über ein Terabyte an Rohgewichten. Sie werden dies nicht auf einem Laptop ausführen. Die meisten Leute, die selbst hosten, tun eines von zwei Dingen:
- Führen Sie einen quantisierten Build (4-Bit oder ähnlich) aus, um den Speicherbedarf zu verringern, wobei ein kleiner Qualitätskompromiss in Kauf genommen wird.
- Mieten Sie eine Multi-GPU-Instanz stundenweise bei einem Cloud-Anbieter und fahren Sie sie herunter, wenn Sie fertig sind.
„Kostenlos“ bedeutet hier also kostenfrei bezüglich der Lizenzkosten. Sie zahlen immer noch für Hardware, Strom oder GPU-Miete. Für die meisten Einzelpersonen ist ein quantisierter Build auf einer Workstation mit viel VRAM oder eine kurze gemietete Sitzung der realistische Weg.
GLM-5.2 mit Ollama ausführen
Ollama ist der benutzerfreundlichste lokale Runner. GLM-5.2 ist in der Ollama-Bibliothek verfügbar, der Ablauf besteht aus zwei Befehlen:
# Pull the model (expect a very large download)
ollama pull glm-5.2:cloud
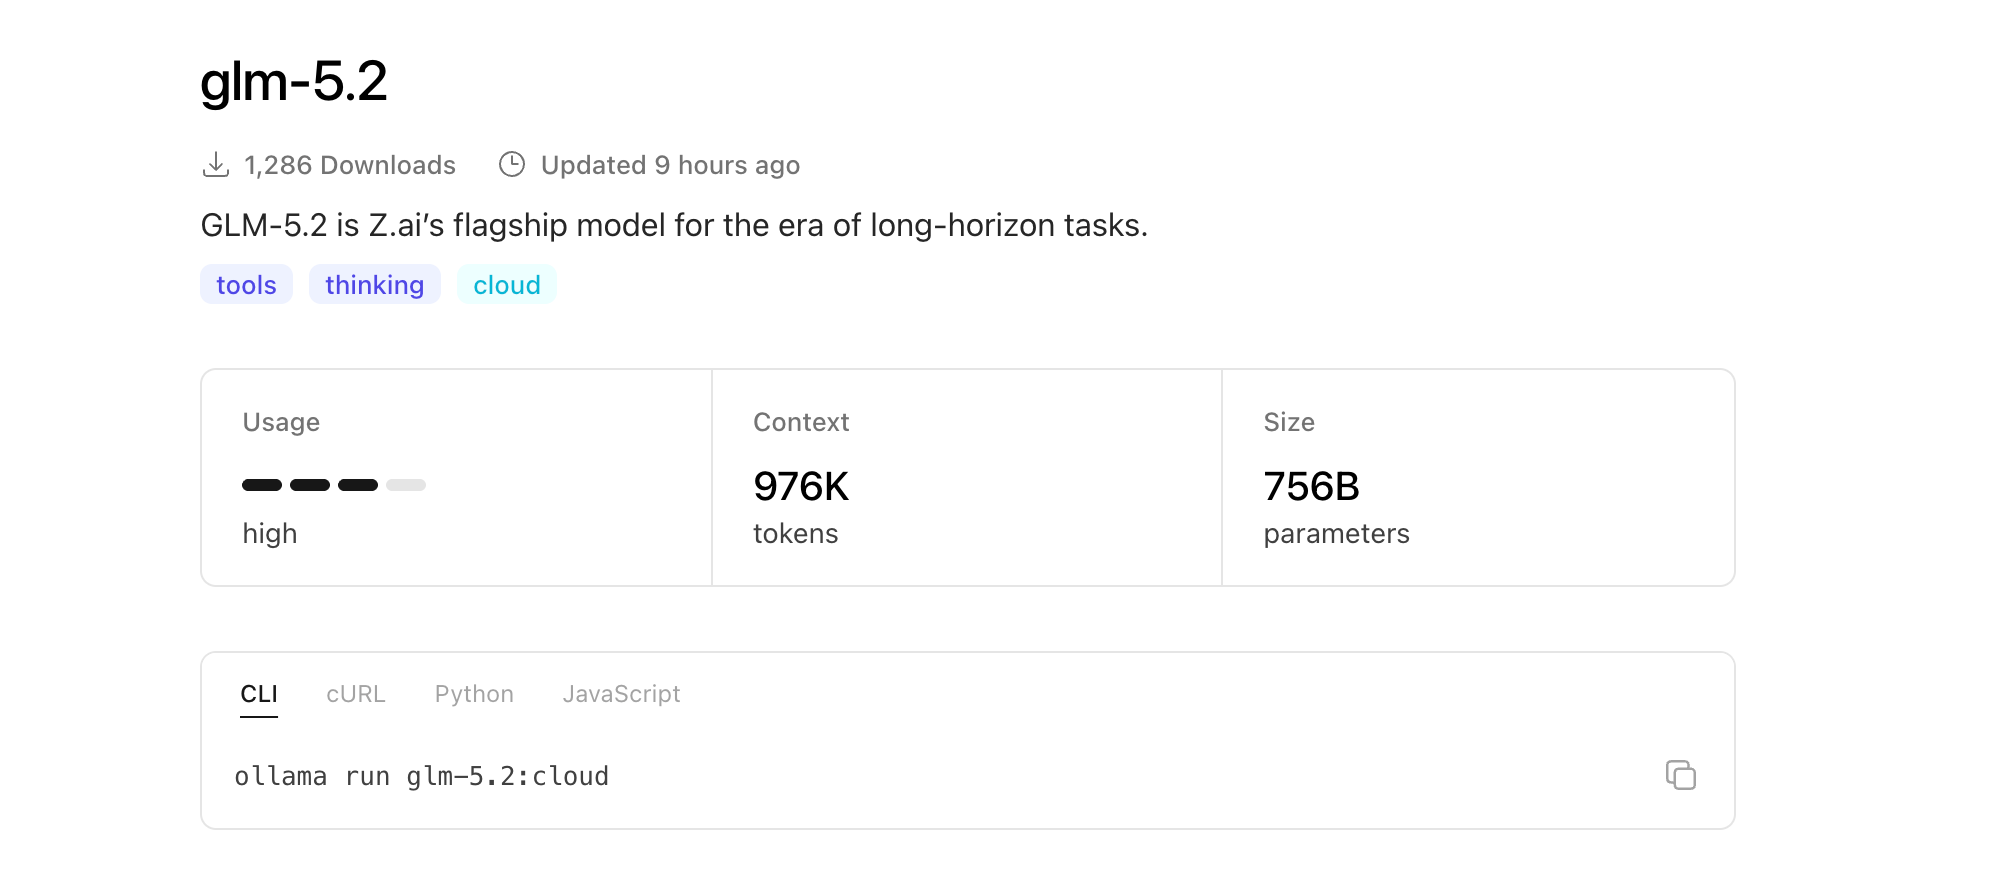
Ollama verwendet standardmäßig eine quantisierte Variante, was ein Modell dieser Größe überhaupt auf Consumer-ähnlicher Hardware denkbar macht. Sie können es auch über Ollamas lokalen OpenAI-kompatiblen Endpunkt ansprechen:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.2",
    "messages": [{"role": "user", "content": "Write a Python function to parse an RFC 3339 timestamp."}]
  }'
Achten Sie auf Ihren RAM und VRAM. Wenn das Modell auf die Festplatte ausgelagert wird, verlangsamt sich die Generierung auf ein Schneckentempo. Ein quantisierter Build plus ausreichend vereinheitlichter Speicher oder eine Multi-GPU-Aufteilung macht den Unterschied zwischen nutzbar und unbrauchbar aus.
Wenn Sie die Schritt-für-Schritt-Anleitung für die lokale Ausführung wünschen, übertragen sich die Muster fast exakt von der vorherigen Generation. Siehe GLM-5 kostenlos lokal ausführen und GLM-5 kostenlos mit Ollama für die vollständige Einrichtung, Quantisierungsoptionen und Fehlerbehebung. Tauschen Sie das Modell-Tag gegen glm-5.2 aus und der Workflow ist derselbe.
GLM-5.2 mit vLLM ausführen
Für Durchsatz und die Bearbeitung mehrerer Anfragen ist vLLM die produktionsreife Option. Es handhabt die Tensor-Parallelisierung über GPUs hinweg, wodurch Sie ein 753B MoE tatsächlich unterbringen können.
pip install vllm

python -m vllm.entrypoints.openai.api_server \
  --model zai-org/GLM-5.2 \
  --tensor-parallel-size 8 \
  --max-model-len 131072
Das --tensor-parallel-size 8 geht von acht GPUs aus. Die genaue Anzahl hängt von Ihren Karten ab und davon, ob Sie einen quantisierten Checkpoint laden. vLLM stellt einen OpenAI-kompatiblen Server bereit, sodass jeder Client, der das Chat-Completions-Format spricht, ohne Änderungen funktioniert. Der 1M-Token-Kontext (1.048.576 Tokens) ist die herausragende Funktion, aber das Halten eines Millionen-Token-KV-Cache kostet viel Speicher, also setzen Sie --max-model-len auf das, was Sie tatsächlich benötigen.
Route 2: z.ai kostenlose Testguthaben und der ratenbegrenzte Tarif
Wenn Selbst-Hosting unerreichbar ist, ist der nächstgünstigste Weg die eigene Plattform von z.ai. Neue Konten erhalten typischerweise kostenlose Testguthaben und es gibt normalerweise einen ratenbegrenzten kostenlosen Tarif für leichte Experimente (Stand Juni 2026, überprüfen Sie das aktuelle Angebot auf z.ai, da sich die Testbedingungen häufig ändern).
Dies ist der schnellste Weg, das echte Modell ohne Einrichtung auszuprobieren. Sie erstellen ein Konto, holen sich einen API-Schlüssel und rufen den OpenAI-kompatiblen Endpunkt auf:
curl https://api.z.ai/api/paas/v4/chat/completions \
  -H "Authorization: Bearer $ZAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.2",
    "messages": [{"role": "user", "content": "Explain IndexShare sparse attention in two sentences."}],
    "thinking": {"type": "enabled"},
    "reasoning_effort": "max"
  }'
Ein paar GLM-5.2-Besonderheiten, die Sie kennen sollten, während Sie diese Guthaben ausgeben:
thinkingschaltet die Argumentation ein oder aus. Für die Codierung empfiehlt z.ai die maximale Argumentationsstufe überreasoning_effort: "max". Es gibt zwei Anstrengungsstufen, High und Max.- Die Ausgabelänge ist laut z.ai-Dokumentation mit bis zu 128K dokumentiert, aber behandeln Sie dies eher als eine Zahl, die live überprüft werden muss, denn als harte Garantie, da sekundäre Quellen dies nicht immer auflisten.
Testguthaben laufen ab. Wenn das passiert, wechseln Sie entweder zu einem kostenpflichtigen Plan oder kehren zum Selbst-Hosting zurück. Alle Parameterdetails finden Sie im z.ai GLM-5.2 Leitfaden.
Route 3: Die günstigsten kostenpflichtigen Mindestpreise (nahezu kostenlos)
Wenn die kostenlosen Guthaben aufgebraucht sind, halten zwei Wege Ihre Kosten nahezu bei Null.
GLM Coding Plan Lite
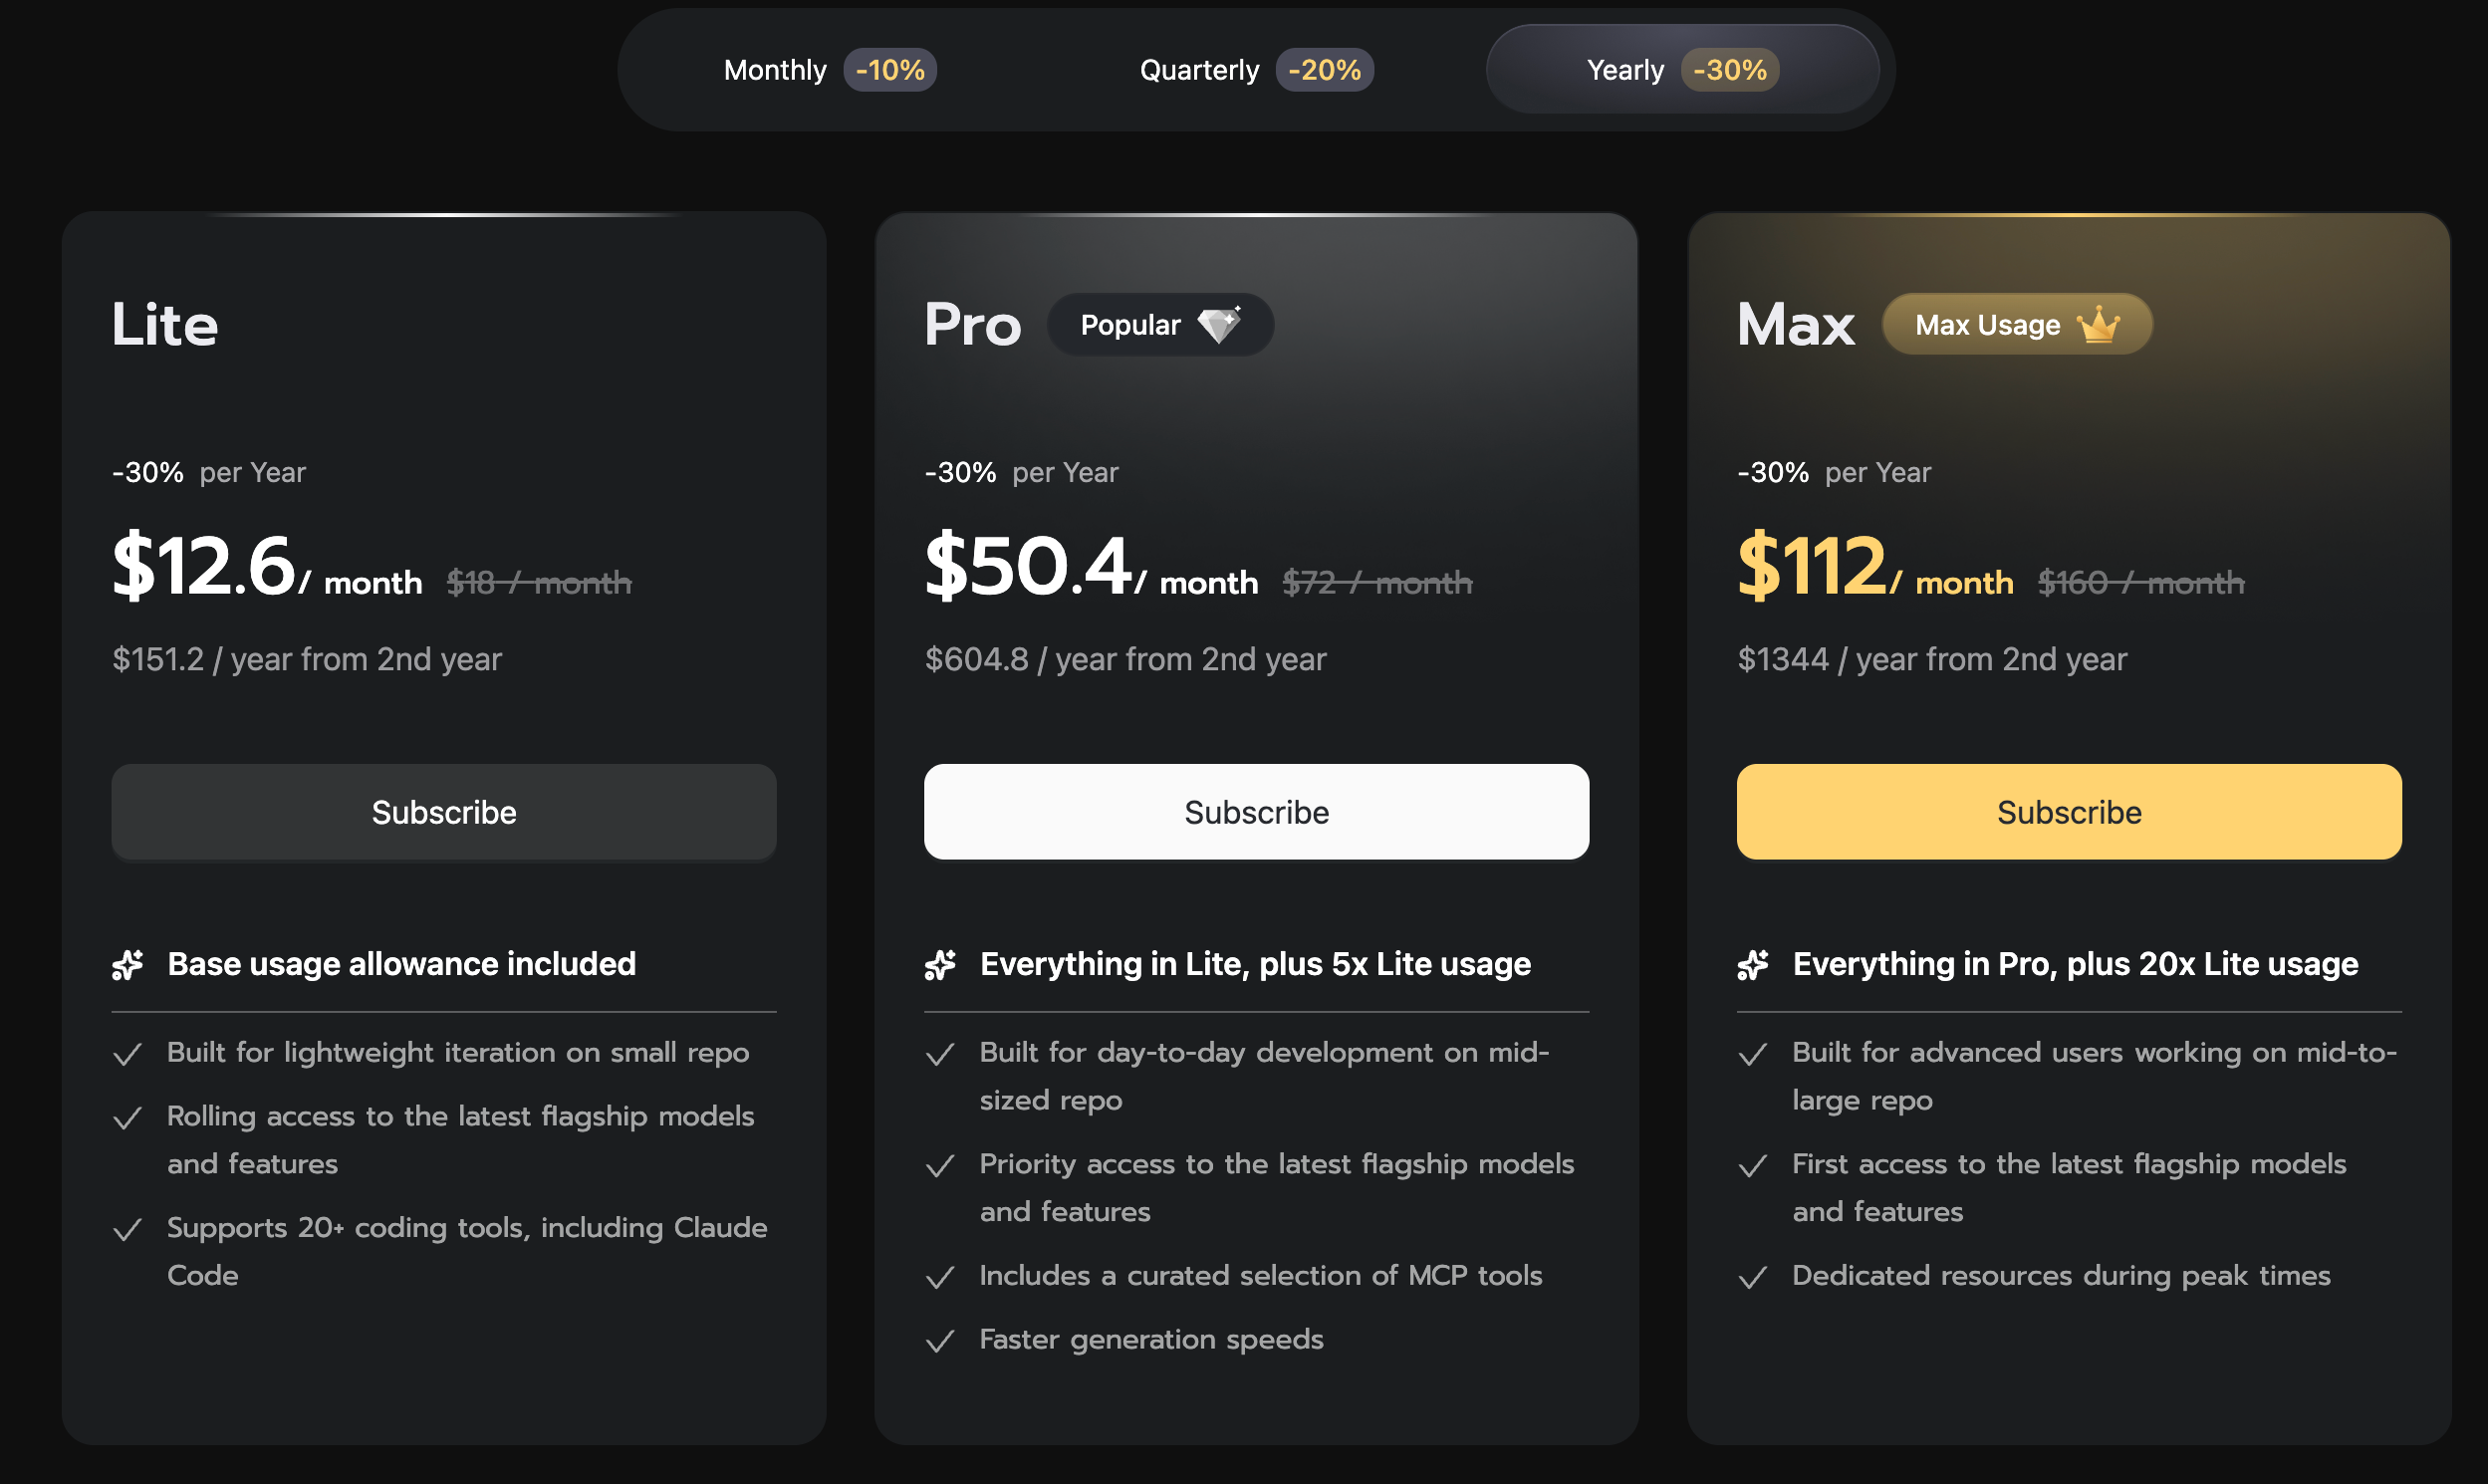
Wenn Ihre Hauptanwendung die Codierung ist, ist der GLM Coding Plan die preiswerte Wahl. Die Einstiegsstufe Lite kostet ungefähr 12 $/Monat (Stand Juni 2026, überprüfen Sie die aktuellen Preise auf z.ai, da die veröffentlichten Tarife in verschiedenen Quellen voneinander abweichen). Dafür erhalten Sie Codierungszugriff zu einem monatlichen Festpreis anstelle von getakteten Tokens, was eine intensive tägliche Nutzung vorhersehbar macht.
Der Coding Plan schaltet auch den Anthropic-kompatiblen Pfad frei, sodass Sie Claude Code, Cline oder Cursor auf GLM-5.2 richten können. Die Coding-Basis-URL ist https://api.z.ai/api/coding/paas/v4 (einige Quellen zeigen open.z.ai/api/paas/v4, also live überprüfen). Eine funktionierende Claude Code-Umgebung sieht so aus:
export ANTHROPIC_BASE_URL="https://api.z.ai/api/coding/paas/v4"
export ANTHROPIC_API_KEY="your-glm-coding-plan-key"
export ANTHROPIC_DEFAULT_SONNET_MODEL="glm-5.2[1m]"
export ANTHROPIC_DEFAULT_OPUS_MODEL="glm-5.2[1m]"
export CLAUDE_CODE_AUTO_COMPACT_WINDOW=1000000
export API_TIMEOUT_MS=3000000
Das Suffix [1m] wählt die 1M-Kontextvariante aus. Setzen Sie API_TIMEOUT_MS hoch, da Claude Code sonst lange Aufrufe mit großem Kontext abbricht, bevor sie beendet sind. Für die ausführlichere Anleitung zur Agenten-Tooling siehe GLM-5.2 mit Claude Code, Cline und Cursor und den Leitfaden der vorherigen Generation GLM-5.1 mit Claude Code.
Preise für zwischengespeicherte Eingaben und Pay-as-you-go
Für den API-Zugriff ohne Abonnement kostet die Standard-API 1,40 $ pro 1 Mio. Eingabe-Tokens und 4,40 $ pro 1 Mio. Ausgabe-Tokens, bestätigt von OpenRouter. Die gleichen Preise gelten, ob Sie z.ai direkt anrufen oder über OpenRouter als Pay-as-you-go abrechnen.
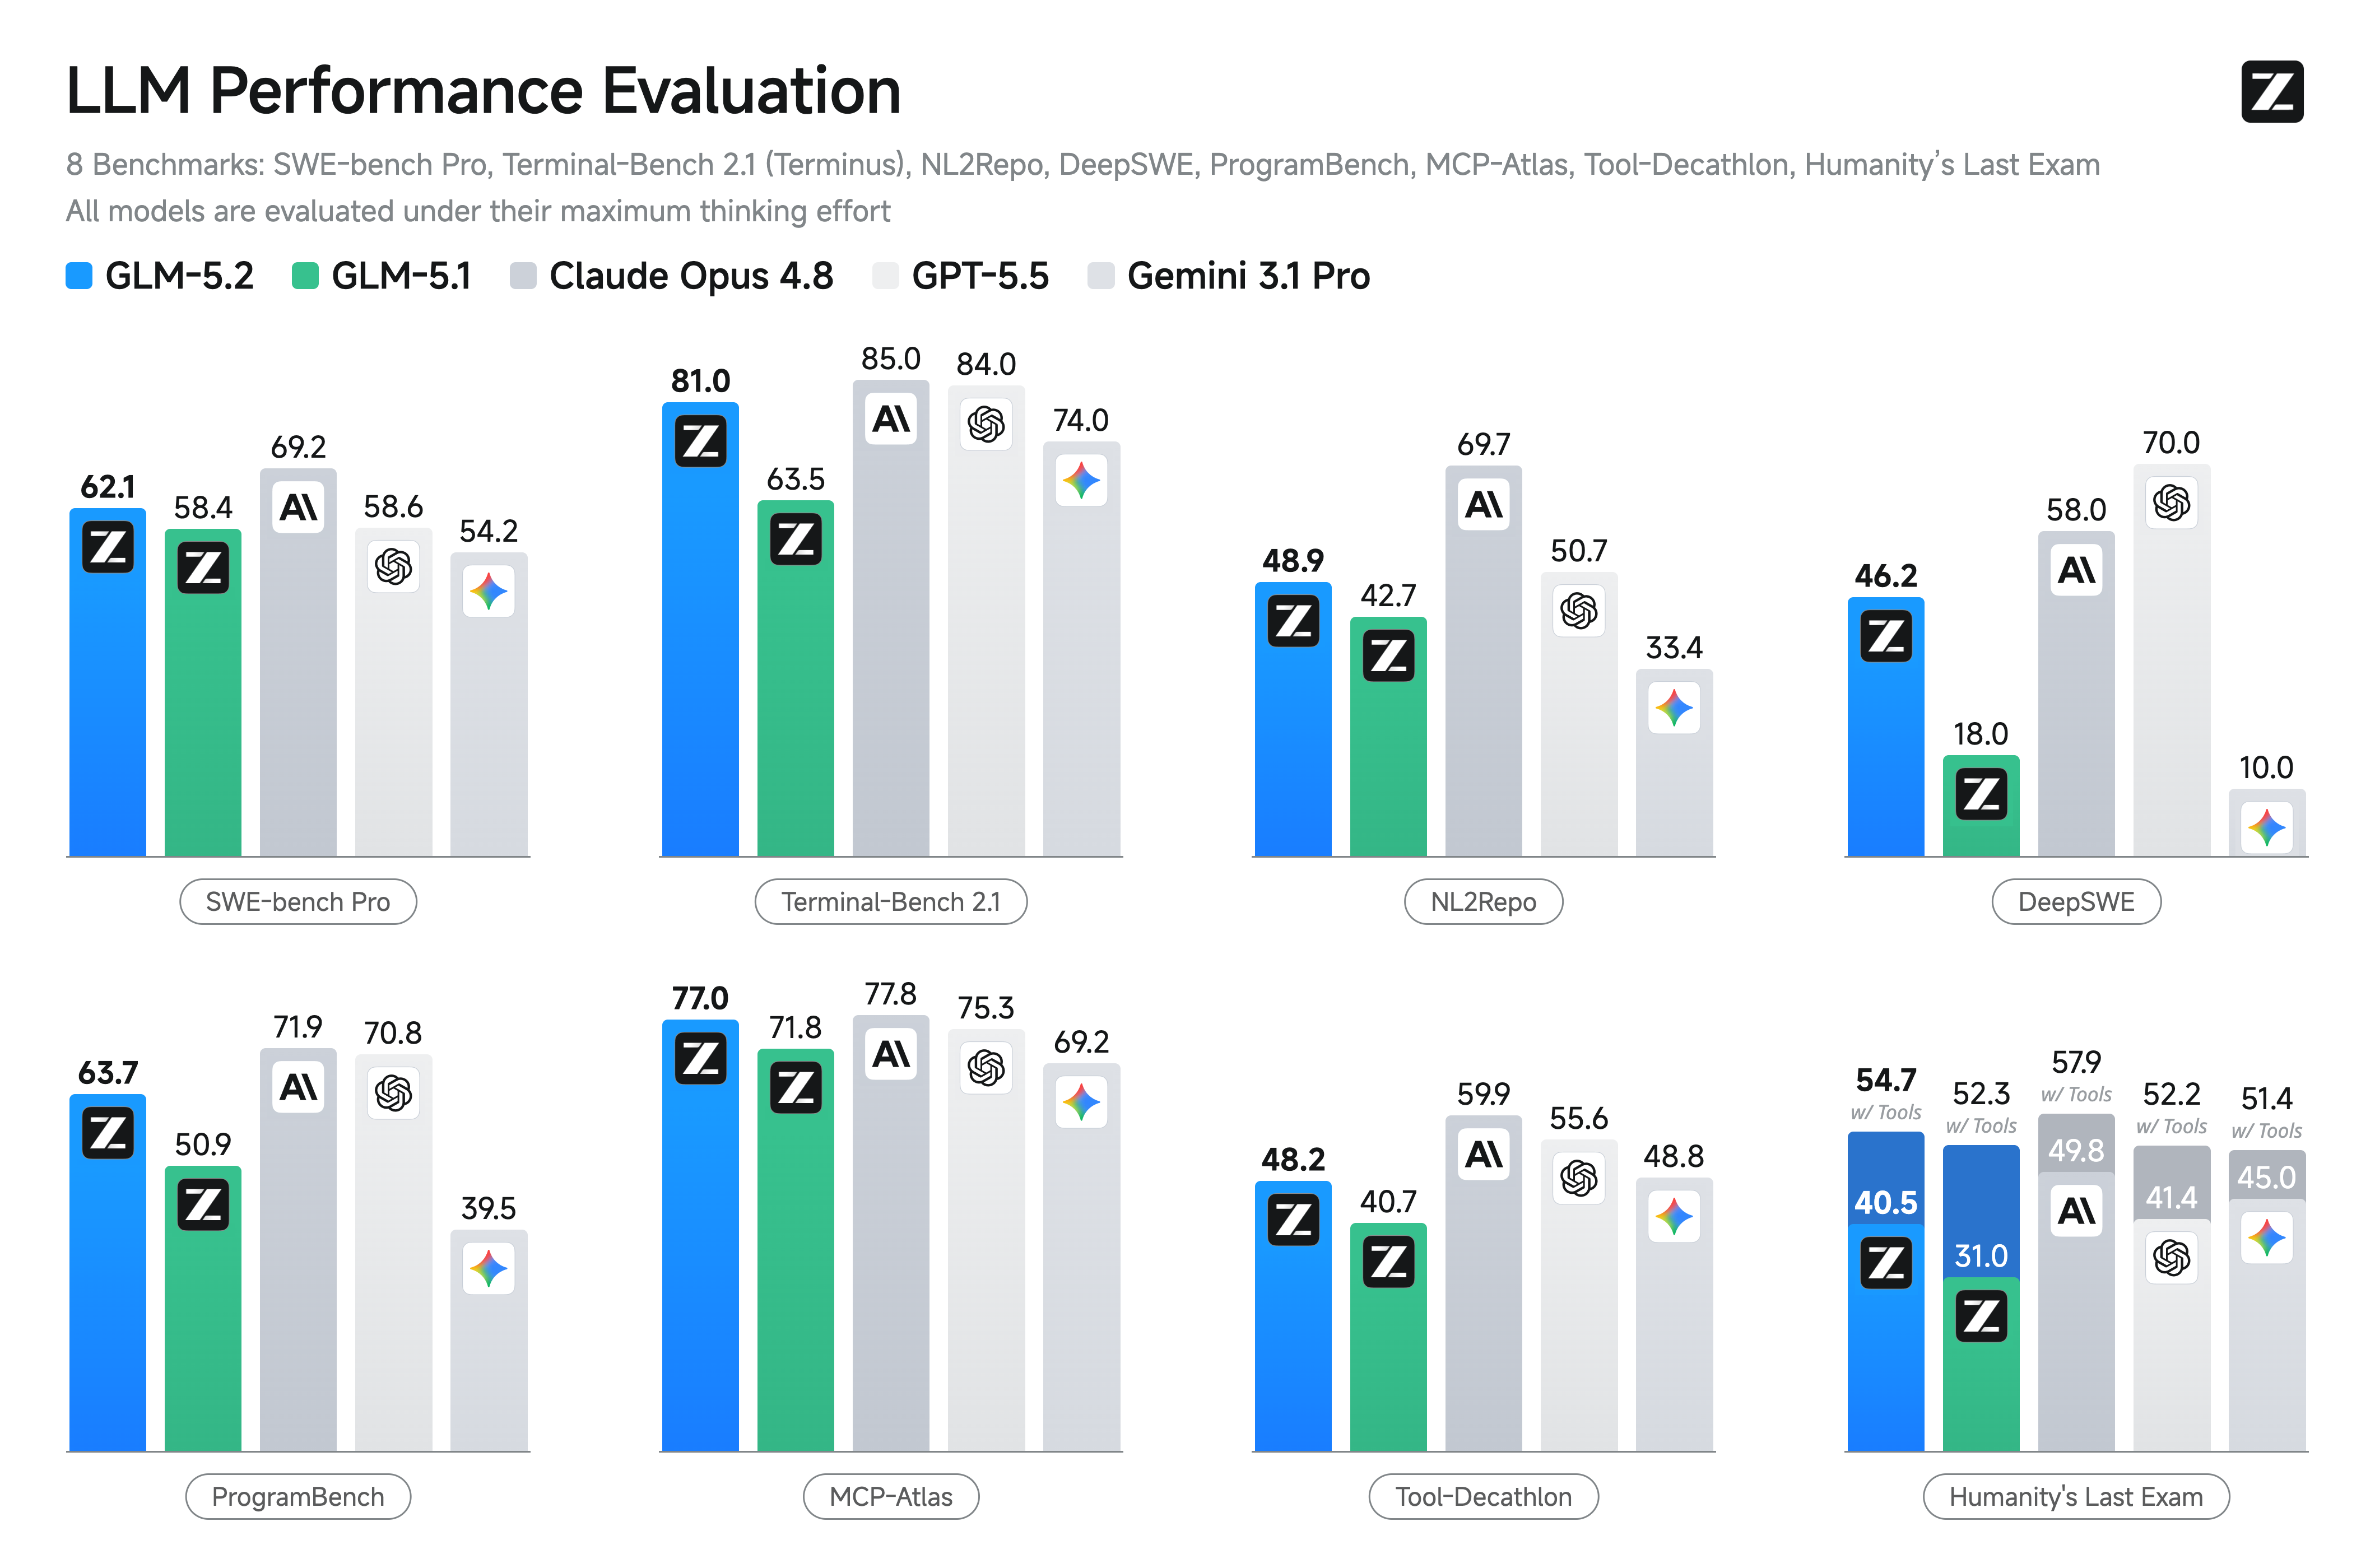
Der Trick hier, um es nahezu kostenlos zu halten, ist die zwischengespeicherte Eingabe. Berichten zufolge kostet sie etwa 0,26 $ pro 1 Mio. Tokens (laut VentureBeat, entsprechend zuordnen), wodurch die Kosten für wiederholten Kontext, wie einen langen System-Prompt oder eine feste Codebasis, die Sie immer wieder abfragen, drastisch gesenkt werden. Wenn Ihre Arbeitslast dasselbe Präfix wiederverwendet, zahlen Sie einmal den vollen Preis und danach einen Bruchteil. Für langfristige Codierung bemerkt VentureBeat, dass GLM-5.2 „GPT-5.5 bei langfristiger Codierung zu etwa einem Sechstel der Kosten schlägt“, was das ökonomische Argument in einem Satz zusammenfasst.
Noch einmal deutlich: Es gibt keinen kostenlosen OpenRouter-Tarif für glm-5.2. OpenRouter ist günstig, nicht kostenlos. Wenn ein Leitfaden etwas anderes behauptet, ist das falsch.
Kostenlos vs. Nahezu kostenlos: Der ehrliche Vergleich
| Route | Anschaffungskosten | Laufende Kosten | Einrichtungsaufwand | Am besten für |
|---|---|---|---|---|
| Selbst-Host (Ollama/vLLM) | Hardware oder Miete | Strom / GPU-Stunden | Hoch | Datenschutz, keine Abrechnung, volle Kontrolle |
| z.ai Testguthaben | Keine | Kostenlos bis Guthaben aufgebraucht | Niedrig | Erster Eindruck, schnelle Tests |
| GLM Coding Plan Lite | ~3-6 $/Monat (prüfen) | Monatliche Pauschale | Niedrig | Tägliche Codierung in Claude Code/Cline/Cursor |
| API + zwischengespeicherte Eingabe | Keine | 1,40 $/4,40 $ pro 1 Mio.; ~0,26 $ zwischengespeichert | Niedrig | Anwendungen, Arbeitslasten mit wiederholtem Kontext |
Ein nützliches Muster: Validieren Sie Ihre Idee mit Testguthaben, dann entscheiden Sie. Wenn Sie es täglich ausführen und es sich um Codierung handelt, wählen Sie den Lite-Plan. Wenn Sie Privatsphäre benötigen oder die Token-basierte Abrechnung ganz vermeiden möchten, investieren Sie in Selbst-Hosting. Wenn Sie ein Produkt mit wiederverwendbarem Kontext entwickeln, ist die API mit Caching der günstigste zuverlässige Boden.
Testen Sie Ihren kostenlosen GLM-5.2 Endpunkt mit Apidog
Egal wie Sie GLM-5.2 zum Laufen bringen, ob kostenlos oder kostenpflichtig, Sie sollten den Endpunkt überprüfen, ob er tatsächlich funktioniert, bevor Sie ihn in Ihre App integrieren. Ob es sich um einen lokalen Ollama-Server, eine vLLM-Instanz oder die z.ai Cloud-API handelt, die Antwort ist eine Streaming-Chat-Completions-Payload, die Sie inspizieren müssen.
Apidog ist eine All-in-One-API-Plattform genau dafür. Sie können eine Anfrage an Ihren GLM-5.2-Endpunkt senden, die gestreamten Server-Sent Events in Echtzeit rendern sehen, die Anfrage als wiederverwendbaren Fall speichern und die Antwort simulieren, damit Ihr Frontend darauf aufbauen kann, noch bevor das Modell live ist. Richten Sie es für Ollama auf http://localhost:11434 oder für die Cloud auf die z.ai-Basis-URL, setzen Sie Ihren Authorization-Header, und Sie haben in einer Minute ein wiederholbares Test-Harness. Laden Sie Apidog herunter und behalten Sie es neben der kostenlosen Route, die Sie wählen.
FAQ
Ist GLM-5.2 tatsächlich kostenlos nutzbar? Die Gewichte sind unter der MIT-Lizenz kostenlos, daher fallen für das Selbst-Hosting keine Lizenzkosten an. Sie zahlen jedoch weiterhin für Hardware oder die GPU-Miete. Die gehostete API ist kostenpflichtig, obwohl z.ai in der Regel Testguthaben und einen ratenbegrenzten Tarif zum Start anbietet (überprüfen Sie das aktuelle Angebot).
Kann ich GLM-5.2 kostenlos mit Ollama auf einem normalen Laptop ausführen? Realistisch gesehen, nein. Es ist ein ~753B MoE-Modell, und selbst ein quantisierter Build benötigt ernsthaften Speicher. Ollama macht die Befehle einfach, aber die Hardware-Anforderungen sind hoch. Eine Workstation mit viel VRAM, ein Mac mit großem einheitlichem Speicher oder eine gemietete GPU sind das, was Sie brauchen. Siehe das lokale Deep-Dive für die Größenbestimmung.
Gibt es einen kostenlosen OpenRouter-Tarif für GLM-5.2? Nein. OpenRouter bietet GLM-5.2 als Pay-as-you-go für 1,40 $ Eingabe und 4,40 $ Ausgabe pro 1 Million Tokens an. Es ist günstig, nicht kostenlos. Vertrauen Sie keiner Quelle, die einen kostenlosen OpenRouter-Zugang behauptet.
Was ist der günstigste kostenpflichtige Weg, GLM-5.2 für die Codierung zu nutzen? Der GLM Coding Plan Lite-Tarif, grob 3-6 $/Monat (Stand Juni 2026, überprüfen Sie auf z.ai). Er bietet pauschalen Codierungszugang und schaltet den Anthropic-kompatiblen Endpunkt für Claude Code, Cline und Cursor frei.
Wie schneidet GLM-5.2 im Kostenvergleich mit GPT-5.5 ab? Laut VentureBeat schlägt GLM-5.2 GPT-5.5 bei mehreren Long-Horizon-Codierungs-Benchmarks zu etwa einem Sechstel der Kosten. Die vollständigen Zahlen finden Sie in der Aufschlüsselung der GLM-5.2 Benchmarks und dem direkten Vergleich.
Wo geht es weiter
Die günstigste Route hängt ganz von Ihrer Hardware und davon ab, wie oft Sie sie ausführen werden. Selbst-Hosting gewinnt bei Datenschutz und null Abrechnung, wenn Sie die Speicheranforderungen erfüllen können. Testguthaben und der Lite-Plan gewinnen bei Komfort. Die API mit zwischengespeicherter Eingabe gewinnt für Anwendungen, die Kontext wiederverwenden.
Wenn Sie noch entscheiden, ob GLM-5.2 überhaupt das richtige Modell ist, beginnen Sie mit was GLM-5.2 ist und wie es sich von GLM-5.1 unterscheidet. Wenn Sie bereit sind, darauf aufzubauen, decken der GLM-5.2 API-Leitfaden und die Preisübersicht den Rest ab, und Apidog übernimmt die Tests dazwischen.